

Dive into LLMs: geführte Praxisübungen zum Erlernen großer Sprachmodelle
Lordog/dive-into-llms · 55.245★ · 6.588 forks
Alles Wissenswerte über Lordog/dive-into-llms: ein kostenloser, überwiegend chinesischsprachiger Kurs, der Themen rund um große Sprachmodelle in Notizen, Notebooks und reproduzierbare Übungen verwandelt.
Was Dive into LLMs ist
Dive into LLMs ist eine Reihe praxisorientierter Programmier-Tutorials über große Sprachmodelle. Das Repository bündelt Folien, kapitelweise Leitfäden und Jupyter-Notebooks; das erklärte Ziel ist eine Einstiegsreferenz durch einfache Praxisübungen für Studierende, die Kursarbeiten oder Forschungsprojekte vorbereiten.
Das Material stammt aus den Kursen der Shanghai Jiao Tong University über Sprachverarbeitungstechnologien und KI-Sicherheit. Das README beschreibt es als kostenlos und öffentlich; es ist keine Bibliothek zum Installieren als Paket und kein vortrainiertes Modell.
Der Ursprung: von Universitätsnotizen zum offenen Kurs
Das Repository wurde am 8. April 2024 erstellt. Sein Eigentümer, Tongxin Yuan (Lordog), stellt sich auf GitHub als Masterstudent mit Fokus auf Modellsicherheit und agentische KI vor, verbunden mit der Shanghai Jiao Tong University.
Die Autorenschaft ist kollektiv. Das README würdigt ein Team von Lehrenden und Studierenden der Shanghai Jiao Tong University sowie Mitwirkende der National University of Singapore. Darunter ist Zhuosheng Zhang, als Lehrender der Ursprungskurse aufgeführt.
Das Update vom 6. Juni 2025 erweiterte den Kurs um Themen zu mathematischem Denken, GUI-Agenten, Alignment und Steganografie. Es kündigte außerdem einen begleitenden Kurs an, erstellt gemeinsam mit Huaweis Ascend-Community, über den vollständigen Entwicklungszyklus großer Sprachmodelle mit Material, Laborhandbüchern und Video.
Philosophie und Prinzipien
Der Ansatz bevorzugt Praxis gegenüber einer rein konzeptionellen Einführung:
- Schrittweiser Einstieg: Jedes Thema verknüpft Erklärung, Folien und ausführbaren Code.
- Lernen durch Verändern: Das erste Kapitel unterscheidet eine entkoppelte, anpassbare Version von einer stärker integrierten, damit Einsteiger Datenladen, Architektur und Metriken ändern können.
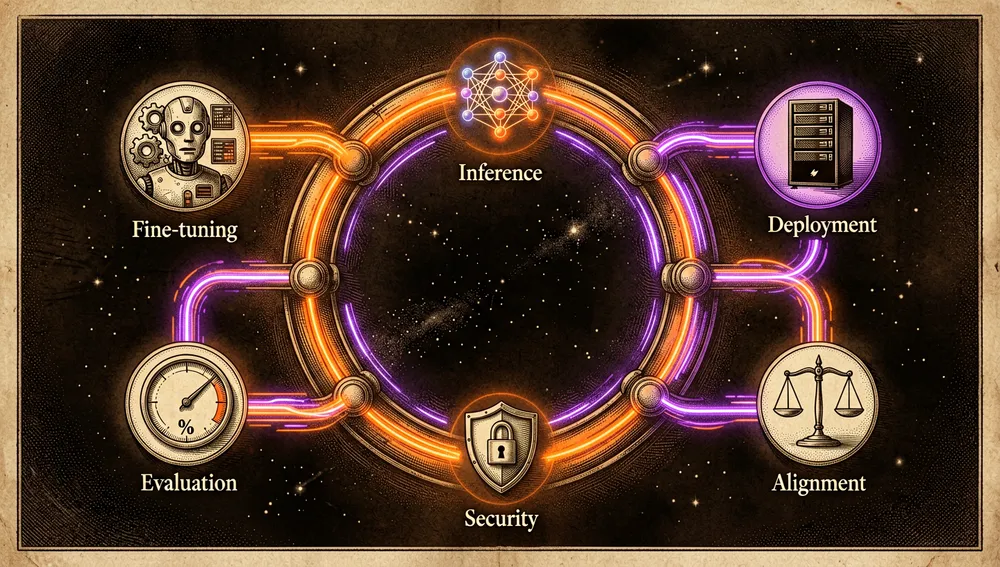
- Abdeckung des gesamten Lebenszyklus: Es kombiniert Feinabstimmung, Inferenz, Bereitstellung, Evaluierung, Sicherheit und Alignment, statt sich auf den Konsum einer API zu beschränken.
- Offener Zugang: Der Kurs präsentiert sich als kostenlos und akzeptiert Issues und Pull Requests als Verbesserungsmechanismen.
Er beansprucht nicht, akademische Ausbildung zu ersetzen oder Ergebnisse zu garantieren: Der Hinweis des Repositorys warnt, dass Inhalte aus Erfahrungen von Mitwirkenden, öffentlichen Daten und Forschungsarbeit stammen und die Techniken nur als Referenz dienen.
Wie es funktioniert
Die Lerneinheit ist ein Kapitel unter documents/: Jedes bietet üblicherweise ein PDF, ein README und ein Notebook. Das Hauptverzeichnis deckt Feinabstimmung und Bereitstellung ab; Prompt Engineering und Chain-of-Thought-Reasoning; Wissensbearbeitung; mathematisches Denken; Wasserzeichen; Jailbreak-Angriffe; Steganografie; multimodale Modelle; GUI-Agenten; Agentensicherheit; und Alignment mittels bestärkendem Lernen aus menschlichem Feedback.
Das erste Kapitel arbeitet mit Transformers, Feinabstimmung und Inferenz und schlägt vor, Demos mit Gradio Spaces bereitzustellen. Das Kapitel zu mathematischem Denken nutzt überwachte Feinabstimmung, um Antworten von DeepSeek-R1 über den DeepMath-103K-Datensatz und das Modell Qwen2.5-Math-1.5B zu destillieren; das Notebook führt durch Herunterladen und Aufbereiten der Daten, Training, Generierung und Evaluierung.
Das Kapitel zu GUI-Agenten nutzt Qwen2-VL-7B, den OS-Kairos-Datensatz und LLaMA-Factory für eine Übung zur überwachten Feinabstimmung. Das Alignment-Kapitel veranschaulicht PPO mit GPT-2, einem BERT-Klassifikator als Belohnung und IMDB-Daten.
Offizieller und halboffizieller Status
Es wurde kein Beleg dafür gefunden, dass das Repository in einen offiziellen Marktplatz für Plugins, SDKs oder Erweiterungen aufgenommen wurde. Sein überprüfbarer Status ist der von offenem, auf GitHub gepflegtem Lehrmaterial.
Die Zusammenarbeit mit Huaweis Ascend-Community ist im pädagogischen Sinne halboffiziell: Das README kündigt einen gemeinsamen Kurs an und verlinkt Ascends Lernseite. Das belegt Unterstützung und Verbreitung des Begleitkurses, aber keine Huawei-Zertifizierung sämtlicher Inhalte des Repositorys und keinen Industriestandard.
Das Ökosystem
Material und Repositories des Autors
Die Suche in den öffentlichen Repositories von Lordog förderte drei weitere Projekte zutage: Lordog/R-Judge, einen Benchmark zur Bewertung des Sicherheitsrisikobewusstseins von Agenten; Lordog/agent-guardrail; und einen Fork von OpenDevin. Nur R-Judge hat einen klaren thematischen Bezug zur Agentensicherheit; es wird in den Quellen nicht als Abhängigkeit von Dive into LLMs dargestellt.
Der Kurs verlinkt außerdem externe Ressourcen für konkrete Übungen: Transformers und Gradio Spaces im Kapitel zur Feinabstimmung, sowie Huaweis Ascend-Kurs für die Erweiterung zur vollständigen Entwicklung.
Forks, Übersetzungen und Community-Erweiterungen
Die Suche nach exaktem Namen und die Fork-Liste identifizierten eine englische Übersetzung, hhprojects/dive-into-llms-en, deren Beschreibung explizit erklärt, dass sie Lordog/dive-into-llms übersetzt; sie hatte zum Zeitpunkt der Abfrage 17 Sterne. Ebenfalls gefunden wurde N1j1k4/llms-, mit einer Beschreibung, die es als vom Kurs abgeleitete Studiennotizen identifiziert, mit 7 Sternen.
Unter den sichtbarsten Forks beschreibt sich cooelf/dive-into-llms als Anfänger-Tutorial und hatte 27 Sterne. Die übrigen geprüften Forks behielten die Beschreibung des Originals bei oder dokumentierten keine eigenständige Anpassung; sie werden daher als Forks eingestuft, nicht als unabhängige Ports.
Es gibt einen Vorschlag für eine türkische Übersetzung in Issue 41 mit einem zugehörigen Pull Request, aber es wurde keine gemergte türkische Übersetzung im Hauptbranch gefunden.
Zahlen des Repositorys
Messung: 9. August 2026, GitHub-API.
| Metrik | Wert |
|---|---|
| Sterne | 48.524 |
| Forks | 5.811 |
| Abonnenten | 299 |
| Von der API gemeldete offene Issues | 14 |
| Hauptsprache | Jupyter Notebook |
| Lizenz | Von der API nicht angegeben |
| Erstellung | 8. April 2024 |
| Letztes Release | v1, 12. Juni 2025 |
| Letzter Code-Push | 10. Oktober 2025 |
Die nach Beitragszahl führenden Contributor waren Lordog (31), cooelf (15), zwhe99 (8) und dongdongzhaoUP (6). Die API gab updated_at mit 10. August 2026 zurück, ein Datum nach dem Tag dieser Messung; das wird als Metadaten-Anomalie übernommen, ohne künftige Aktivität abzuleiten.
open_issues_count kann offene Pull Requests einschließen. Zudem spiegelt watchers_count in der allgemeinen Antwort die Sternzahl wider; deshalb verwendet die Tabelle subscribers_count für die tatsächlichen Abonnenten.
Wie man beiträgt
Weder eine CONTRIBUTING.md, eine Pull-Request-Vorlage noch eine detaillierte Branching-Richtlinie wurde im Root-Verzeichnis oder unter .github/ gefunden. Das README erklärt jedoch, dass das Projekt fortlaufend ist, lädt zu Issues und Pull Requests ein und würdigt seine Mitwirkenden.
In der Praxis sollte ein überprüfbarer Beitrag von einem Fork ausgehen, das jeweilige Kapitel ändern und einen Pull Request eröffnen; die abgerufene Liste der Pull Requests umfasst Pfadkorrekturen, Abhängigkeitskompatibilität und eine Vorschau einer türkischen Übersetzung. Das ist eine Beschreibung des üblichen GitHub-Ablaufs, gestützt durch bestehende Pull Requests, keine formale, vom Projekt veröffentlichte Beitragsanleitung.
Wie die Community reagierte
Das stärkste Resonanzsignal ist die Akzeptanz auf GitHub: 48.524 Sterne und 5.811 Forks bei der aktuellen Messung. Issues zeigen konkrete Bedürfnisse derer, die versuchen, das Material auszuführen: nicht mehr funktionierende Download-Links, MPS-Inkompatibilität unter macOS, ein Versionskonflikt zwischen fixierten trl- und transformers-Versionen, Fragen zu Laborhandbüchern und eine Bitte um türkische Übersetzung.
Es wurde kein überprüfbarer direkter Thread über dieses Repository auf Hacker News gefunden. Die Suche nach „dive-into-llms” liefert Beiträge über das Video von Andrej Karpathy und andere gleichnamige Inhalte, nicht über Lordog/dive-into-llms; dessen 582 Punkte und 46 Kommentare sollten nicht dem Kurs zugeschrieben werden.
Reddit blockierte die automatisierte Suche mit einer 403-Antwort; X verlangte eine Anmeldung und Product Hunt lieferte 403. Es wird daher keine Abwesenheit von Beiträgen auf diesen Plattformen behauptet, sondern nur, dass keine auffindbare Evidenz gewonnen wurde. Die YouTube-Suche lieferte eine Ergebnisseite, erlaubte jedoch nicht, ein Video einzeln zu verifizieren, dessen Titel oder Beschreibung dieses Repository nannte; Titel und Aufrufzahlen werden ausgelassen. Auch auf Dev.to, Hashnode, in Blogs, veröffentlichten Paketen oder Podcasts wurden keine überprüfbaren Artikel speziell über den Kurs gefunden.
Dive into LLMs im Vergleich zu anderen Ansätzen
| Ansatz | Nachweisbare Überschneidung | Nachweisbarer Unterschied |
|---|---|---|
hhprojects/dive-into-llms-en | Erklärt sich selbst als englische Übersetzung dieses Kurses. | Es ist eine separate Community-Übersetzung, nicht der Hauptbranch. |
| Ascends Kurs zur Entwicklung von Sprachmodellen | Teilt den praxisorientierten Ausbildungsansatz, und das README präsentiert ihn als gemeinsame Erweiterung. | Verbreitung und Materialien sind in Ascends Community gehostet; es wurde kein Beleg gefunden, dass er die Notebooks dieses Repositorys ersetzt. |
Lordog/R-Judge | Teilt mit einigen Kapiteln den Fokus auf Agentensicherheit. | Die Beschreibung des Repositorys definiert es als Risikobewertungs-Benchmark, während Dive into LLMs ein Kurs mit mehreren Themen ist. |
Es werden keine Leistungsvergleiche einbezogen: Die gefundenen Quellen liefern keine gemeinsame Bewertung zwischen diesen Ansätzen.
Kurzanleitung zur Nutzung
Installation und erster Start
- Das Repository klonen und hineinwechseln:
git clone https://github.com/Lordog/dive-into-llms.git
cd dive-into-llms- Für das erste Kapitel schlägt der Leitfaden vor, eine Conda-Umgebung mit Python 3.9 zu erstellen und zu aktivieren und Transformers zu installieren:
conda create -n llm python=3.9
conda activate llm
pip install transformers
Danach weist das Material an, die Dateien aus dem Textklassifikations-Beispiel von Transformers herunterzuladen und pip install -r requirements.txt auszuführen; falls GPU benötigt wird, empfiehlt es, PyTorch mit conda install pytorch zu installieren, da ein heimischer Spiegel eine reine CPU-Version installieren kann.
- Das README eines Kapitels öffnen und dessen Notebook ausführen. Zum Beispiel für mathematisches Denken:
jupyter notebook sft_math.ipynbDas Notebook führt durch Datendownload, Laden und Training, Generierung und Evaluierung.
Übliche Arbeitsabläufe
- Einen Klassifikator feinabstimmen und bereitstellen:
documents/chapter1/README.mdbefolgen, vom Textklassifikations-Beispiel ausgehen und die Daten-, Modell- und Metrikmodule der entkoppelten Version anpassen. - Prompting und Chain-of-Thought-Reasoning testen: Kapitel 2 öffnen, einen API-Schlüssel eines dokumentierten Anbieters besorgen und den Beispielaufruf mit dem im Kapitel selbst genannten Modell ausführen.
- Mathematisches Denken destillieren:
documents/chapter4/sft_math.ipynböffnen; das erwartete Ergebnis umfasst Trainings-Checkpoints und Generierungsergebnisse. - Das PPO-Alignment-Beispiel reproduzieren: das Notebook von Kapitel 11 öffnen, die dort bereitgestellten Modelle und den Datensatz mit den
huggingface-cli download-Befehlen herunterladen und das GPT-2-Experiment mit Stimmungsbelohnung ausführen.
Wesentliche Konfiguration
documents/chapter1/README.md: Leitfaden zur Vorbereitung der Umgebung und Wahl der entkoppelten oder integrierten Variante.documents/chapter4/sft_math.ipynb: Notebook für das Experiment zu mathematischem Denken.HF_ENDPOINT: Kapitel 11 setzt dies aufhttps://hf-mirror.com, bevorhuggingface-cli downloadverwendet wird; dient als Download-Spiegel.CUDA_VISIBLE_DEVICES: Das RLHF-Notebook zeigt diese Einstellung als Beispiel zur GPU-Auswahl.- Lokale Pfade für Daten, Modelle und Checkpoints: Die Trainingskapitel erfordern deren Festlegung entsprechend der eigenen Ausstattung; Kapitel 4 verlangt mindestens 50 GB Speicherplatz und eine GPU mit mindestens 40 GB Grafikspeicher.
Häufige Fallstricke und Lösungen
- PyTorch ohne GPU-Beschleunigung: Der Leitfaden warnt, dass ein Paket-Spiegel eine reine CPU-Version installieren kann;
conda install pytorchverwenden, wenn GPU benötigt wird. - Unzureichende Ressourcen für das Mathematik-Kapitel: Das Kapitel selbst verlangt mindestens 40 GB Grafikspeicher und 50 GB Speicherplatz; vor dem Start des Notebooks eine Umgebung mit diesen Ressourcen verwenden.
- Veraltete Links oder Abhängigkeiten: Issues verzeichnen defekte Download-Links und einen Versionskonflikt zwischen
trlundtransformers. Vor eigenständigem Fixieren von Versionen aktuelle Issues und Pull Requests prüfen. - Inkompatibilität mit macOS MPS: Es gibt ein spezifisches Issue dazu; die gefundene Quelle bestätigt das Problem, aber keine bestätigte offizielle Korrektur.
Integrationen und Migration
Der Kurs integriert Transformers, Gradio Spaces, Hugging Face, Qwen, LLaMA-Factory und die Ascend-Plattform innerhalb bestimmter Kapitel. Es wurde kein Migrationsleitfaden von einem anderen Kurs oder zu einem anderen Werkzeug gefunden: Der dokumentierte Weg zur Wiederverwendung des Materials besteht darin, die Notebooks sowie deren Daten- und Modelldateien auszuführen oder anzupassen.
Anwendungsfälle und wem dieses Repository helfen kann
- Studierende und Lehrende, die offenes Praxismaterial für einen Kurs benötigen, können die Kapitel als Laborgrundlage nutzen, da das Repository Erklärung, PDF und Notebook zu Themen von Feinabstimmung bis Sicherheit verbindet.
- Forschende oder Ingenieure, die mit Feinabstimmung beginnen, können die entkoppelte Variante des ersten Kapitels nutzen, um Datenladen, Architektur und Evaluierung zu lokalisieren und zu ändern, bevor sie einen stärker integrierten Ablauf übernehmen.
- Teams mit GPU-Infrastruktur können den Durchlauf zur mathematischen Destillation mit expliziten Anforderungen an Grafikspeicher und Speicherplatz ausführen, um Training, Generierung und Evaluierung im selben Notebook zu beobachten.
- Personen, die an Sicherheit und Agenten arbeiten, können die allgemeine Einführung mit den Kapiteln zu Jailbreak-Angriffen, Agentensicherheit und Alignment ergänzen; sie sollten sie dennoch als Lernmaterial behandeln und den Hinweis des Projekts respektieren, dass keine Genauigkeit garantiert wird.
- Entwickler im Ascend-Ökosystem können im vom Projekt verlinkten gemeinsamen Kurs einen zusätzlichen Lernpfad finden.

Ressourcen
- Repository: https://github.com/Lordog/dive-into-llms
- Dokumentation und Einrichtung: https://github.com/Lordog/dive-into-llms/blob/main/documents/chapter1/README.md
- Kapitel und Notebooks: https://github.com/Lordog/dive-into-llms/tree/main/documents
- Begleitender Ascend-Kurs: https://www.hiascend.com/edu/growth/lm-development
- Community-Übersetzung ins Englische: https://github.com/hhprojects/dive-into-llms-en
- Community und Issues: https://github.com/Lordog/dive-into-llms/issues
Hinweis: Dieser Artikel kombiniert Dokumentation und Repositories von Lordog, die GitHub-API und Community-Quellen, abgerufen am 9. August 2026. Zahlen ändern sich mit der Zeit.
Kommentare