

X For You Feed Algorithm: die veröffentlichte Version von Xs Empfehlungssystem
xai-org/x-algorithm · 33.414★ · 5.421 forks
Alles Wissenswerte über xai-org/x-algorithm: Referenzcode des Systems, das Beiträge für den „Für dich”-Tab von X abruft, einstuft und filtert.
Was X For You Feed Algorithm ist
X For You Feed Algorithm ist das Repository von xAI, das den Kern des Empfehlungssystems der „Für dich”-Timeline von X beschreibt. Es kombiniert Beiträge von gefolgten Konten mit außerhalb des Netzwerks gewonnenen Kandidaten durch auf maschinellem Lernen basierendes Retrieval und ordnet sie mit Phoenix, einem von Grok-1 adaptierten Transformer.
Es ist kein X-Client, keine öffentliche Empfehlungs-API und kein Sofortinstallationsprogramm für eine echte Timeline. Das Projekt selbst stellt klar, dass Phoenix bis auf Skalierungsoptimierungen repräsentativ für das interne Modell ist und dass das verteilte Artefakt ein eingefrorener Checkpoint ist; das Repository dient daher vor allem dazu, die Architektur zu studieren und die enthaltene Demo auszuführen.
Der Ursprung: eine neue Öffnung des X-Algorithmus
GitHub datiert die Erstellung des Repositorys auf den 19. Januar 2026. In den frühen Morgenstunden des 20. Januar kündigte das verifizierte Konto @Engineering auf X an, dass ein neuer Algorithmus basierend auf derselben Grok-Transformer-Architektur veröffentlicht worden sei, und verlinkte dieses Repository; der Beitrag zeigte zum Zeitpunkt des Abrufs 41,2 Millionen Aufrufe.
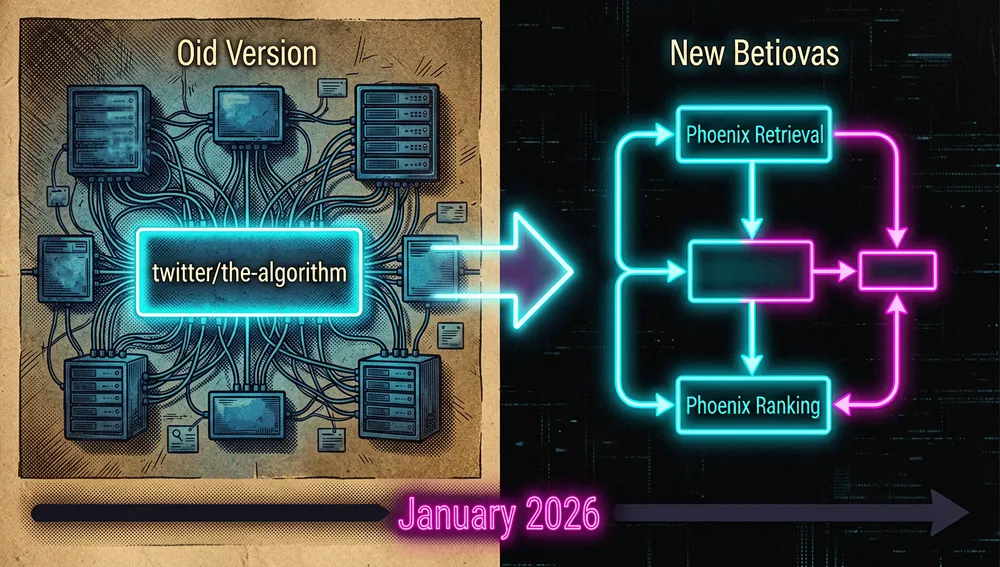
Der relevante Vorgänger ist twitter/the-algorithm, die frühere Veröffentlichung von Xs Empfehlungssystem. Jenes Repository beschreibt mehrere gemeinsam genutzte Dienste, Modelle und Frameworks – darunter Home Mixer, Nutzersignale und Sicherheitsklassifikatoren – und räumt ein, kein vollständiges übergeordnetes Build- und Testsystem gehabt zu haben. Die Änderung von 2026 verlagert die Erklärung hin zu Phoenix und einer ausführbaren Retrieval-dann-Ranking-Demo.
Philosophie und Prinzipien
Die veröffentlichte technische Ausrichtung lässt sich so zusammenfassen:
- Relevanz aus Interaktionssequenzen lernen, nicht aus manuellen Inhaltsregeln: Das README erklärt, manuell entworfene Merkmale und die meisten Heuristiken entfernt zu haben.
- Retrieval von Ranking trennen: Zunächst wird ein großer Korpus durch Ähnlichkeit reduziert; danach sagt ein teureres Modell die Interaktion mit jedem Kandidaten voraus.
- Mehrere Aktionen vorhersagen, nicht einen einzigen Relevanzbegriff: Favoriten, Antworten, Reposts, Klicks, Lesezeit und negative Signale werden zu einer gewichteten Punktzahl zusammengeführt.
- Die Punktzahl jedes Kandidaten unabhängig vom Batch halten: Phoenixs Aufmerksamkeitsmaske verhindert, dass Kandidaten sich gegenseitig beeinflussen, was das Projekt als Voraussetzung für konsistente, cachefähige Punktzahlen darstellt.
Wie es funktioniert
Die Anfrage tritt in Home Mixer ein, der den Kontext der Person hydriert, Kandidaten abruft, sie anreichert, filtert, bewertet, die bestplatzierten auswählt und abschließende Sichtbarkeitsfilter anwendet.
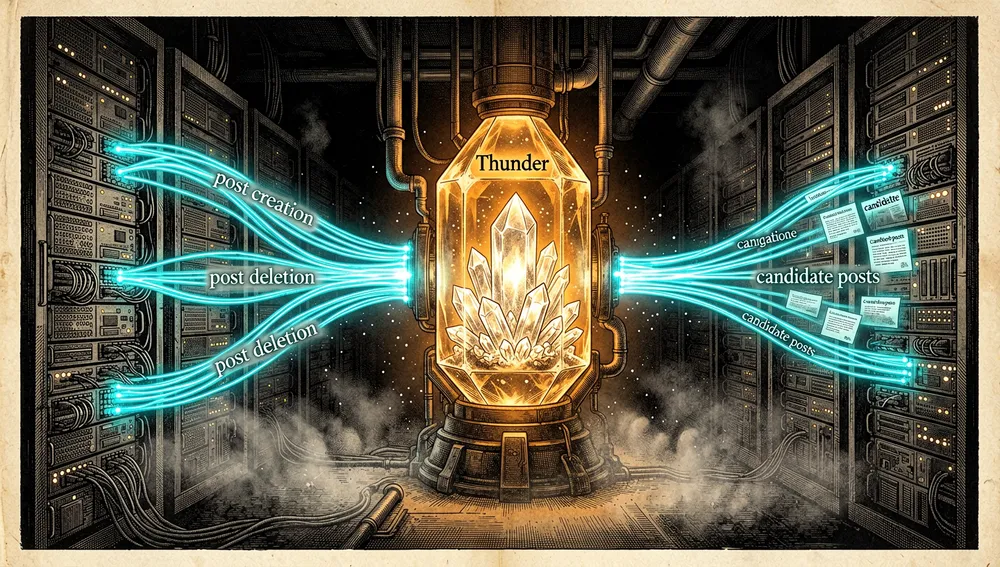
- Thunder hält aktuelle Beiträge im Speicher und konsumiert Erstellungs- und Löschereignisse von Kafka, um Inhalte aus dem gefolgten Netzwerk bereitzustellen.
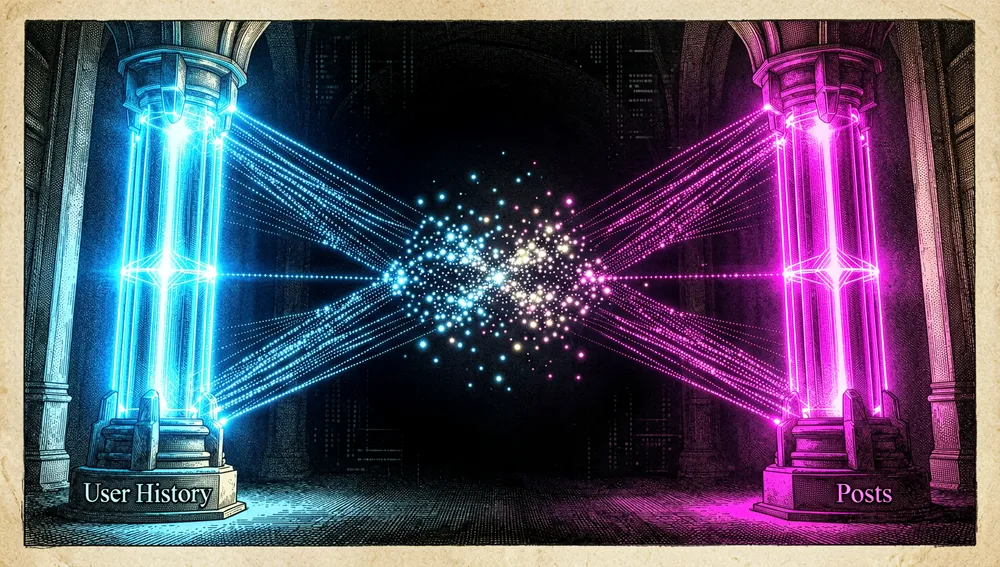
- Phoenix Retrieval nutzt ein Zwei-Türme-Modell: ein Turm kodiert Verlauf und Merkmale der Person; der andere kodiert Beiträge. Skalarprodukt-Ähnlichkeit ruft externe Kandidaten ab.
- Phoenix Ranking verarbeitet den Kontext und diese Kandidaten mit einem Transformer und schätzt Aktionswahrscheinlichkeiten. Der
Weighted Scorerkombiniert die Wahrscheinlichkeiten; eine Diversitätskomponente dämpft anschließend wiederholte Autoren. - Das Rust-Framework
candidate-pipelinedrückt Erweiterungen alsSource,Hydrator,Filter,Scorer,SelectorundSideEffectaus, mit paralleler Ausführung, wo zutreffend.
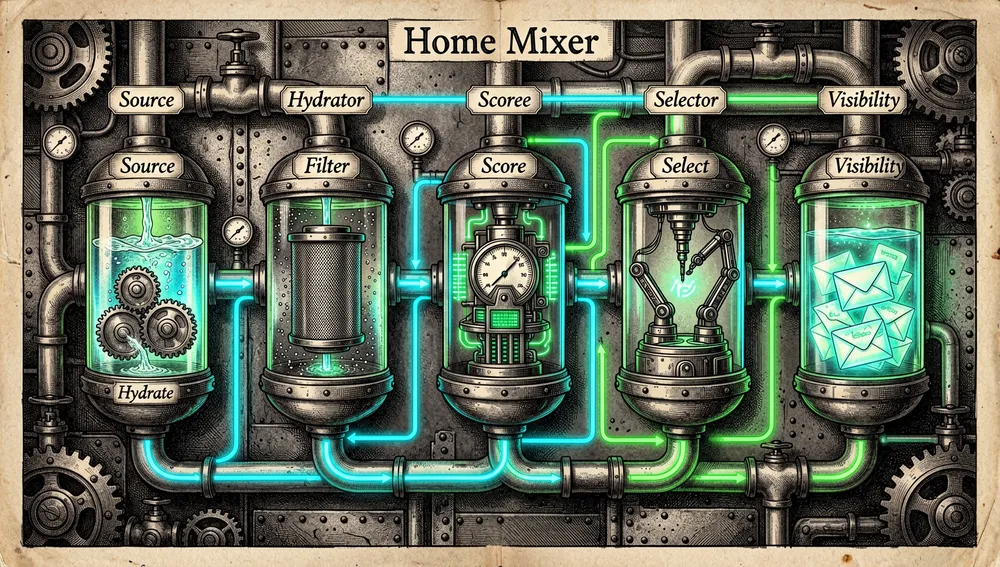
Das Update vom 15. Mai 2026 fügte einen einzigen Inferenz-Einstiegspunkt hinzu, phoenix/run_pipeline.py, Demo-Modelle und -Korpus, einen grox/-Dienst für Inhaltsverständnis, zusätzliche Quellen und Anzeigenmischung.
Offizieller und halboffizieller Status
Das Repository gehört der Organisation xai-org, und der Beitrag von @Engineering verlinkt direkt darauf als Xs offenen Algorithmus; diese beiden Belege begründen einen offiziellen Veröffentlichungsstatus, keinen Community-Fork.
Es wurde kein Beleg dafür gefunden, dass es ein in einem Marktplatz akzeptiertes Paket, eine produktunterstützte Bibliothek oder eine Standardspezifikation ist. Sein praktischer Status ist enger gefasst: offizielle Dokumentation und Demo einer Produktionsarchitektur, mit bewusst reduzierten Daten, Checkpoint und Skalierungsoptimierungen.
Das Ökosystem
Verifizierte Schwester-Repositories
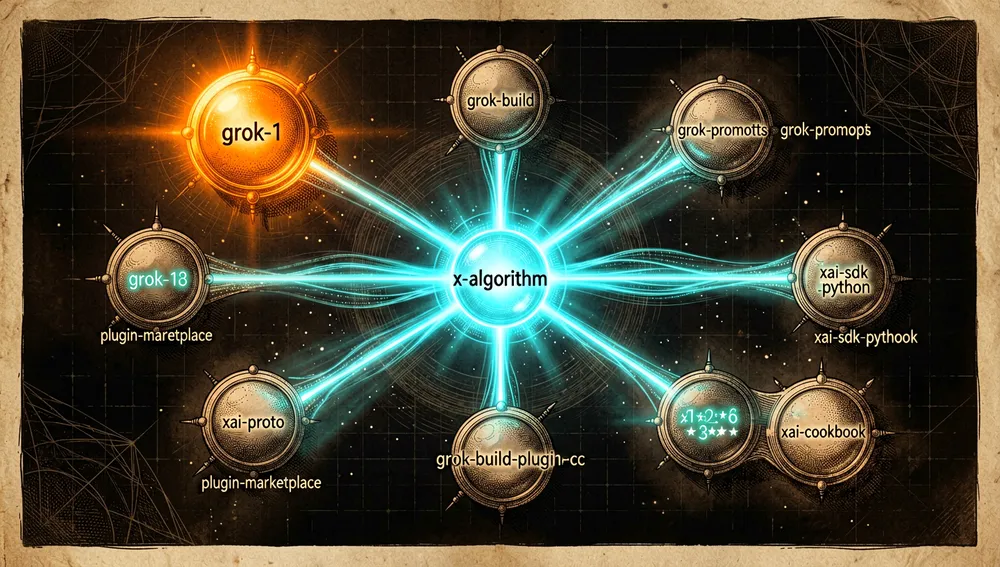
Die Suche in den öffentlichen Repositories von xai-org förderte die folgenden, organisatorisch verwandten Projekte zutage, ohne dass dies eine technische Abhängigkeit belegt, außer wo das README sie spezifiziert:
xai-org/grok-1— 52.107 Sterne; das README dieses Repositorys erklärt, dass die für Phoenix adaptierte Transformer-Implementierung von dort stammt.xai-org/grok-build— 24.589 Sterne; Harness und TUI für Coding-Agenten der Organisation.xai-org/grok-prompts— 4.318 Sterne; Anweisungen für den Grok-Assistenten und den@grok-Bot.xai-org/xai-sdk-python— 536 Sterne; offizielles Python-SDK für die xAI-API.xai-org/xai-cookbook— 527 Sterne; praktische Beispiele für Groks APIs.xai-org/grok-build-plugin-cc— 187 Sterne; ein Claude-Code-Plugin für die Grok-Build-CLI.xai-org/plugin-marketplace— 147 Sterne; offizieller Plugin-Marktplatz von xAI.xai-org/xai-proto— 142 Sterne; öffentliche Protocol-Buffers-Definitionen für xAIs gRPC-API.
Forks, Ports und Erweiterungen
Die API meldete 4.589 Forks. Der am höchsten bewertete gefundene Fork war AbdelStark/x-algorithm mit 12; er behält dieselbe Beschreibung bei. Auch MaoTouHU/x-algorithm tauchte auf, ein chinesischer Fork mit 4 Sternen, dessen Beschreibung eine allgemeine Algorithmen-Bibliothek in Python/C++ verspricht; diese Behauptung widerspricht dem Rust-Quellcode und dem spezifischen Zweck des Originals, weshalb sie nicht als Übersetzung oder verifizierter Port behandelt werden sollte.
Es wurde kein Fork mit gefundener Dokumentation identifiziert, die belegt, dass er ein gepflegter Port, eine originalgetreue Übersetzung oder eine relevante funktionale Erweiterung ist. Das ist eine Einschränkung der Suche, keine Behauptung, dass außerhalb der konsultierten öffentlichen Ergebnisse keine Ableger existieren.
Zahlen des Repos
Messung: 10. August 2026, GitHub-API.
| Metrik | Wert |
|---|---|
| Sterne | 26.967 |
| Forks | 4.589 |
| Echte Abonnenten | 313 |
| Hauptsprache | Rust |
| Lizenz | Apache-2.0 |
| Erstellung | 19. Januar 2026 |
| Letzter Code-Push | 15. Mai 2026 |
| Metadaten-Aktualisierung | 10. August 2026 |
| GitHub-Releases | Keine gefunden |
| Von der API gemeldete offene Issues | 0 |
Die Contributor-Abfrage lieferte keine einordbare Liste, weshalb keine „Top-Contributor” zugeschrieben werden. watchers_count spiegelt in dieser API die Gesamtsternzahl wider; deshalb wird subscribers_count als tatsächliche Abonnenten angegeben. open_issues_count kann offene Pull Requests einschließen, obwohl separate Abfragen zu Issues und Pull Requests bei dieser Messung keine Einträge lieferten.
Wie man beiträgt
Der Root-Verzeichnisbaum enthält weder CONTRIBUTING.md, CONTRIBUTING, .github/CONTRIBUTING.md noch CHANGELOG.md, und es wurden auch keine Issues oder Pull Requests gefunden, die eine alternative Richtlinie dokumentieren. Es gibt daher keinen auffindbaren Beitragsablauf – Branches, eine Anfragevorlage oder ein Evaluierungs-Harness – für dieses Repository. Das hindert nicht daran, einen Fork unter Apache-2.0 zu eröffnen; es bedeutet nur, dass dies nicht als offiziell dokumentierter Beitragsprozess dargestellt werden sollte.
Wie die Community reagierte
- Der Hacker-News-Thread 46688173, eingereicht von grainier, verlinkte das Repository am 20. Januar 2026 und hatte 125 Punkte und 65 Kommentare. swyx bezeichnete das README als nützlich, wandte aber ein, dass ohne veröffentlichte Gewichte der tatsächliche Einfluss jedes Merkmals weitgehend unsichtbar bleibe, und beschrieb es als Black Box; das ist seine Einschätzung, keine unabhängige Prüfung.
- Im selben Thread merkte nailer an, dass die Apache-Lizenz die Definition freier Software erfüllt; das ist eine konkrete Beobachtung zur Lizenz, keine Garantie, dass das gesamte Produktionssystem verfügbar ist.
- big_toast hielt in einer späteren Diskussion Interaktionssignale – etwa Klick, Lesezeit und „kein Interesse” – für wichtig und fragte, wie diese in anderen Empfehlungs-Ökosystemen erfasst werden könnten. Der Einwand verweist auf die praktische Abhängigkeit von Verhaltensdaten, die eine externe Demo nicht besitzt.
- Die offizielle Ankündigung von @Engineering erhielt außerdem eine Antwort von @quasimondo, der nach den tatsächlichen Gewichten fragte, die bei der Bewertung eines Beitrags verwendet werden. Der Quellbeitrag ist werblich; die Erwiderung belegt nur diese konkrete Frage, keinen Konsens.
Es wurde auf Reddit, Product Hunt, Dev.to, X, YouTube und in Podcast-Suchen recherchiert. Reddit lieferte eine 403-Sperre und Product Hunt eine weitere 403, sodass keine Abwesenheit von Berichterstattung abgeleitet wird. Die X-Suche erlaubte tatsächlich, die offizielle Ankündigung zu finden. Auf Dev.to und in der Podcast-Suche wurde keine exakte Erwähnung des Repositorys gefunden. Es wurde bei diesem Durchlauf keine überprüfbare Hashnode-Rezension gefunden.
X For You Feed Algorithm im Vergleich zu anderen Ansätzen
| Ansatz | Nachweisbare Überschneidung | Nachweisbarer Unterschied |
|---|---|---|
twitter/the-algorithm | Beide veröffentlichen Komponenten von Xs Empfehlungssystem und erklären die „Für dich”-Timeline. | Das frühere Repository legt ein breites Portfolio an Diensten und Modellen offen; x-algorithm präsentiert Phoenix, eine Demo-Pipeline und Retrieval plus Ranking mit einem Transformer. |
xai-org/grok-1 | Phoenix erklärt, seine Transformer-Implementierung zu adaptieren. | Grok-1 ist die Veröffentlichung des Sprachmodells; Phoenix fügt Empfehlungseingaben, Zwei-Türme-Retrieval und eine Kandidaten-Isolationsmaske hinzu. |
Es wurden keine fremden Vergleichsobjekte hinzugefügt, ohne Dokumentation zu finden, die eine konkrete technische Beziehung belegt.
Kurzanleitung zur Nutzung
Installation und erster Start
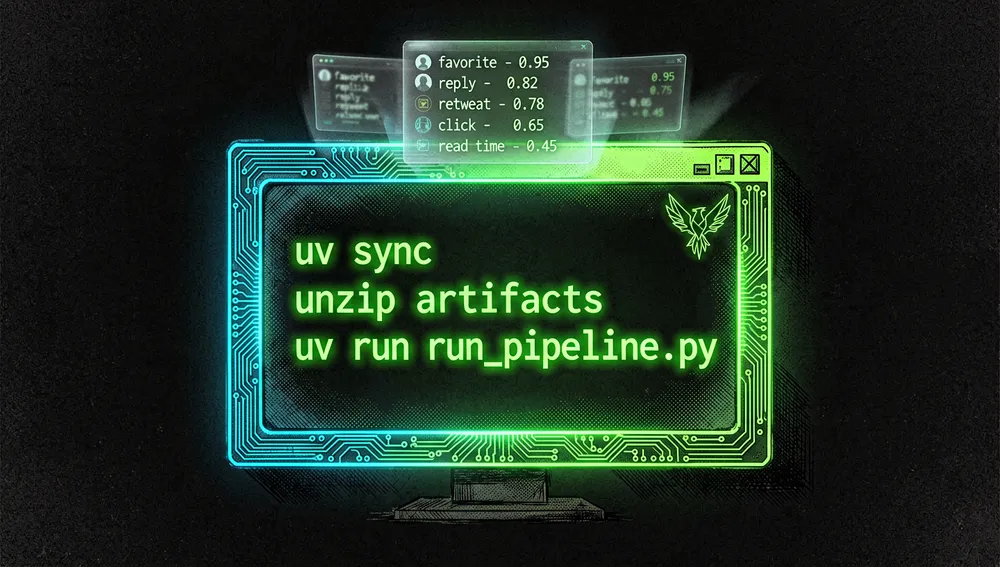
Der veröffentlichte ausführbare Teil ist die Phoenix-Demo, nicht Xs vollständiger Dienst. uv installieren und von phoenix/ aus ausführen:
uv sync
unzip artifacts/oss-phoenix-artifacts.zip -d artifacts/
uv run run_pipeline.py --artifacts_dir artifacts/oss-phoenix-artifacts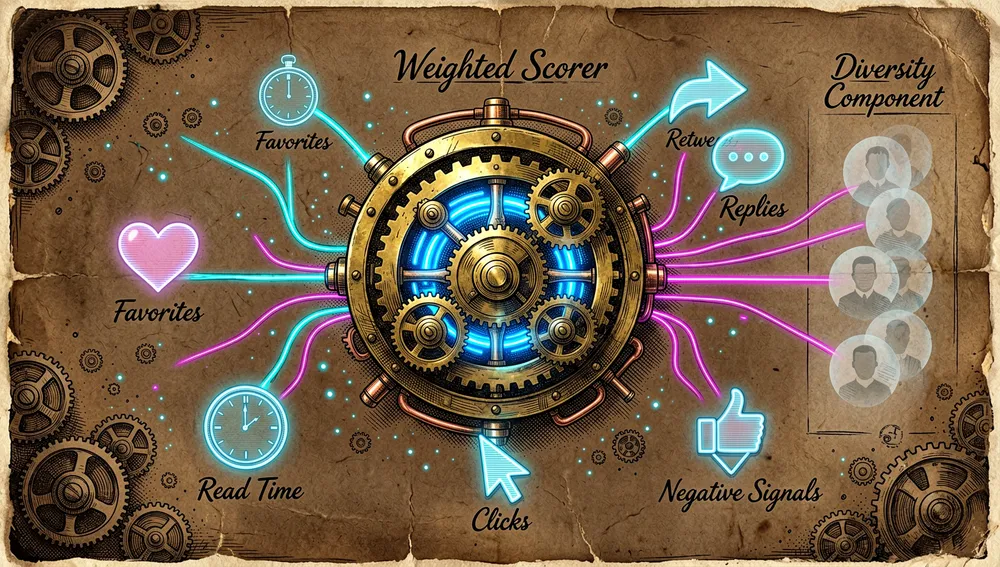
Die Datei oss-phoenix-artifacts.zip wird über Git LFS von phoenix/artifacts/ bezogen. Der erste Lauf lädt die Retrieval- und Ranking-Checkpoints, verwendet den Beispielverlauf und zeigt die eingestufte Liste mit Wahrscheinlichkeiten je Aktion.
Übliche Arbeitsabläufe
- Das vollständige Beispiel ausführen: Der obige Befehl ruft die 200 relevantesten Beiträge aus einem Sport-Korpus von etwa 537.000 Beiträgen ab und stuft sie neu ein.
- Den simulierten Verlauf ändern:
phoenix/example_sequence.jsonbearbeiten; jedes Element benötigtpost_id,author_idundactions. - Mehr Kandidaten abrufen:
--top_k_retrieval 500vor dem Einstufen verwenden. - Mehr Ergebnisse anzeigen:
--top_k_display 50verwenden. - Die Beispielmodelle prüfen:
uv run pytest test_recsys_model.py test_recsys_retrieval_model.pyausführen.
Wesentliche Konfiguration
artifacts/oss-phoenix-artifacts/retrieval/config.json: Modell- und Hash-Funktionsparameter für das Retrieval.artifacts/oss-phoenix-artifacts/ranker/config.json: Konfiguration des Rankers und des Aktions-Heads.example_sequence.json: synthetischer Interaktionsverlauf, der die Demo speist.--artifacts_dir: Pfad zum extrahierten Artefaktverzeichnis.--top_k_retrievalund--top_k_display: Retrieval-Tiefe und Anzahl der ausgegebenen Ergebnisse.
Häufige Fallstricke und Lösungen
- Dies ist keine Installation von Xs Feed: keine Verbindung zu Konten oder Produktion erwarten; der Korpus ist sportbezogen, deckt ein sechsstündiges Zeitfenster ab, und der Checkpoint ist eingefroren.
- Fehlende Modelldateien: Das ZIP wird mit Git LFS verwaltet und muss vor der Ausführung der Pipeline unter
phoenix/artifacts/extrahiert werden. - Speicherkosten: Die Embedding-Tabellen für Retrieval und Ranking nehmen jeweils etwa 1,4 GB ein; vor dem Herunterladen der Artefakte Speicherplatz reservieren.
- Die Punktzahl erklärt nicht die Produktionsgewichte: Das Projekt zeigt Wahrscheinlichkeiten je Aktion und eine gewichtete Kombination, aber die Community-Kritik merkte an, dass die tatsächlichen Gewichte nicht veröffentlicht sind.
Integrationen und Migration
Das README dokumentiert keine Integration mit Editoren, CI, MCP-Servern, Messaging oder eine automatisierte Migration von twitter/the-algorithm. Die nachweisbare Integration ist konzeptionell und codebezogen: Phoenix adaptiert die Transformer-Implementierung von xai-org/grok-1; Xs früheres Projekt dient als architektonischer Vorläufer, nicht als veröffentlichter Migrationspfad.
Anwendungsfälle und wem dieses Repository helfen kann
- Empfehlungssystem-Engineering: bietet eine konkrete Referenz zum Studium der Trennung von Retrieval und Ranking, der Multi-Aktions-Wahrscheinlichkeiten und einer zusammensetzbaren Kandidaten-Pipeline.
- Forschung und Lehre zu Machine-Learning-Systemen: Die Phoenix-Demo erlaubt es, einen synthetischen Verlauf zu ändern, die Anzahl der Kandidaten zu variieren und Wahrscheinlichkeiten über einen begrenzten Korpus zu beobachten, ohne zu behaupten, die Produktion zu reproduzieren.
- Teams, die Produktsignale entwerfen: Die dokumentierten Filter, die Autorenvielfalt und die negativen Aktionen erlauben es zu diskutieren, welche Informationen ein Empfehlungssystem benötigen würde und welche Richtlinien vor und nach der Bewertung gelten würden.
- Technische Transparenzprüfung: Der Code offenbart Struktur und Designentscheidungen, aber das Fehlen veröffentlichter Gewichte und die Skalierungsreduktion sind explizite Grenzen, die bei der Bewertung der erreichten Transparenz berücksichtigt werden müssen.
Ressourcen
- Repository: https://github.com/xai-org/x-algorithm
- Dokumentation und Einrichtung: https://github.com/xai-org/x-algorithm/tree/main/phoenix
- Vorgänger-Repository: https://github.com/twitter/the-algorithm
- Offizielle Veröffentlichung auf X: https://x.com/Engineering/status/2013471689087086804
- Hacker-News-Konversation: https://news.ycombinator.com/item?id=46688173
- Video-Tutorial: https://www.youtube.com/watch?v=rR-00bN2cmk — „How X (Twitter) For You Feed Works: X Algorithm System Design Explained”, Kanal Debug with Dheeraj, ca. 20 Minuten 40 Sekunden.
Hinweis: Dieser Artikel kombiniert Dokumentation und die GitHub-API, einen offiziellen X-Beitrag, Hacker News und ein Video, abgerufen am 10. August 2026. Kennzahlen ändern sich mit der Zeit.
Kommentare