

MiroFish: Multi-Agenten-Sozialsimulation zur Erkundung von Szenarien
666ghj/MiroFish · 74.610★ · 11.467 forks
Alles Wissenswerte über 666ghj/MiroFish: eine “Schwarmintelligenz”-Engine, die reale Ausgangsinformationen aufnimmt, eine simulierte Umgebung aufbaut und Agenten mit Personas, Gedächtnis und Regeln interagieren lässt, um Szenarioberichte zu erstellen.
Was MiroFish ist
MiroFish ist ein quelloffenes Projekt, das sich als universelle Schwarmintelligenz-Engine präsentiert, um “alles vorherzusagen”. Ausgehend von Nachrichten, Politikentwürfen, Finanzsignalen oder anderem Ausgangsmaterial soll eine parallele digitale Welt aufgebaut werden, in der viele Agenten mit Persönlichkeit, Gedächtnis und Verhaltenslogik interagieren und sich entwickeln.
Die Beschreibung sollte präzise gelesen werden: MiroFish ist ein Werkzeug zur Simulation und Szenariogenerierung, kein validiertes System zur Vorhersage der Zukunft. Seine Berichte können nützlich sein, um Hypothesen, Reaktionen oder Risiken zu erkunden; sie sind kein kausaler Beleg, keine verlässliche Finanzprognose und keine ausreichende Grundlage für politische, medizinische, rechtliche oder Investitionsentscheidungen.
Das Repository wird unter der MIT-Lizenz veröffentlicht. Sein README zeigt Demo-Fälle zu öffentlicher Meinung, dem angeblich verlorenen Schluss von Der Traum der Roten Kammer und vorhergesagten Finanz-/Politikszenarien, die Projektdemonstrationen sind, keine unabhängigen Genauigkeitsbewertungen.
Der Ursprung: von einem Realitätskeim zu einer Parallelwelt
Das Angebot geht von einem “Realitätskeim” aus: Dokumente, Nachrichten oder Kontextinformationen, die einen Wissens- und Gedächtnisgraphen speisen. Danach werden Entitäten und Beziehungen extrahiert, Personas generiert, Agenten konfiguriert und Interaktionen ausgeführt, um eine simulierte soziale Entwicklung zu beobachten.
Der im README aufgeführte Ablauf hat fünf Phasen: Graphaufbau; Umgebungskonfiguration; Simulation; Berichterstellung; und vertiefte Interaktion. Eine Drittanbieter-Seite, die die Frontend-Komponenten analysiert, ordnet diese Phasen separaten Bildschirmen zu, aber diese Zuordnung sollte als sekundäre Dokumentation betrachtet und gegen den aktuellen Code überprüft werden.
MiroFish stützt sich laut der Erklärung des Projekts auf GraphRAG und eine Kombination aus individuellem/kollektivem Gedächtnis. Das erklärt, warum Kontextquellen und Modelle benötigt werden, die große Textmengen verarbeiten; es bedeutet auch, dass die Qualität des Ergebnisses von den eingegebenen Daten, den Prompts, dem Modell, der Anzahl der Agenten und den Simulationsregeln abhängt.
Philosophie und Prinzipien
- Simulieren, keine Gewissheit behaupten. Das Produkt erzeugt mögliche Dynamiken aus einer Ausgangsrealität; ein plausibles Ergebnis beweist nicht, dass ein Ereignis eintreten wird.
- Heterogene Agenten. Personas und Konfigurationen sollen unterschiedliche Perspektiven und Verhaltensweisen innerhalb der simulierten Umgebung darstellen.
- Strukturierter Kontext. Der Aufbau von Graph und Gedächtnis soll verhindern, dass jeder Agent nur aus einem isolierten Prompt heraus antwortet.
- Interaktive Erkundung. Nach der Erstellung eines Berichts kann die Nutzerin bzw. der Nutzer über Agenten und einen Berichtsagenten vertiefen.
- Open Source und Eigenbetrieb. Das Repository bietet lokale Bereitstellung über Docker Compose an; Rechenressourcen, Schlüssel und Daten bleiben in der Verantwortung der Betreiberin bzw. des Betreibers.
Wie es funktioniert
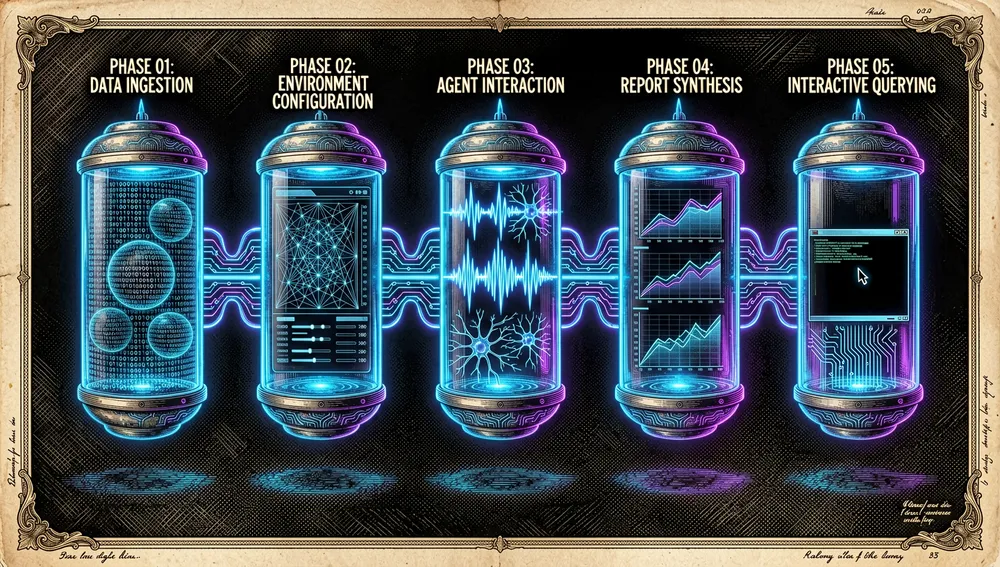
Ausgangsmaterial → Entitätsextraktion / GraphRAG → Umgebung und Personas
                                                  → Agenteninteraktion
                                                  → Szenariobericht
                                                  → Folgefragen
Die erste Stufe nimmt die Quelle auf und erzeugt den Graphen. Die zweite konfiguriert Entitäten, Beziehungen, Personas und Agenten. Die dritte führt die Simulation aus; die vierte konsolidiert einen Bericht; und die fünfte erlaubt es, das Ergebnis mit zusätzlicher Interaktion zu überprüfen.
Das Repository enthält Backend und Frontend, docker-compose.yml, CI-Workflows und Dokumentation auf Englisch und Chinesisch. Das FAQ des Projekts gibt an, dass das GitHub-Repository und mirofish.ai die offiziellen Kanäle sind und dass die im README erwähnte statische Demo 666ghj.github.io/mirofish-demo ist.
Hauptkomponenten
- Keim und Graph: Eingabeinformationen, Entitäts- und Beziehungsextraktion, GraphRAG und Gedächtnis.
- Umgebung und Personas: Profilgenerierung und Interaktionsregeln für die Agenten.
- Simulation: Runden sozialer Aktivität, modelliert vom konfigurierten LLM und vorherigen Informationen.
- Bericht und Interaktion: Szenariosynthese und die Möglichkeit, simulierte Agenten oder den ReportAgent abzufragen.
- Ausführungspersistenz: Das FAQ erwähnt
run_state.json, Protokolle und SQLite-Datenbanken für Netzwerkintegrationen; ein erzwungener Neustart löscht vorherigen Zustand.
Das Ökosystem
Das Projekt erhält laut einem sekundären Eintrag Unterstützung und strategische Inkubation von der Shanda Group und stützt sich auf das OASIS-Framework von CAMEL-AI; die Behauptung sollte gegen das README geprüft werden und wird nicht als Garantie für Pflege oder Unternehmenssupport interpretiert.
Es gibt Community-Projekte rund um die Installation. radishbuild/mirofish-cloud schlägt vor, eine private Instanz bei Compute-Anbietern bereitzustellen; es handelt sich um eine Drittanbieter-Schicht, kein offizielles Hosting des Projekts.
Das offizielle FAQ warnt ausdrücklich, dass Domains wie mirofish.my, mirofish.homes und mirofish.co.in keine offiziellen oder autorisierten Dienste sind. Das ist eine wichtige Vorsichtsmaßnahme: Es sollten keine API-Schlüssel, privaten Dokumente oder Zahlungen an Seiten gesendet werden, die den Namen verwenden, ohne die Beziehung zum Repository zu bestätigen.
Zahlen zum Repository
Erhoben: 24. August 2026, GitHub-API. Der Quellartikel für dieses Repository enthielt keine eigene Metriktabelle; diese Zahlen wurden zum Veröffentlichungszeitpunkt direkt gegen die öffentliche GitHub-API überprüft.
| Metrik | Wert |
|---|---|
| Sterne | 71.481 |
| Forks | 11.111 |
| Echte Abonnenten | 439 |
watchers_count spiegelt in der allgemeinen GitHub-Antwort die Sterne; deshalb wird subscribers_count als tatsächliche Abonnentenzahl angegeben.
Schnelleinstieg
Vorbereitung und Installation
Der Referenzweg ist, das Repository zu klonen und das aktuelle README sowie docker-compose.yml zu prüfen. Das Projekt erfordert die Konfiguration eines LLM-Anbieters und auf bestimmten Wegen Hilfsdienste für Gedächtnis/Graph. Eine Community-Diskussion zeigt, dass die Verwendung eines lokalen Modells nicht zwangsläufig die von Komponenten wie Zep Cloud benötigten Schlüssel überflüssig macht; das ist eine Nutzererfahrung, keine endgültige Spezifikation.
Vor der Ausführung einer Simulation lohnt es sich, Folgendes vorzubereiten:
- Ein begrenztes, zuordenbares, aktuelles Quellenpaket.
- Eine konkrete Szenariofrage, identifizierte Akteure und einen expliziten Zeithorizont.
- Ein Überprüfungskriterium, das Fakten von den durch die Simulation erzeugten Hypothesen trennt.
- Ein Rechenbudget: Mehr Agenten und mehr Runden erhöhen Kosten, Zeit und thermische Last.
Gängige Arbeitsabläufe
- Produkt- oder Kommunikationsszenario: Nutzerforschung und Botschaften beisteuern; Reaktionen als qualitative Erkundung simulieren, danach mit echter Forschung validieren.
- Analyse öffentlicher Meinung: datierte, mit Herkunft versehene Quellen eingeben, Akteure definieren und verschiedene Keime oder Annahmen vergleichen.
- Narrative Recherche: die Umgebung nutzen, um Ausgänge oder hypothetische Reaktionen zu entwickeln, ohne Kreativität mit Vorhersage zu verwechseln.
- Akademischer Prototyp: Modelle, Prompts, Quellen, Anzahl der Agenten und Variabilität zwischen Durchläufen dokumentieren, damit die Übung interpretierbar bleibt.
Häufige Fallstricke und Lösungen
- Die Bewertung des Agenten als Wahrheit behandeln. Eine externe Kritik weist darauf hin, dass Agenten plausible Rechtfertigungen ohne unabhängigen Verifizierungsmechanismus erzeugen können. Das ist die Kritik eines konkurrierenden Projekts, kein Audit, aber sie weist auf eine reale Grenze LLM-basierter Simulationen hin.
- Ergebnisse für den Handel an Märkten nutzen. Eine Community-Diskussion bringt die Nutzung für Volatilität oder Trading auf und erkennt die Spannung gegenüber statistischen Modellen an; es wurde kein Beleg dafür gefunden, dass MiroFish gültige Finanzvorhersagen liefert.
- Bedingungen des Durchlaufs nicht festhalten. Ohne Modell, Prompt, Keime, Datum, Agenten und Berichtskriterien lassen sich Ergebnisse nicht vergleichen oder auditieren.
- Technische Anforderungen unterschätzen. Mehrere Gespräche nennen Konfiguration, Kosten und thermische/Ressourcenlast als praktische Hindernisse; zuerst mit kleinen Szenarien testen.
- Einer Domain aufgrund des Namens vertrauen. Nur die Kanäle verwenden, die das FAQ als offiziell bestätigt.
Sicherheit und Vertrauensmodell
Eine von VulDB akzeptierte Einreichung weist darauf hin, dass Version 0.1.2 mehr als 50 REST-Endpunkte ohne Authentifizierung oder Autorisierung offenlegte, darunter einige destruktive. Die Quelle verlinkt Issue #487; es handelt sich um Schwachstelleninformationen, die gegen die konkrete Version und spätere Änderungen überprüft werden sollten, aber sie reichen aus, um veraltete Instanzen nicht einem nicht vertrauenswürdigen Netzwerk auszusetzen.
Mindestens sollte eine Instanz hinter einem privaten Netzwerk, einem authentifizierten Proxy und Zugriffskontrollen bleiben; Schlüssel sollten in Geheimnissen außerhalb des Repositorys liegen, und hochgeladene Quellen sollten als potenziell sensible Daten behandelt werden. Destruktive Funktionen sollten nicht ausgeführt und private Dokumente nicht hochgeladen werden, ohne die Zugriffsrichtlinie der Bereitstellung zu kennen.
Das Projekt befindet sich in einer frühen Phase — ein sekundärer Eintrag fand v0.1.0 mit noch in Erprobung befindlicher Windows-Kompatibilität; diese Information kann veraltet sein, verstärkt aber die Notwendigkeit, Issues, Releases und Konfiguration vor jeder gemeinsamen Nutzung zu überprüfen.
Wie die Community reagierte
Es gibt ein inoffizielles Subreddit, das dem Teilen von Szenarien, Installation und Experimenten gewidmet ist. Dessen Moderation stellt ausdrücklich klar, dass es nicht mit dem MiroFish-Team verbunden ist, und schlägt vor, Ziel, Modelle, Anzahl der Agenten, Annahmen, Kosten und fehlgeschlagene Ergebnisse zusammen mit jeder Simulation zu veröffentlichen.
Die Gespräche zeigen Neugier an Anwendungen in Politik, Produkt, öffentlicher Meinung und Trading, aber auch Schwierigkeiten mit Konfiguration, Schlüsseln und Qualitätsbewertung. Ein spanischsprachiger Beitrag behauptet, eine politische Simulation Boliviens habe spätere Maßnahmen vorweggenommen; das ist ein individuelles nachträgliches Zeugnis, kein kontrollierter Genauigkeitsnachweis.
Die externe Rezeption umfasst Kritik von einem abgeleiteten Projekt, das infrage stellt, ob LLM-Agenten Bewertungen ohne überprüfbare Belege rechtfertigen können. Das sollte als eine interessierte Position der Autorenschaft eines anderen Werkzeugs gelesen werden, obwohl es eine nützliche Erinnerung ist, eine Simulation nicht zu einer Quelle der Wahrheit zu machen.
MiroFish im Vergleich zu anderen Ansätzen
| Ansatz | Überprüfbare Überschneidung | Überprüfbarer Unterschied |
|---|---|---|
| Traditionelle statistische Simulation | Beide erkunden Szenarien und Sensitivitäten. | MiroFish stellt textuelle Agenten mit Personas und Gedächtnis dar; es bietet dadurch keine automatische statistische Validierung. |
| Ein Recherche-RAG-Agent | Beide gehen von Dokumenten aus und rufen Kontext ab. | MiroFish nutzt diesen Kontext, um viele simulierte Interaktionen und einen Bericht zur sozialen Dynamik zu konfigurieren. |
brain-in-the-fish | Von MiroFish inspiriert, arbeitet an der Glaubwürdigkeit von Vorhersagen. | Es ist ein Drittprojekt, das eine andere Verifizierungsschicht vorschlägt und den ursprünglichen Ansatz kritisiert. |
mirofish-cloud | Erleichtert die Bereitstellung von MiroFish. | Es ist ein Community-Bereitsteller über externe Infrastruktur, nicht das Kernprojekt. |
Anwendungsfälle und wem dieses Repository helfen kann
- Produkt- und Forschungsteams, die Hypothesen über Reaktionen, Akteure und Konsequenzen erzeugen möchten, bevor sie echte Forschung betreiben.
- Szenarioanalystinnen und -analysten, die alternative Narrative erkunden und Annahmen dokumentieren müssen, statt abschließende Prognosen abzugeben.
- Autorinnen, Autoren und Weltenbauer, die Interaktionen zwischen Figuren oder Gruppen aus einer dokumentarischen Grundlage modellieren möchten.
- Agentenforscherinnen und -forscher, die mit Gedächtnis, Graphen und sozialer Simulation experimentieren möchten und dabei ihre Bedingungen sorgfältig festhalten.
Es sollte nicht als Entscheidungsmaschine für Finanzen, Politik oder Sicherheit ohne externe Validierung, menschliche Analyse und domänengerechte Methoden verwendet werden.
Ressourcen
- Repository: https://github.com/666ghj/MiroFish
- Offizielles FAQ: https://github.com/666ghj/MiroFish/issues/726
- Statische Demo: https://666ghj.github.io/mirofish-demo
- Inoffizielle Community: https://www.reddit.com/r/MiroFish/
- Community-Bereitstellung: https://github.com/radishbuild/mirofish-cloud
Hinweis: Dieser Artikel kombiniert das Repository, das offizielle FAQ, Community-Quellen und einen Schwachstellenverweis, abgerufen am 17. August 2026. Simulationsergebnisse sind durch ihre Daten und Konfiguration bedingte Hypothesen; sie entsprechen keinen verifizierten Vorhersagen.
Kommentare