

VoxCPM: mehrsprachige Sprachsynthese ohne Tokenizer
OpenBMB/VoxCPM · 37.974★ · 4.314 forks
Alles Wissenswerte über OpenBMB/VoxCPM: ein Open-Source-, Open-Weight-Text-zu-Sprache-System, das kontinuierliches Audio direkt generiert, ohne diskrete Tokenisierung, und dessen Version 2 30 Sprachen, beschreibungsbasiertes Voice Design und Klonen bei 48 kHz unterstützt.
Was VoxCPM ist
VoxCPM ist ein tokenizer-freies Text-zu-Sprache-System (TTS): Anstatt Audio in ein Vokabular diskreter Tokens umzuwandeln und diese dann zu dekodieren, generiert es kontinuierliche Audiodarstellungen direkt durch eine Ende-zu-Ende-autoregressive Diffusions-Architektur. Das Produkt ist ein Open-Weight-Modell (Apache-2.0) mit Python-API, CLI und Web-Demo.
Die aktuelle Version ist VoxCPM2, ein Modell mit 2B Parametern, trainiert mit über 2 Millionen Stunden mehrsprachiger Sprache, das 30 Sprachen und 9 chinesische Dialekte unterstützt, Voice Design (Erstellen einer neuen Stimme aus einer natürlichsprachlichen Beschreibung ohne Referenzaudio), kontrollierbares Klonen (Klonen einer Stimme aus einem kurzen Clip mit Anpassung von Stil, Tempo und Emotion) und Klonen mit maximaler Wiedergabetreue durch Audio-Fortsetzung, mit nativer 48-kHz-Ausgabe. Es baut auf dem MiniCPM-4-Backbone derselben Organisation auf.
Ursprung
Das Repository wurde am 16. September 2025 von der Organisation OpenBMB erstellt, dem MiniCPM-Modellteam von ModelBest (einem chinesischen Unternehmen) in Zusammenarbeit mit THUHCSI (einer Forschungsgruppe der Tsinghua-Universität).
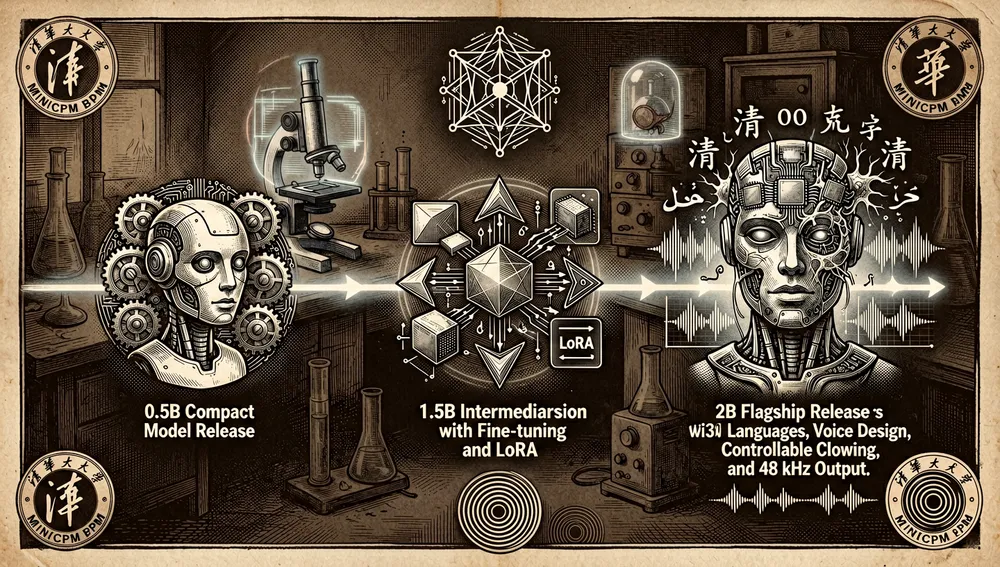
Die im README dokumentierte Chronologie: September 2025, Veröffentlichung des technischen VoxCPM-Berichts und Start von VoxCPM-0.5B, das laut README Platz 1 im HuggingFace-Trending erreichte; 5. Dezember 2025, Veröffentlichung der VoxCPM1.5-Gewichte mit SFT- und LoRA-Fine-Tuning, laut README Platz 1 im GitHub-Trending; 6. April 2026, Start von VoxCPM2 — 2B, 30 Sprachen, Voice Design und kontrollierbares Klonen, 48-kHz-Ausgabe — mit technischem Bericht auf arXiv.
Die Arbeitslinie ist eine Erweiterung der MiniCPM-Familie (10.222 Sterne), mit der sie die Philosophie kleiner, leistungsfähiger, lokal laufender Modelle teilt. Das README dankt explizit DiTAR für das autoregressive Diffusions-Backbone, CosyVoice (FunAudioLLM) für die LocDiT-Flow-Matching-Implementierung und DAC (descript-audio-codec) für das Audio-VAE-Backbone.
Philosophie und Prinzipien
Der technische Bericht und das README zeigen vier kohärente Designentscheidungen:
- Keine diskrete Tokenisierung: Das Modell operiert vollständig im latenten Raum des AudioVAE V2 und „malt” das Audio mit einem Diffusionsschritt (LocDiT) an jeder Position, statt zwischen quantisierten Tokens zu wählen. Das Argument lautet, dass ein diskreter Quantisierer einen Qualitäts-Engpass einführt; ohne ihn kann das VAE direkt bei 48 kHz rekonstruieren.
- Ein Modell, mehrere Modi: Der technische Bericht beschreibt eine „vereinheitlichte Sequenzorganisation”, bei der jeder Generierungsmodus (Text-zu-Sprache, Voice Design, Referenz-Klonen, Fortsetzungs-Klonen) als unterschiedliche Anordnung derselben Eingabeblöcke ausgedrückt wird.
- Studioqualität ohne externen Upsampler: AudioVAE V2 hat ein asymmetrisches Design — Codierung bei 16 kHz und Rekonstruktion bei 48 kHz —, das implizite Superauflösung direkt in den Decoder einbaut.
- Vollständige Offenheit und kommerzielle Nutzung: Gewichte und Code unter Apache-2.0, laut README „free for commercial use”. Das README enthält einen Abschnitt „Risks and Limitations”, der die Nutzung für Identitätsdiebstahl, Betrug oder Desinformation explizit verbietet und die Kennzeichnung generierter Inhalte empfiehlt.
Wie es funktioniert
Die Architektur von VoxCPM2 folgt vier Stufen, die im latenten Raum von AudioVAE V2 operieren: LocEnc (lokaler Encoder, verschmilzt Text und optionales Referenzaudio); TSLM (das autoregressive Sprachmodell, ein 2B-Parameter-MiniCPM-4-Backbone, entscheidet bei 6,25 Hz, welcher Audio-„Patch” als Nächstes kommt); RALM (residuales autoregressives Sprachmodell, ein zweiter Durchgang, der jeden Patch mit prosodischem Detail verfeinert); LocDiT (ein Diffusionsschätzer, der das Audio-Latent malt, decodiert von AudioVAE V2 auf 48 kHz).
Die vier dokumentierten Generierungsmodi: Text-to-Speech (model.generate(text=...)); Voice Design (die Beschreibung steht in Klammern am Anfang des Textes, kein Referenzaudio erforderlich); Controllable Voice Cloning (übergibt reference_wav_path, einen 5–30-Sekunden-Clip, mit optionalen Stilanweisungen); Ultimate Cloning (übergibt prompt_wav_path und prompt_text, die exakte Transkription des Clips).
Es gibt außerdem eine Streaming-API (model.generate_streaming) und eine CLI (voxcpm design, voxcpm clone, voxcpm batch) mit Unterstützung für Zeitstempel auf Wort- oder Zeichenebene. Das README berichtet RTF ~0,30 auf einer NVIDIA RTX 4090 mit Standard-PyTorch, ~0,13 mit Nano-vLLM und ~1,76 (Q8_0) auf Apple M4 Pro / Metal via llama.cpp-omni. VRAM: ~8 GB für VoxCPM2.
Das Ökosystem
Das README führt eine offizielle Ökosystem-Tabelle (Community-Projekte, nicht von OpenBMB gepflegt). Inferenz- und Deployment-Engines: vllm-project/vllm-omni (die omni-modale Erweiterung des offiziellen vLLM-Projekts mit nativer VoxCPM2-Unterstützung, einem OpenAI-kompatiblen Endpunkt; 6.263 Sterne — das relevanteste halboffizielle Deployment, veröffentlicht von der vLLM-Organisation, nicht von OpenBMB); a710128/nanovllm-voxcpm (292 Sterne, RTF ~0,13 auf einer 4090); tc-mb/llama.cpp-omni (253 Sterne, native GGUF-Unterstützung auf CPU/Metal/CUDA/Vulkan); bluryar/VoxCPM.cpp (89 Sterne); 0xShug0/audio.cpp (1.957 Sterne, ein einheitliches C++-Framework für mehrere Audiomodelle).
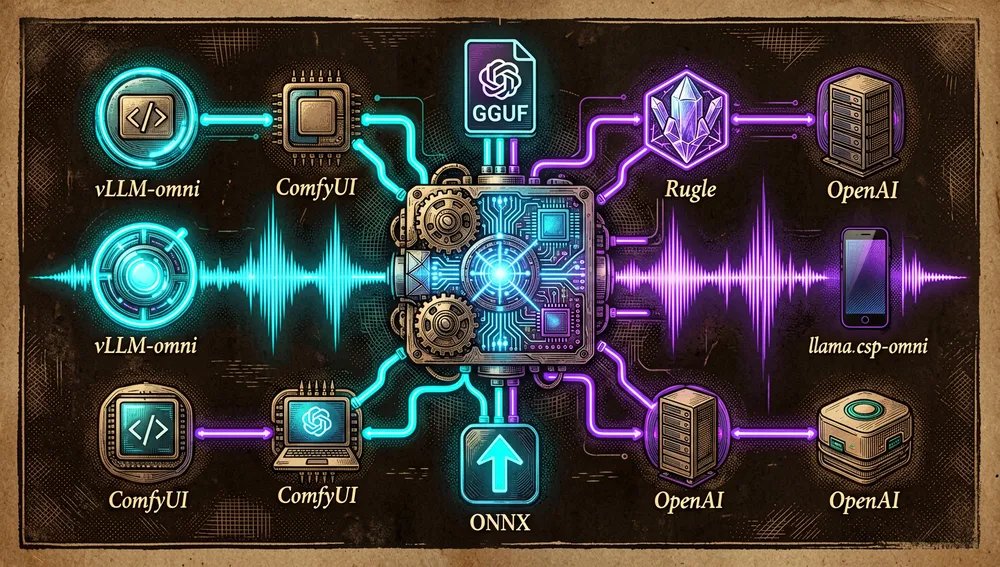
Community-Schnittstellen und Anwendungen: ComfyUI-Nodes (wildminder/ComfyUI-VoxCPM, 509 Sterne; Saganaki22/ComfyUI-VoxCPM2, 195); liuzhao1225/YouDub-webui (5.345 Sterne, ein Video-Lokalisierungstool mit Stimmklon-Synchronisation — der größte Adoptionsfall als Engine innerhalb einer anderen Anwendung); maomao-2001/Whispera (100 Sterne, Echtzeitgespräch mit Streaming-TTS).
Offizieller / halboffizieller Status
- vLLM-Omni veröffentlicht native VoxCPM2-Unterstützung mit Deployment-Beispielen im eigenen Repository: Dies ist eine Übernahme durch das offizielle vLLM-Projekt, was in der Praxis bedeutet, dass VoxCPM2 mit derselben Infrastruktur wie die am stärksten frequentierten Sprachmodelle bereitgestellt werden kann, mit einer OpenAI-kompatiblen API.
- ICLR 2026: Das README verlinkt die Begutachtung von VoxCPM-0.5B auf OpenReview unter „ICLR 2026”. Die Annahme konnte in diesem Durchlauf nicht direkt verifiziert werden; sie wird als der vom Projekt selbst erklärte Status zitiert.
- Das README erklärt, VoxCPM-0.5B sei Platz 1 im HuggingFace-Trending und VoxCPM1.5 Platz 1 im GitHub-Trending gewesen. Dies sind Behauptungen des README selbst.
- Es gibt keinen offiziellen Marketplace im Sinne von Agenten: Der De-facto-Status ist eher der einer Referenz für lokales mehrsprachiges TTS, verstärkt durch die Präsenz auf PyPI, HuggingFace, ModelScope und dem Engine-Ökosystem.
Schnellstart-Anleitung
Installation und erster Start
Dokumentierte Voraussetzungen: Python ≥ 3.10 und < 3.13, PyTorch ≥ 2.5.0, CUDA ≥ 12.0 für eine NVIDIA-GPU. VoxCPM2 nutzt ~8 GB VRAM.
pip install voxcpmErster Start (Python-API):
from voxcpm import VoxCPM
import soundfile as sf

model = VoxCPM.from_pretrained(
  "openbmb/VoxCPM2",
  load_denoiser=False,
)
wav = model.generate(
    text="VoxCPM2 is the current recommended release for realistic multilingual speech synthesis.",
    cfg_value=2.0,
    inference_timesteps=10,
    seed=42,
)
sf.write("demo.wav", wav, model.tts_model.sample_rate)
Der erste Aufruf lädt die Gewichte von HuggingFace herunter. Alternative: python app.py --port 8808 öffnet eine Web-Demo unter http://localhost:8808, mit --device auto|cpu|mps|cuda|cuda:N.
Häufige Workflows
- Eine Stimme ohne Referenzaudio entwerfen:
voxcpm design --text "..." --control "Young female voice, warm and gentle" --seed 42 --output out.wav. - Eine Stimme aus einem kurzen Clip klonen:
voxcpm clone --text "..." --reference-audio voice.wav --output out.wav. - Klonen mit maximaler Wiedergabetreue:
prompt_wav_pathmit dem Clip übergeben,prompt_textmit seiner exakten Transkription und optional denselben Clip inreference_wav_path. - Batches:
voxcpm batch --input examples/input.txt --output-dir outs. Mit Zeitstempeln:pip install "voxcpm[timestamps]"und--timestamps --timestamp-level word. - In Produktion bereitstellen:
vllm serve openbmb/VoxCPM2 --omni --port 8000stelltPOST /v1/audio/speechbereit, kompatibel mit OpenAI-Clients. - Fine-Tuning (5–10 Minuten Audio reichen aus):
python scripts/train_voxcpm_finetune.py --config_path conf/voxcpm_v2/voxcpm_finetune_lora.yaml.
Wesentliche Konfiguration
cfg_value: Diffusions-Guidance-Skala; das README verwendet 2,0.inference_timesteps: Anzahl der Diffusionsschritte; das README verwendet 10.seed: Zufallssaat für Reproduzierbarkeit; ohne sie können Voice Design und kontrollierbares Klonen zwischen Läufen variieren.load_denoiser: aktiviert den Denoiser für Referenzaudio; bei Nichtbedarf wirdFalseempfohlen.optimize:optimize=Falsedeaktivierttorch.compile; empfohlen bei Triton-/torch.compile-Fehlern.
Häufige Stolperfallen und Lösungen
- Triton-Fehler unter Windows: Triton vom Community-Projekt
triton-windowsinstallieren und PyTorch↔Triton-Versionen abstimmen; bei anhaltenden Problemenoptimize=False. libtorchcodeclädt nicht: torchaudio ≥ 2.9 erfordert installiertes FFmpeg; Alternative:torchaudio.set_audio_backend("soundfile").torch.compile-Fehler beim ersten Start: mitoptimize=Falsedeaktivieren.- MPS auf Apple Silicon: bei Fehler
device="cpu"erzwingen. - Python 3.14+: Die Installation kann fehlschlagen; 3.10–3.12 verwenden.
- Stimmabschneidung am Wortende (offenes Issue mit 51 Kommentaren): ein bekanntes, im Repository dokumentiertes Problem.
Integrationen und Migration
vLLM-Omni: der Weg zur Integration in bestehende Serving-Infrastruktur. ComfyUI: mehrere Community-Nodes. TTS WebUI: eine verfügbare Erweiterung. llama.cpp-omni: für On-Device-Deployment ohne Python. Migration von Cloud-APIs: Der Blog von Soniqo (Mai 2026) rahmt die Migration von ElevenLabs — gleiche 48-kHz-Ausgabe, textbasiertes Voice Design, aber lokal und ohne Kosten pro Aufruf.
Repo-Zahlen
Gemessen: 23. August 2026, GitHub-API.
| Metrik | Wert |
|---|---|
| Sterne | 35.986 |
| Forks | 4.114 |
| Abonnenten | 155 |
| Commits | 162 |
| Offene Issues | 114 |
| Primäre Sprache | Python |
| Lizenz | Apache-2.0 |
| Erstellt | 16. September 2025 |
| Neueste Veröffentlichung | 2.0.3, 11. Mai 2026 |
Top-Beitragende: Labmem-Zhouyx (29), a710128 (16), liuxin99 (13), VoxInstruct (11), ZMXJJ (5). PyPI (voxcpm 2.0.3): 2.794 Downloads am letzten Tag, 101.622 im letzten Monat. HuggingFace: openbmb/VoxCPM2 verzeichnet 327.211 Downloads und 1.542 „Gefällt mir”.
Wie die Community reagierte
Hacker News: Die Haupteinreichung, „VoxCPM: Tokenizer-Free TTS for Context-Aware Speech Generation and Voice Cloning” (5. Dezember 2025), erhielt 3 Punkte und 0 Kommentare. Es gibt keinen breiten Launch-Thread auf HN.
GitHub (Issues): Das aktivste Issue ist „Voice cutoff at the end of words — Polish language” (offen, 51 Kommentare); das torchcodec-Issue (geschlossen, 26 Kommentare). Das Issue „When is VoxCPM2 getting released?” (12 Kommentare) zeigt die Erwartung vor der Veröffentlichung.
YouTube: „VoxCPM 2 Review - 2026 | Clone Realistic AI Voice in 30+ Languages” (57.828 Aufrufe, Dan - Smart Tutorials); „VoxCPM 2 Review” (38.336 Aufrufe, Bijan Bowen); ein spanischsprachiges Video, „¿El fin de ElevenLabs? OmniVoice vs VoxCPM2” (15.580 Aufrufe). Rezensionen rahmen es durchgängig als lokal-vs-ElevenLabs.
Drittanbieter-Blog: Soniqo (17. Mai 2026) veröffentlichte eine technische Analyse der Pipeline und eine Vergleichstabelle mit ElevenLabs und kam zu dem Schluss, der eigentliche Unterschied sei, „ob das Audio das Gerät verlässt oder nicht”.
VoxCPM im Vergleich zu anderen Angeboten
| Projekt | Verifizierbare Überschneidung | Verifizierbarer Unterschied |
|---|---|---|
| ElevenLabs | Stimmklonen, textbasiertes Voice Design, 48-kHz-Ausgabe, mehrsprachige Abdeckung. | Proprietär und gehostet: Audio wird auf ihre Server hochgeladen, Kosten pro Zeichen, keine lokalen Gewichte. |
| CosyVoice / CosyVoice3 | Open-Source-TTS mit Klonen; CosyVoice trägt die LocDiT-Flow-Matching-Implementierung bei, die VoxCPM2 nutzt. | CosyVoice hat tokenisierte Architektur, und Version 3 ist geschlossen; VoxCPM2 ist tokenizer-frei und deckt 30 Sprachen ab. |
| Qwen3-TTS (1,7B) | Open-Source-TTS, verglichen in den eigenen Tabellen des README. | Schlägt VoxCPM2 bei englischem WER in selbstberichteten Tabellen. |
| FishAudio S2 (4B) | Direkt in den Benchmarks des README verglichen. | Besseres WER insgesamt; VoxCPM2 übertrifft Fish bei SIM in fast allen Minimax-MLS-Sprachen. |
Das strukturelle, verifizierbare Unterscheidungsmerkmal gegenüber den meisten Alternativen: native 48-kHz-Ausgabe ohne diskreten Tokenizer + Voice Design + kontrollierbares Klonen in einem einzigen 2B-Backbone unter Apache-2.0.
Anwendungsfälle und wem dieses Repository helfen kann
- Entwickler, die lokales mehrsprachiges TTS benötigen: Ein einziges Apache-2.0-Modell deckt 30 Sprachen mit der Standard-Python-API ab, ohne Kosten pro Zeichen und ohne Netzwerkabhängigkeit.
- Produktteams mit Datenschutz- oder Offline-Anforderungen: On-Device-Klonen bedeutet, dass Audio das Gerät nie verlässt.
- Hochfrequentierte Serving-Plattformen: Mit vLLM-Omni wird VoxCPM2 mit PagedAttention und kontinuierlichem Batching hinter einem OpenAI-kompatiblen Endpunkt bereitgestellt.
- Content-Ersteller und Animationsstudios: ComfyUI-Nodes integrieren die Synthese in knotenbasierte Pipelines; YouDub-webui nutzt es als Synchronisations-Engine.
- Forscher und Teams, die Sprachmodelle feintunen: dokumentiertes SFT/LoRA-Fine-Tuning ermöglicht die Anpassung des Modells an einen bestimmten Sprecher, eine Sprache oder eine Domäne.
- Nutzer auf Consumer- und Edge-Hardware: Die llama.cpp-omni-Binary und GGUF-Gewichte erweitern die Nutzung auf Laptops ohne NVIDIA-GPU.
Ressourcen
- Repository: https://github.com/OpenBMB/VoxCPM
- Dokumentation: https://voxcpm.readthedocs.io/en/latest/
- Modelle: https://huggingface.co/openbmb/VoxCPM2
- Playground: https://huggingface.co/spaces/OpenBMB/VoxCPM-Demo
- Technischer Bericht (VoxCPM2): https://arxiv.org/abs/2606.06928
- Community: Discord https://discord.gg/KZUx7tVNwz
- Offizielle Website: https://voxcpm.com
Hinweis: Dieser Artikel fasst das README, die ReadTheDocs-FAQ, Releases und die GitHub-API von OpenBMB/VoxCPM, PyPI- und HuggingFace-Zähler, die Hacker-News-API, eine YouTube-Suche und den Blog von Soniqo zusammen, abgerufen am 23. August 2026. Benchmark-Zahlen sind von OpenBMB selbst berichtet. Zahlen ändern sich mit der Zeit.
Kommentare