

VoxCPM: síntesis de voz multilingüe sin tokenizador
OpenBMB/VoxCPM · 37.974★ · 4.314 forks
Todo lo que hay que saber sobre OpenBMB/VoxCPM: un sistema de text-to-speech de código abierto y pesos abiertos que genera audio continuo directamente, sin tokenización discreta, y cuya versión 2 soporta 30 idiomas, diseño de voz por descripción y clonación con 48 kHz.
Qué es VoxCPM
VoxCPM es un sistema de síntesis de voz (TTS) sin tokenizador (tokenizer-free): en lugar de convertir el audio en un vocabulario de tokens discretos y luego decodificarlos, genera representaciones continuas de audio de forma directa mediante una arquitectura difusión autorregresiva de extremo a extremo. El producto es un modelo de pesos abiertos (Apache-2.0) con su API de Python, CLI y demostración web.
La versión actual es VoxCPM2, un modelo de 2B parámetros entrenado con más de 2 millones de horas de habla multilingüe, que soporta 30 idiomas y 9 dialectos del chino, Voice Design (crear una voz nueva a partir de una descripción en lenguaje natural, sin audio de referencia), clonación controlable (clonar una voz desde un clip corto y ajustar estilo, ritmo y emoción) y clonación de máxima fidelidad por continuación de audio, con salida nativa de 48 kHz. Está construida sobre el esqueleto de MiniCPM-4 de la misma organización.
Origen
El repositorio fue creado el 16 de septiembre de 2025 por la organización OpenBMB, el equipo de modelos MiniCPM de ModelBest (empresa china) en colaboración con THUHCSI (grupo de investigación de la Universidad Tsinghua).
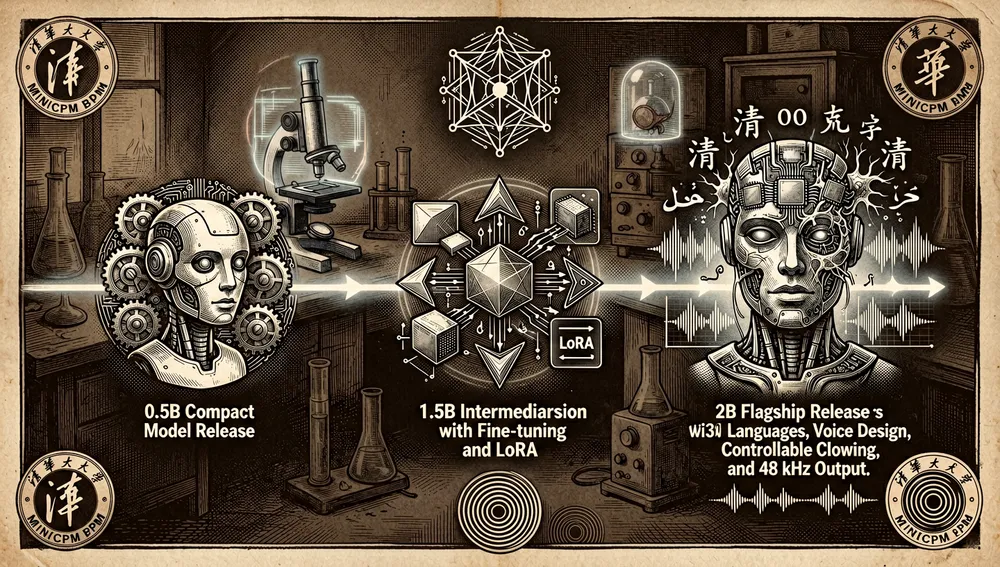
La cronología que documenta el propio README: septiembre de 2025, publicación del informe técnico de VoxCPM y lanzamiento del modelo VoxCPM-0.5B, que alcanzó el número 1 del trending de HuggingFace (dato del README); 5 de diciembre de 2025, publicación de los pesos de VoxCPM1.5 con ajuste fino SFT y LoRA, número 1 del trending de GitHub (dato del README); 6 de abril de 2026, lanzamiento de VoxCPM2 — 2B, 30 idiomas, Voice Design y clonación controlable, salida a 48 kHz — con informe técnico en arXiv.
La línea de trabajo es una extensión de la familia MiniCPM (10.222 estrellas), con la que comparte filosofía de modelos pequeños y capaces que se ejecutan localmente. El README agradece explícitamente a DiTAR por el esqueleto de difusión autorregresiva, a CosyVoice (FunAudioLLM) por la implementación de Flow Matching de LocDiT y a DAC (descript-audio-codec) por el backbone del VAE de audio.
Filosofía y principios
El informe técnico y el README dejan ver cuatro decisiones de diseño coherentes:
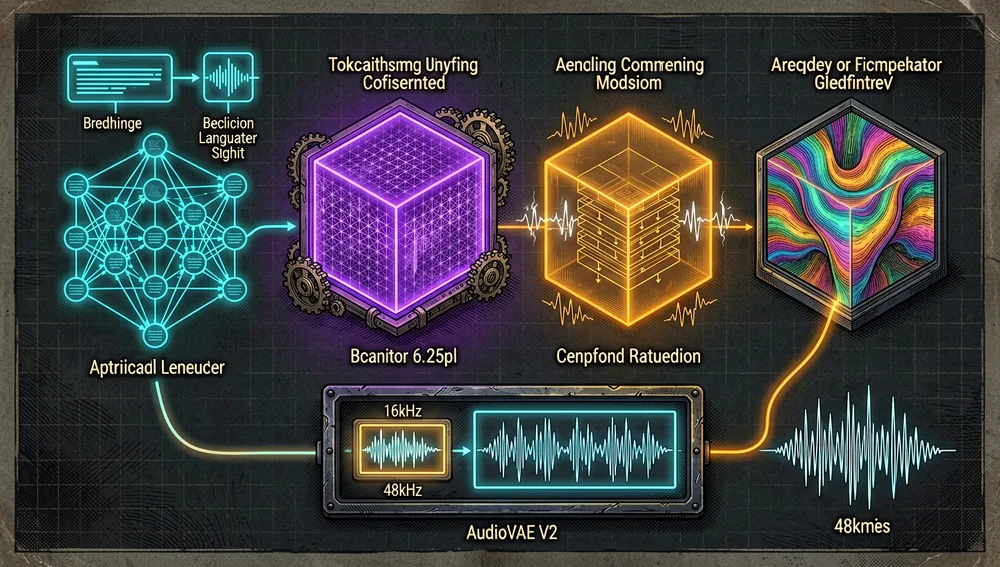
- Sin tokenización discreta: el modelo opera íntegramente en el espacio latente del AudioVAE V2 y «pinta» el audio con un paso de difusión (LocDiT) en cada posición, en vez de elegir entre tokens cuantizados. El argumento es que un cuantizador discreto introduce un cuello de botella de calidad; sin él, el VAE puede reconstruir directamente a 48 kHz.
- Un modelo, varios modos: el informe técnico describe una «organización unificada de secuencia» donde todos los modos de generación (texto a voz, diseño de voz, clonación con referencia, clonación por continuación) se expresan como distintas disposiciones de los mismos bloques de entrada.
- Calidad de estudio sin upsampler externo: el AudioVAE V2 tiene un diseño asimétrico de codificar a 16 kHz y reconstruir a 48 kHz, lo que incorpora super-resolución implícita en el propio decodificador.
- Apertura total y uso comercial: pesos y código bajo Apache-2.0, «free for commercial use» según el README. El README incluye una sección «Risks and Limitations» que prohíbe explícitamente el uso para suplantación, fraude o desinformación y recomienda etiquetar el contenido generado.
Cómo funciona
La arquitectura de VoxCPM2 sigue cuatro etapas que operan en el espacio latente de AudioVAE V2: LocEnc (encoder local, fusiona texto y audio de referencia opcional); TSLM (el modelo de lenguaje autorregresivo, backbone MiniCPM-4 de 2B parámetros, decide qué «parche» de audio viene a continuación, a 6,25 Hz); RALM (residual autoregressive language model, un segundo pase que refina cada parche con detalle prosódico); LocDiT (un estimador de difusión que pinta el latente de audio, decodificado por AudioVAE V2 a 48 kHz).
Los cuatro modos de generación: Text-to-Speech (model.generate(text=...)); Voice Design (la descripción va entre paréntesis al inicio del texto, sin audio de referencia); Controllable Voice Cloning (se pasa reference_wav_path, un clip de 5–30 s, con instrucciones de estilo opcionales); Ultimate Cloning (se pasa prompt_wav_path y prompt_text, la transcripción exacta del clip).
Hay además API de streaming (model.generate_streaming) y un CLI (voxcpm design, voxcpm clone, voxcpm batch) con soporte de marcas de tiempo por palabra o carácter. El README reporta RTF ~0,30 en NVIDIA RTX 4090 con PyTorch estándar, ~0,13 con Nano-vLLM, y ~1,76 (Q8_0) en Apple M4 Pro / Metal vía llama.cpp-omni. VRAM: ~8 GB para VoxCPM2.
El ecosistema
El README mantiene una tabla de ecosistema oficial (proyectos de comunidad, no mantenidos por OpenBMB). Motores de inferencia y despliegue: vllm-project/vllm-omni (extensión omni-modal del proyecto oficial vLLM con soporte nativo de VoxCPM2, endpoint compatible con OpenAI; 6.263 estrellas — el despliegue semi-oficial más relevante); a710128/nanovllm-voxcpm (292 estrellas, RTF ~0,13 en 4090); tc-mb/llama.cpp-omni (253 estrellas, soporte nativo de GGUF en CPU/Metal/CUDA/Vulkan); bluryar/VoxCPM.cpp (89 estrellas); 0xShug0/audio.cpp (1.957 estrellas, marco C++ unificado para varios modelos de audio).
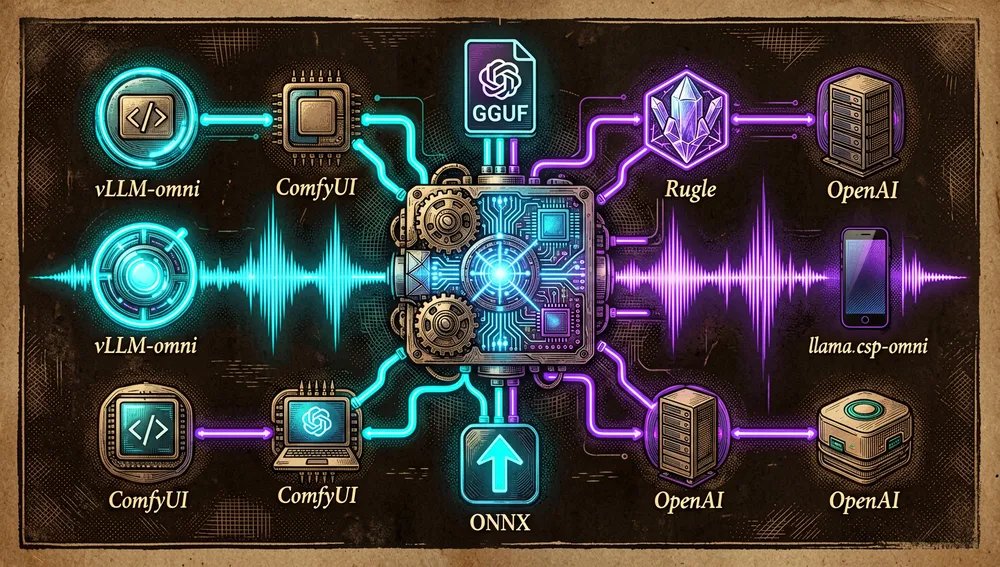
Interfaces y aplicaciones de la comunidad: nodos de ComfyUI (wildminder/ComfyUI-VoxCPM, 509 estrellas; Saganaki22/ComfyUI-VoxCPM2, 195); liuzhao1225/YouDub-webui (5.345 estrellas, herramienta de localización de videos con doblaje por clonación de voz — el caso más grande de adopción como motor dentro de otra aplicación); maomao-2001/Whispera (100 estrellas, conversación en tiempo real con TTS de streaming).
Estado oficial / semioficial
- vLLM-Omni publica soporte nativo de VoxCPM2 con ejemplos de despliegue en su propio repositorio: es una adopción por parte del proyecto oficial de vLLM, lo que significa en la práctica que VoxCPM2 puede servirse con la misma infraestructura que los modelos de lenguaje de mayor tráfico, con API compatible con OpenAI.
- ICLR 2026: el README enlaza la revisión de VoxCPM-0.5B en OpenReview bajo «ICLR 2026». La aceptación no pudo verificarse directamente en esta investigación; se cita como el estado que declara el propio proyecto.
- El README declara que VoxCPM-0.5B fue número 1 del trending de HuggingFace y VoxCPM1.5 número 1 del trending de GitHub. Son afirmaciones del propio README.
- No existe un marketplace oficial en el sentido de agentes: el estado de facto es más bien de referencia para TTS local multilingüe, reforzada por la presencia en PyPI, HuggingFace, ModelScope y el ecosistema de motores.
Guía rápida de uso
Instalación y primer arranque
Prerrequisitos: Python ≥ 3.10 y < 3.13, PyTorch ≥ 2.5.0, CUDA ≥ 12.0 para GPU NVIDIA. VoxCPM2 ocupa ~8 GB de VRAM.
pip install voxcpmPrimer arranque (API de Python):
from voxcpm import VoxCPM
import soundfile as sf

model = VoxCPM.from_pretrained(
  "openbmb/VoxCPM2",
  load_denoiser=False,
)
wav = model.generate(
    text="VoxCPM2 is the current recommended release for realistic multilingual speech synthesis.",
    cfg_value=2.0,
    inference_timesteps=10,
    seed=42,
)
sf.write("demo.wav", wav, model.tts_model.sample_rate)
La primera llamada descarga los pesos desde HuggingFace. Alternativa: python app.py --port 8808 abre una demo web en http://localhost:8808, con --device auto|cpu|mps|cuda|cuda:N.
Flujos de trabajo habituales
- Diseñar una voz sin audio de referencia:
voxcpm design --text "..." --control "Young female voice, warm and gentle" --seed 42 --output out.wav. - Clonar una voz desde un clip corto:
voxcpm clone --text "..." --reference-audio voice.wav --output out.wav. - Clonación de máxima fidelidad: se pasa
prompt_wav_pathcon el clip,prompt_textcon su transcripción exacta y, opcionalmente, el mismo clip enreference_wav_path. - Lotes:
voxcpm batch --input examples/input.txt --output-dir outs. Con marcas de tiempo:pip install "voxcpm[timestamps]"y--timestamps --timestamp-level word. - Servir en producción:
vllm serve openbmb/VoxCPM2 --omni --port 8000exponePOST /v1/audio/speechcompatible con clientes de OpenAI. - Ajuste fino (5–10 minutos de audio bastan):
python scripts/train_voxcpm_finetune.py --config_path conf/voxcpm_v2/voxcpm_finetune_lora.yaml.
Configuración esencial
cfg_value: escala de guía de la difusión; el README usa 2,0.inference_timesteps: número de pasos de difusión; el README usa 10.seed: semilla para reproducibilidad; sin ella, Voice Design y clonación controlable pueden variar entre ejecuciones.load_denoiser: activa el denoizador para el audio de referencia; se recomiendaFalsecuando no se necesite.optimize:optimize=Falsedesactivatorch.compile; recomendado ante errores de Triton/torch.compile.
Trampas frecuentes y soluciones
- Errores de Triton en Windows: instalar Triton del proyecto comunitario
triton-windowsy emparejar versiones PyTorch↔Triton; si persiste,optimize=False. libtorchcodecno se carga: torchaudio ≥ 2.9 requiere FFmpeg instalado; alternativa:torchaudio.set_audio_backend("soundfile").- Errores de
torch.compileen el primer arranque: desactivarlo conoptimize=False. - MPS en Apple Silicon: si hay error, forzar
device="cpu". - Python 3.14+: la instalación puede fallar; usar 3.10–3.12.
- Recorte de voz al final de palabras (issue abierto con 51 comentarios): problema conocido documentado en el repositorio.
Integraciones y migración
vLLM-Omni: la vía para integrarlo en infraestructura de serving existente. ComfyUI: varios nodos comunitarios. TTS WebUI: extensión disponible. llama.cpp-omni: para despliegue en dispositivo sin Python. Migración desde APIs en la nube: el blog de Soniqo (mayo de 2026) enmarca la migración desde ElevenLabs — misma salida a 48 kHz, diseño de voz por texto, pero local y sin coste por llamada.
Números del repo
Medición: 23 de agosto de 2026, API de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 35.986 |
| Bifurcaciones | 4.114 |
| Suscriptores | 155 |
| Commits | 162 |
| Incidencias abiertas | 114 |
| Lenguaje principal | Python |
| Licencia | Apache-2.0 |
| Creación | 16 de septiembre de 2025 |
| Última publicación | 2.0.3, 11 de mayo de 2026 |
Principales contribuidores: Labmem-Zhouyx (29), a710128 (16), liuxin99 (13), VoxInstruct (11), ZMXJJ (5). PyPI (voxcpm 2.0.3): 2.794 descargas en el último día, 101.622 en el último mes. HuggingFace: openbmb/VoxCPM2 registra 327.211 descargas y 1.542 «me gusta».
Cómo lo recibió la comunidad
Hacker News: el envío principal, «VoxCPM: Tokenizer-Free TTS for Context-Aware Speech Generation and Voice Cloning» (5 de diciembre de 2025), obtuvo 3 puntos y 0 comentarios. No existe un hilo amplio de lanzamiento en HN.
GitHub (issues): el issue con más actividad es «Voice cutoff at the end of words — Polish language» (abierto, 51 comentarios); el issue sobre torchcodec (cerrado, 26 comentarios). El issue «When is VoxCPM2 getting released?» (12 comentarios) muestra la expectación previa al lanzamiento.
YouTube: «VoxCPM 2 Review - 2026 | Clone Realistic AI Voice in 30+ Languages» (57.828 vistas, Dan - Smart Tutorials); «VoxCPM 2 Review» (38.336 vistas, Bijan Bowen); un video en español, «¿El fin de ElevenLabs? OmniVoice vs VoxCPM2» (15.580 vistas). Las reseñas se enmarcan consistentemente en la comparación local-vs-ElevenLabs.
Blog de terceros: Soniqo (17 de mayo de 2026) publicó un análisis técnico del pipeline y una tabla comparativa frente a ElevenLabs; concluye que la diferencia real «es si el audio sale o no del dispositivo».
VoxCPM frente a otras propuestas
| Proyecto | Coincidencia verificable | Diferencia verificable |
|---|---|---|
| ElevenLabs | Clonación de voz, diseño de voz por texto, salida 48 kHz, cobertura multilingüe. | Propietaria y alojada: el audio sube a sus servidores, coste por carácter, sin pesos locales. |
| CosyVoice / CosyVoice3 | TTS open-source con clonación; CosyVoice aporta la implementación Flow Matching de LocDiT que usa VoxCPM2. | CosyVoice es de arquitectura tokenizada y su versión 3 es cerrada; VoxCPM2 es tokenizer-free y cubre 30 idiomas. |
| Qwen3-TTS (1,7B) | TTS open-source comparado en las tablas del propio README. | Supera a VoxCPM2 en WER de inglés en las tablas autorreportadas. |
| FishAudio S2 (4B) | Comparado directamente en los benchmarks del README. | Mejor WER general; VoxCPM2 supera a Fish en SIM en casi todos los idiomas. |
La diferenciación estructural verificable frente a la mayoría: salida nativa 48 kHz sin tokenizador discreto + diseño de voz + clonación controlable en un único backbone de 2B bajo Apache-2.0.
Casos de uso y a quién puede ayudar este repositorio
- Desarrolladores que necesitan TTS local multilingüe: un único modelo Apache-2.0 cubre 30 idiomas con la API de Python estándar, sin coste por carácter ni dependencia de red.
- Equipos de producto con requisitos de privacidad u offline: la clonación en dispositivo permite que el audio nunca salga del equipo.
- Plataformas de serving de alto tráfico: con vLLM-Omni, VoxCPM2 se sirve con PagedAttention y batching continuo detrás de un endpoint compatible con OpenAI.
- Creadores de contenido y estudios de animación: los nodos de ComfyUI integran la síntesis en flujos por nodos; YouDub-webui lo usa como motor de doblaje.
- Investigadores y equipos que ajustan modelos de voz: el ajuste fino SFT/LoRA documentado permite adaptar el modelo a un hablante, idioma o dominio específico.
- Usuarios en hardware de consumo y edge: el binario de llama.cpp-omni y los pesos GGUF abren el uso a portátiles sin GPU NVIDIA.
Recursos
- Repositorio: https://github.com/OpenBMB/VoxCPM
- Documentación: https://voxcpm.readthedocs.io/en/latest/
- Modelos: https://huggingface.co/openbmb/VoxCPM2
- Playground: https://huggingface.co/spaces/OpenBMB/VoxCPM-Demo
- Informe técnico (VoxCPM2): https://arxiv.org/abs/2606.06928
- Comunidad: Discord https://discord.gg/KZUx7tVNwz
- Página oficial: https://voxcpm.com
Nota: este artículo combina el README, la FAQ de ReadTheDocs, los releases y la API de GitHub de OpenBMB/VoxCPM, los contadores de PyPI y HuggingFace, la API de Hacker News, una búsqueda de YouTube y el blog de Soniqo, consultados el 23 de agosto de 2026. Las cifras de benchmarks son autorreportadas por OpenBMB. Las cifras cambian con el tiempo.
Comentarios