

bitnet.cpp: inferencia local para modelos de lenguaje ternarios
microsoft/BitNet · 40.348★ · 3.740 forks
Todo lo que hay que saber sobre microsoft/BitNet: el marco oficial de Microsoft para ejecutar modelos de lenguaje de 1,58 bits con núcleos optimizados en CPU y GPU.
Qué es BitNet
bitnet.cpp es el marco oficial de inferencia de Microsoft para modelos de lenguaje de 1 bit, en particular BitNet b1.58. Su propósito es ejecutar pesos ternarios y activaciones cuantizadas mediante núcleos especializados, no convertir después de entrenar un modelo convencional a una cuantización arbitraria.
El proyecto cubre generación conversacional y, desde julio de 2026, modelos de incrustaciones multilingües. Estos últimos producen vectores densos para recuperación, agrupación, similitud semántica, clasificación, minería de textos paralelos y reordenación.
El origen: de una línea de investigación a un motor de inferencia
La investigación que precede al repositorio se remonta al artículo inicial sobre BitNet, publicado el 17 de octubre de 2023; el README sitúa la presentación de BitNet b1.58 el 27 de febrero de 2024. El repositorio microsoft/BitNet se creó el 5 de agosto de 2024 y su versión 1.0 se anunció el 17 de octubre de ese año.
El contexto técnico es una tensión entre el interés de los pesos ternarios y la falta de una ruta práctica de inferencia en el borde. El informe de 2024 presenta una pila de software para inferencia rápida y sin pérdida de BitNet b1.58 en CPU, mientras que el informe de sistema de 2025 identifica la multiplicación matricial de precisión mixta como el coste dominante y propone las familias de núcleos TL e I2_S.
No se recuperó una publicación individual que atribuya el repositorio a una sola persona. La autoría verificable del informe de sistema incluye Jinheng Wang, Hansong Zhou, Ting Song, Shijie Cao, Yan Xia, Ting Cao, Jianyu Wei, Shuming Ma, Hongyu Wang y Furu Wei; la cuenta propietaria es la organización Microsoft.
Filosofía y principios
La propuesta no promete que cualquier LLM pueda convertirse sin coste en un modelo de 1 bit. Los modelos BitNet se entrenan con pesos ternarios {-1, 0, +1} y activaciones de 8 bits; los documentos de incrustaciones especifican que no se trata de cuantización posterior al entrenamiento.
Sus principios operativos son:
- Aprovechar la estructura ternaria desde el núcleo: I2_S empaqueta los pesos y TL usa tablas de consulta ternarias para reducir el trabajo y el movimiento de datos.
- Priorizar ejecución local eficiente: el informe de CPU comunica aceleraciones de 2,37× a 6,17× en x86 y de 1,37× a 5,07× en ARM frente a referencias de precisión completa, bajo sus configuraciones experimentales.
- Mantener una ruta interoperable: el proyecto se apoya en
llama.cppy sus operaciones I2_S se integran en su grafo de cálculo; no es un reemplazo aislado del ecosistema GGUF.
Cómo funciona
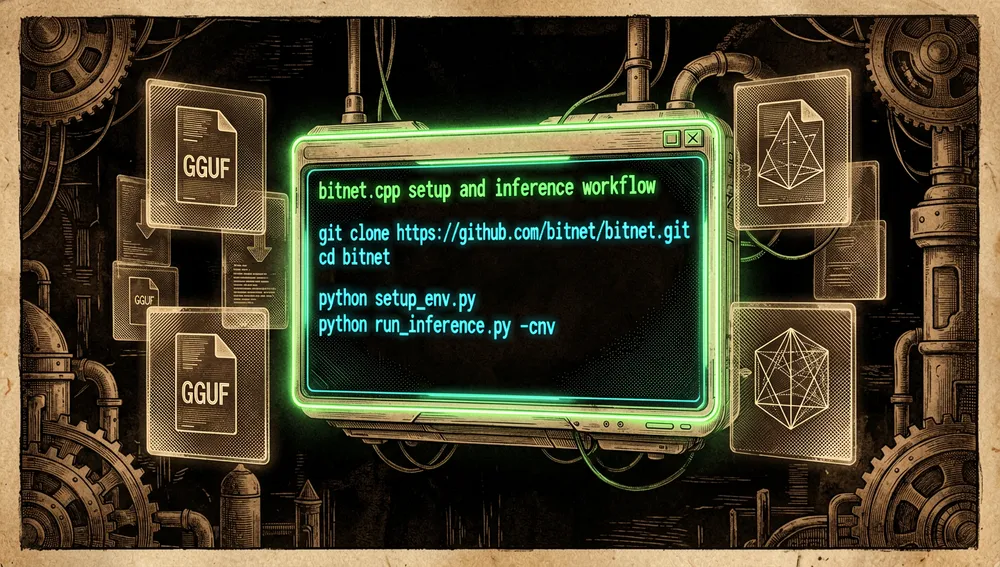
El flujo CPU habitual descarga un modelo GGUF compatible, compila el proyecto y ejecuta run_inference.py. El ejecutable acepta la ruta del modelo, una instrucción, número de tokens, hilos, contexto, temperatura y modo conversación.
En CPU, los núcleos paralelizan el cálculo de pesos y activaciones y permiten ajustar bloques y paralelismo en include/gemm-config.h. La documentación recomienda el paralelismo de activaciones para I2_S, pues amortiza el desempaquetado de pesos.
También existe una ruta GPU W2A8: un núcleo CUDA para producto matriz-vector con pesos de 2 bits y activaciones de 8 bits. La guía describe bloques de pesos de 16×32, empaquetado de valores de dos bits y uso de la instrucción dp4a; sus números son mediciones propias sobre una NVIDIA A100 de 40 GB, no una comparación independiente.
Estado oficial y semioficial
El repositorio se describe explícitamente como el marco oficial de inferencia de Microsoft para LLM de 1 bit. También enlaza modelos oficiales de Microsoft en Hugging Face, entre ellos BitNet-b1.58-2B-4T y dos modelos de incrustaciones.
Su estado semioficial respecto de llama.cpp es técnico, no institucional: el README declara que el proyecto se basa en ese marco y que sus núcleos se apoyan en las metodologías de T-MAC. No se recuperó evidencia de que BitNet haya sido incorporado como mercado, estándar formal o producto certificado por una tercera empresa.
El ecosistema
Componentes y modelos de Microsoft
microsoft/T-MAC: metodología de tablas de consulta que el README identifica como base de los núcleos de bitnet.cpp; para LLM de baja precisión generales recomienda T-MAC.microsoft/VibeASR.cpp: motor de reconocimiento de voz multilingüe en tiempo real sobre CPU que el README anunció el 23 de julio de 2026 y que usa cuantización BitNet I2_S.microsoft/BitNet-b1.58-2B-4T,microsoft/BitNet-embedding-0.6Bymicrosoft/BitNet-embedding-270M: modelos enlazados por el proyecto en Hugging Face. Los modelos de incrustaciones son multilingües y se documentan con recuperación, clasificación y otros flujos semánticos.
El repositorio no presenta un catálogo de componentes hermanos en su información principal; las relaciones documentadas de primera parte son T-MAC, VibeASR.cpp y los modelos enlazados arriba.
Adaptaciones comunitarias y proyectos relacionados
Beomi/BitNet-Transformers: implementación de BitNet para Hugging Face Transformers con arquitectura Llama; la búsqueda de GitHub devolvió 316 estrellas.Oxen-AI/BitNet-1.58-Instruct: implementación de ajuste de instrucciones para BitNet 1.58; 33 estrellas en la misma búsqueda.JohnMasen/BitNetSharp: implementación en C# de BitNet de Microsoft; 2 estrellas.Liminal-Commons/bitnet-mcp: envoltorio MCP para generación de texto mediante un servidorllamacon BitNet-b1.58-2B-4T; la búsqueda lo devolvió con 0 estrellas.
La búsqueda exacta también reveló bifurcaciones simples, como Scottcjn/BitNet con 66 estrellas. Se clasifica como bifurcación porque conserva la descripción del original; no se presenta como puerto independiente. No se recuperó una traducción no inglesa con relación explícita al repositorio.
Números del repo
Medición: 11 de agosto de 2026, API de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 39.973 |
| Bifurcaciones | 3.687 |
| Suscriptores reales | 349 |
| Commits | 110 |
| Incidencias abiertas indicadas por la API | 315 |
| Lenguaje principal | C++ |
| Licencia | MIT |
| Creación | 5 de agosto de 2024 |
| Último envío de código | 27 de julio de 2026 |
| Publicaciones de GitHub | No se recuperó ninguna publicación formal |
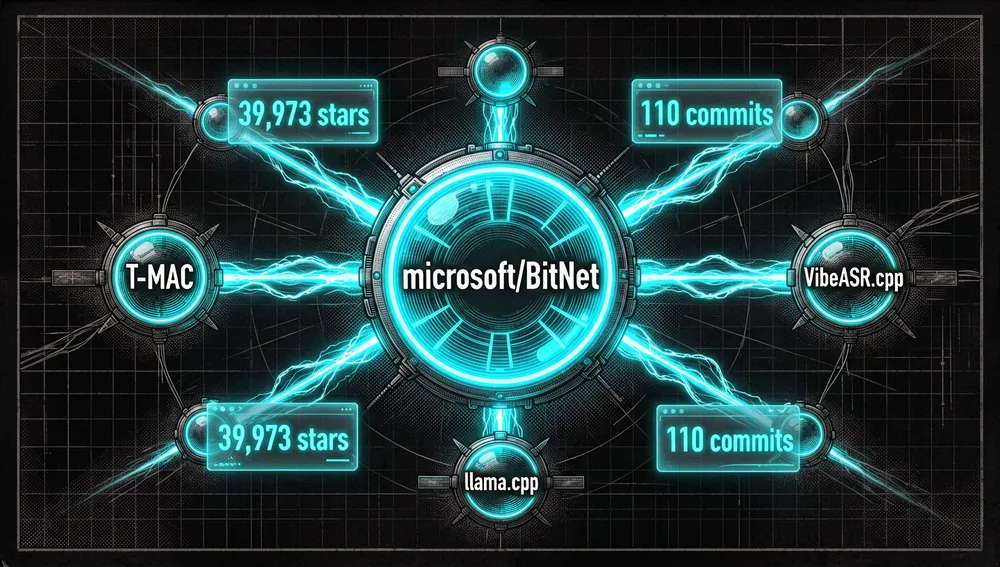
El total de 110 commits procede del último enlace de paginación de la API. open_issues_count puede incluir solicitudes de cambios abiertas. Asimismo, watchers_count repite las estrellas en la respuesta general de GitHub; por eso se informa subscribers_count como suscriptores reales.
Los principales contribuidores recuperados por la API, por número de contribuciones, son potassiummmm (19), tsong-ms (16), younesbelkada (15), isHuangXin (11) y XsquirrelC (7).
Cómo contribuir
No se recuperó una guía CONTRIBUTING.md ni una política específica de bifurcación, ramas o solicitudes de cambios. En la raíz sí aparecen un código de conducta y una política de seguridad, y la actividad de solicitudes de cambios muestra propuestas de la comunidad; eso acredita canales de colaboración, pero no equivale a un proceso de contribución documentado.
Guía rápida de uso
Instalación y primer arranque
- Se requieren Python 3.10 o posterior, CMake 3.22 o posterior, Clang 18 o posterior y, de forma recomendada, Conda.
- Clonar incluyendo submódulos y crear el entorno:
git clone --recursive https://github.com/microsoft/BitNet.git
cd BitNet
conda create -n bitnet-cpp python=3.10
conda activate bitnet-cpp
pip install -r requirements.txt- Descargar el modelo GGUF oficial y preparar la compilación:
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s
La preparación compila el proyecto; el primer resultado útil es el archivo GGUF en el directorio de modelos y los binarios construidos.
Flujos de trabajo habituales
- Conversación local:
python run_inference.py -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf -p "You are a helpful assistant" -cnvinicia el modo de conversación; la instrucción se usa como mensaje de sistema. - Prueba de rendimiento:
python utils/e2e_benchmark.py -m /path/to/model -n 200 -p 256 -t 4mide generación con 200 tokens, una instrucción de 256 tokens y cuatro hilos. - Conversión de pesos: tras descargar pesos
safetensors,python ./utils/convert-helper-bitnet.py ./models/bitnet-b1.58-2B-4T-bf16produce la variante GGUF. - Incrustaciones: con la rama de submódulo indicada en la guía,
./build/bin/llama-embedding -m /path/to/save/model/bitnet-embedding-0.6b/ggml-model-i2_s.gguf -p "query: What is BitNet?" --embd-normalize 2 --embd-output-format arraydevuelve un vector normalizado.
Configuración esencial
setup_env.py -md: indica el directorio local del modelo;-qseleccionai2_sotl1.run_inference.py -t,-cy-temp: controlan hilos, tamaño de contexto y temperatura.include/gemm-config.h: contieneROW_BLOCK_SIZE,COL_BLOCK_SIZEyPARALLEL_SIZEpara afinar el núcleo CPU según caché y arquitectura.--quant-embd: opción desetup_env.pypara convertir las incrustaciones a Q6_K.
Trampas frecuentes y soluciones
- La documentación actual usa
huggingface-cli; una solicitud de cambios reciente explica que las versiones nuevas dehuggingface_hubretiraron ese ejecutable y propone sustituirlo porhf. Si aparece “command not found”, es una incompatibilidad conocida de ese flujo documentado; use la interfaz disponible de Hugging Face o siga la corrección propuesta. - En Windows hay que usar la consola de desarrollador de Visual Studio 2022. Si
clangno se reconoce, el README indica inicializar las herramientas de Visual Studio antes de compilar. - El README registra errores de
std::chronoal construir el submódulollama.cppy remite a un commit concreto como solución. También existen incidencias de compilación con banderas no admitidas del compilador; no conviene asumir que cualquier GCC sustituye a la versión de Clang requerida. - En modelos de incrustaciones, la guía exige anteponer una instrucción a la consulta; omitirla degrada el rendimiento. No hace falta añadirla al documento.
Integraciones y migración
bitnet.cpp mantiene formatos y operaciones vinculadas a llama.cpp, y el propio proyecto lo presenta como base. Para cargas de trabajo de baja precisión que no sean modelos ternarios, el README dirige a T-MAC en vez de prometer compatibilidad universal.
La ruta MCP localizada en la búsqueda es comunitaria y envuelve llama-server; no es parte del repositorio de Microsoft. Para la ruta GPU, la guía oficial proporciona construcción y prueba del núcleo CUDA, además de un generador interactivo.
Cómo lo recibió la comunidad
Hay interés verificable, pero también objeciones concretas sobre la disponibilidad real de modelos grandes y el proceso de entrenamiento:
- El hilo de Hacker News 47334694, enviado por redm, enlazó directamente el repositorio y tenía 370 puntos y 167 comentarios. QuadmasterXLII cuestionó que el titular sugiriera cien mil millones de parámetros cuando los modelos oficiales no superaban diez mil millones; est respondió que no era una cuantización posterior y que el uso ternario debe existir desde el preentrenamiento.
- En el mismo hilo, 152334H pidió distinguir entre la capacidad del marco y la existencia de un modelo entrenado de 100B. Esa reserva encaja con el README: describe capacidad de ejecutar un modelo BitNet b1.58 de 100B en CPU, pero no enlaza un modelo oficial de ese tamaño.
- El hilo anterior 41877609, enviado por galeos, alcanzó 173 puntos y 33 comentarios. zamadatix explicó que “1,58 bits” proviene de tres valores posibles; swfsql opinó que la inferencia local es el mercado natural, aunque cuestionó el coste de entrenar sobre una arquitectura no BitNet. Son interpretaciones de usuarios, no resultados experimentales.
La exploración de Reddit devolvió un bloqueo 403 y Product Hunt también devolvió 403; por ello no se concluye ausencia de publicaciones.
La búsqueda de X se recuperó como una página de aplicación, pero no ofreció una publicación verificable de lanzamiento.
La búsqueda de podcasts mediante iTunes no aportó una coincidencia exacta verificable del repositorio.
La búsqueda de YouTube sí devolvió el tutorial de LLM Master Cursos incluido en Recursos; se verificó directamente su título y duración, pero no se recuperó un recuento de visualizaciones.
BitNet frente a otras propuestas
| Propuesta | Relación verificable | Diferencia verificable |
|---|---|---|
llama.cpp | bitnet.cpp se basa en este marco e integra I2_S en su grafo de cálculo. | BitNet aporta núcleos y formatos dirigidos a pesos ternarios; la fuente no acredita que todo llama.cpp sea una implementación de BitNet. |
microsoft/T-MAC | El README dice que las metodologías de T-MAC sustentan sus núcleos. | El mismo README recomienda T-MAC para inferencia de LLM de baja precisión más allá de modelos ternarios. |
Beomi/BitNet-Transformers | Implementa BitNet con Hugging Face Transformers y arquitectura Llama. | Es una implementación en PyTorch/Transformers encontrada en la búsqueda, no el marco oficial de inferencia C++ de Microsoft. |
Oxen-AI/BitNet-1.58-Instruct | Implementa ajuste de instrucciones para BitNet 1.58. | Se centra en ajuste de instrucciones; bitnet.cpp se centra en la inferencia y los núcleos. |
Casos de uso y a quién puede ayudar este repositorio
- Equipos que ejecutan LLM en equipos x86 o ARM pueden evaluar un modelo BitNet nativo para reducir coste energético y mejorar rendimiento de inferencia local, siempre contrastando los números del proyecto con su propio hardware y carga.
- Desarrolladores de asistentes locales pueden emplear el modo conversación, el control de hilos y de contexto, y el formato GGUF para construir una experiencia interactiva sin depender de un servicio remoto.
- Equipos de búsqueda semántica y RAG pueden usar las incrustaciones 0.6B o 270M y el ejecutable
llama-embeddingpara producir vectores normalizados en CPU. La guía documenta recuperación, reordenación, agrupación y clasificación, y especifica cómo formular la consulta. - Ingeniería de rendimiento y GPU puede probar los núcleos W2A8 y sus guiones de prueba sobre CUDA; las cifras disponibles son propias del proyecto y requieren reproducirse antes de usarse como objetivo de producción.
Recursos
- Repositorio: https://github.com/microsoft/BitNet
- Documentación e instalación: https://github.com/microsoft/BitNet#installation
- Informe técnico de sistema: https://arxiv.org/abs/2502.11880
- Informe de inferencia en CPU: https://arxiv.org/abs/2410.16144
- Modelos oficiales: https://huggingface.co/collections/microsoft/bitnet
- Núcleo GPU oficial: https://github.com/microsoft/BitNet/blob/main/gpu/README.md
- Guía oficial de incrustaciones: https://github.com/microsoft/BitNet/blob/main/docs/bitnet-embeddings-i2s-guide.md
- Demo oficial: https://demo-bitnet-h0h8hcfqeqhrf5gf.canadacentral-01.azurewebsites.net/
- Tutorial multimedia: https://www.youtube.com/watch?v=vgT12wWSHZA (LLM Master Cursos, 16 min 22 s)
- Conversaciones: https://news.ycombinator.com/item?id=47334694, https://news.ycombinator.com/item?id=41877609
Nota: este artículo combina documentación oficial, informes técnicos, la API de GitHub y conversaciones de Hacker News consultados el 11 de agosto de 2026. Las cifras cambian con el tiempo.
Comentarios