

VibeVoice: la voz de código abierto de Microsoft, retirada por mal uso y reconstruida alrededor del reconocimiento de habla
microsoft/VibeVoice · 54.494★ · 6.137 forks
Familia de modelos de voz de código abierto (TTS y ASR) de Microsoft, con licencia MIT, cuya singularidad es el tratamiento de audio largo: sintetiza conversaciones de hasta 90 minutos con hasta 4 hablantes y transcribe audio de hasta 60 minutos en un solo pase, con identificación de hablantes y marcas de tiempo. El proyecto acumula 53 121 estrellas y su historia incluye un episodio poco habitual: Microsoft retiró temporalmente el código del modelo TTS original por usos indebidos, y luego reconstruyó la familia del proyecto alrededor del reconocimiento de voz (VibeVoice-ASR).
Origen
El repositorio fue creado el 25 de agosto de 2025. Nació con el lanzamiento de VibeVoice-TTS (variantes de 7B «Large» y 1.5B), un modelo de texto a voz conversacional de larga duración documentado en el informe técnico arXiv:2508.19205, cuyo resumen lo presenta como una forma de sintetizar «el auténtico vibe conversacional» superando a modelos de diálogo abiertos y propietarios. El trabajo fue aceptado como Oral en ICLR 2026.
El episodio central del relato ocurrió 9 días después: el 4 de septiembre de 2025 Microsoft eliminó el modelo de 7B de Hugging Face y borró el repositorio; el 5 de septiembre volvió a publicarlo sin el código, con este aviso reproducido íntegro en el README actual: «VibeVoice is an open-source research framework intended to advance collaboration in the speech synthesis community. After release, we discovered instances where the tool was used in ways inconsistent with the stated intent. Since responsible use of AI is one of Microsoft’s guiding principles, we have removed the VibeVoice-TTS code from this repository.»
La reacción de la comunidad quedó documentada: aparecieron forks de respaldo y un paquete de PyPI, vibevoice 0.0.1 (subido el 26 de septiembre de 2025), cuya descripción cronológica registra día a día el borrado, la restauración sin código y la aparición de implementaciones no oficiales. En el hilo de Hacker News sobre la retirada, el usuario mustaphah lo resumió así: el repo superó las 8 000 estrellas en pocos días y, al revisarse, el código había desaparecido y las estrellas quedaron por debajo de 200 porque se eliminó y se creó uno nuevo.
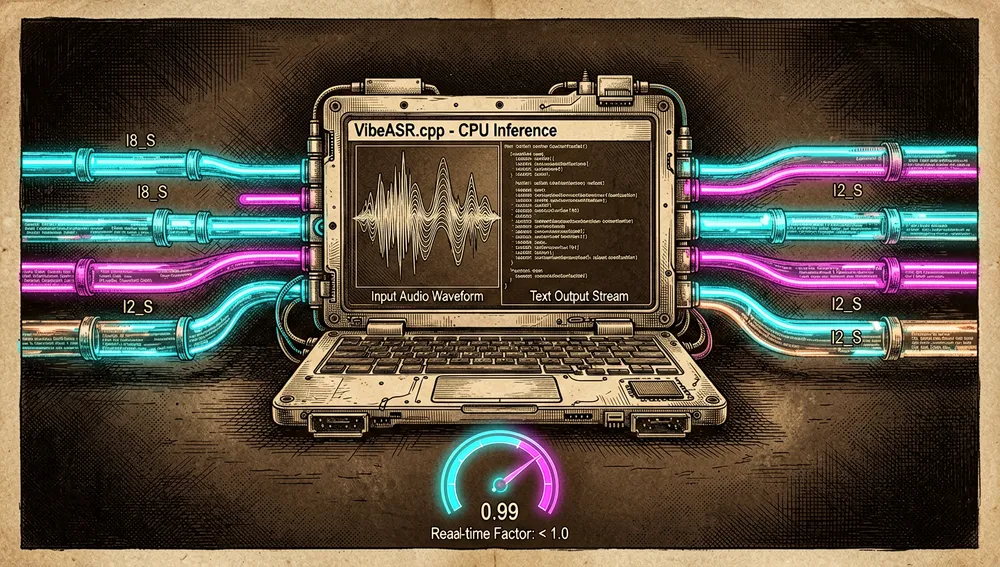
A partir de entonces, la familia se reconstruyó alrededor del ASR y de variantes TTS más controladas: 2025-12-03, se abrió VibeVoice-Realtime-0.5B (TTS en tiempo real con entrada de texto en streaming); 2026-01-21, se abrió VibeVoice-ASR, el modelo de reconocimiento de voz unificado (60 minutos en un solo pase, 50+ idiomas), con informe técnico en arXiv:2601.18184; 2026-03-06, VibeVoice-ASR entró en la librería Hugging Face Transformers; 2026-03-12, se integró en Azure AI Foundry Labs; 2026-07-23, se lanzó VibeASR.cpp, motor de inferencia en CPU con cuantización heterogénea.
Filosofía y principios
Los principios verificables en el README, la documentación y el CONTRIBUTING.md:
- Investigación por delante del producto: el README declara explícitamente que «no se recomienda usar VibeVoice en aplicaciones comerciales o del mundo real sin más pruebas y desarrollo».
- Voz larga como categoría propia: frente a la práctica habitual de cortar el audio en fragmentos cortos, la tesis del proyecto es tratar el audio largo de forma nativa dentro de una ventana de 64K tokens.
- Eficiencia mediante tokenizadores continuos a 7.5 Hz: el tokenizador de voz continuo opera a una tasa ultrabaja de 7.5 Hz. El informe técnico afirma que, comparado con EnCodec, mejora la compresión de datos 80 veces.
- Minimalismo de código: «nuestros principios centrales son el minimalismo de código, la alta legibilidad y la pureza funcional». Se rechazan explícitamente la sobreingeniería, los PR solo cosméticos y las contribuciones no en inglés.
- Uso responsable como condición: el riesgo de deepfakes se trata en cada documento de modelo.
- Licencia MIT para código y pesos, aunque la comunidad discutió su sentido práctico cuando el repo quedó «sin código».
Cómo funciona
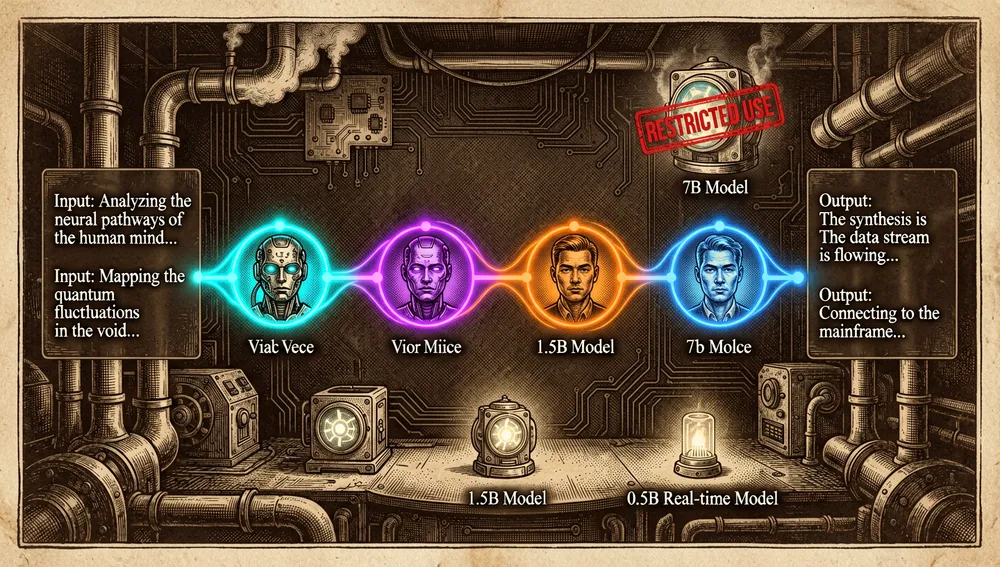
VibeVoice no es una sola herramienta sino una familia de modelos con una arquitectura compartida: un marco de difusión de siguiente-token (next-token diffusion) —el LLM entiende el contexto textual y el flujo del diálogo, y una cabeza de difusión genera el detalle acústico— sobre una base Qwen2.5 (1.5B en TTS-1.5B, 0.5B en Realtime-0.5B, 7B en ASR).
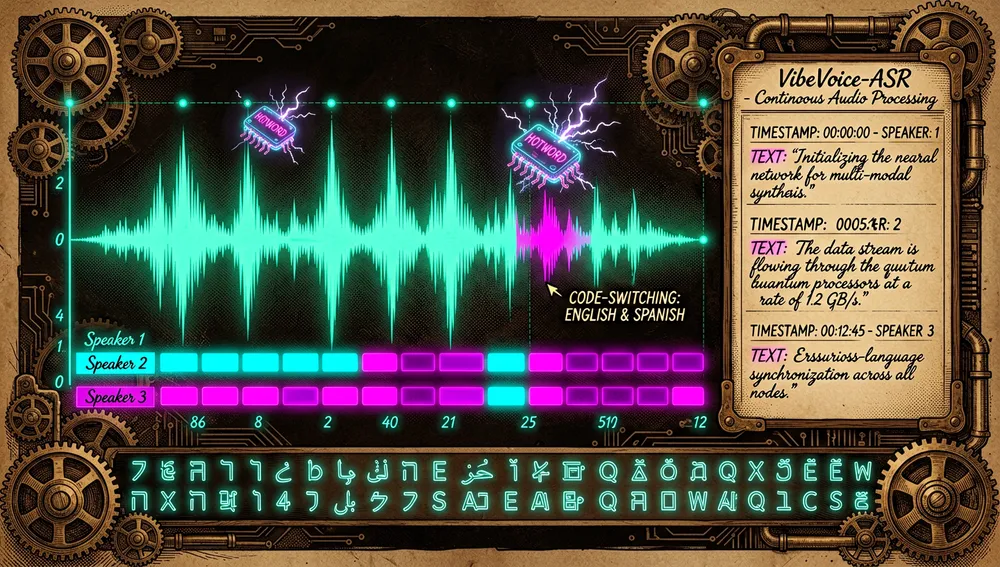
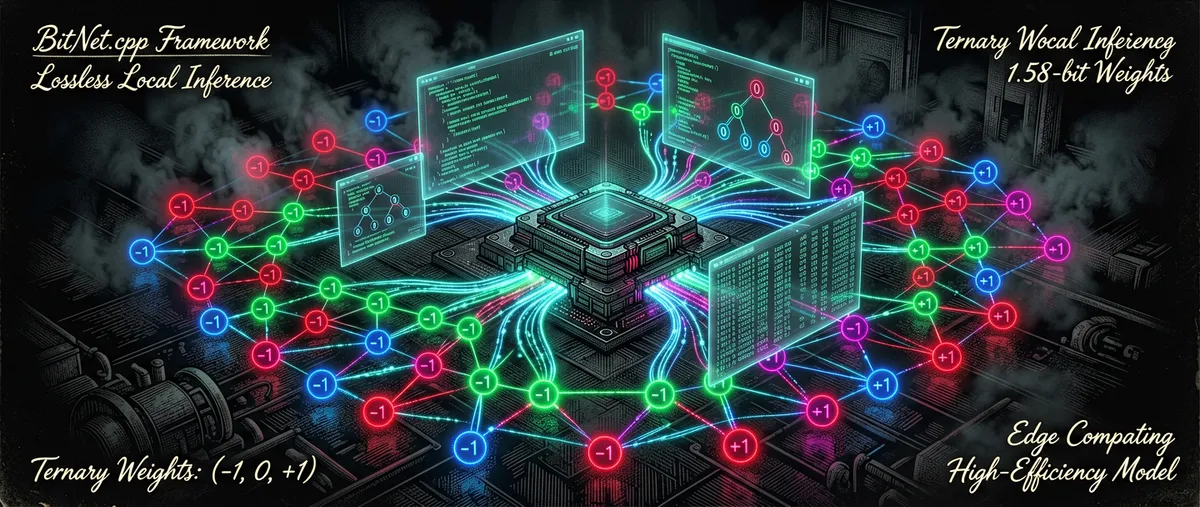
Los modelos activos del repositorio: VibeVoice-ASR: transcripción estructurada tipo «quién/cuándo/qué»: hace simultáneamente ASR, diarización y marcas de tiempo, con soporte de palabras clave personalizadas y más de 50 idiomas sin necesidad de indicar el idioma; acepta hasta 60 minutos de audio continuo en un solo pase. VibeVoice-TTS: generación conversacional de hasta 90 minutos con hasta 4 hablantes distintos; la sección de instalación dice textualmente «Disabled due to widespread misuse» («Desactivada por mal uso generalizado»). VibeVoice-Realtime-0.5B: TTS en tiempo real (~200–300 ms de latencia hasta la primera palabra), entrada de texto en streaming, ~10 minutos de generación robusta. VibeVoice-ASR-BitNet (en microsoft/VibeASR.cpp): variante para CPU con cuantización heterogénea, comprimiendo el modelo de 4.62 GB a 1.58 GB.
El ecosistema
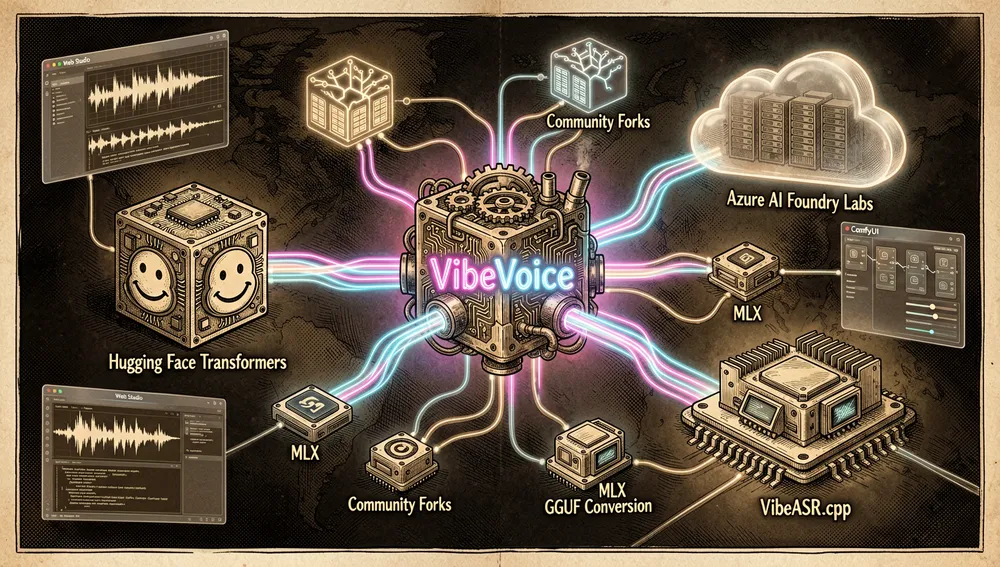
Repos oficiales de Microsoft: microsoft/VibeASR.cpp — motor de inferencia oficial para CPU (166 estrellas, 21 bifurcaciones); Hugging Face Transformers (microsoft/VibeVoice-ASR-HF); una colección de Hugging Face que agrupa los pesos; e integración en Azure AI Foundry Labs.
La búsqueda de GitHub por «VibeVoice» devuelve 371 repositorios. Los más destacados por estrellas: Enemyx-net/VibeVoice-ComfyUI (1 547, integración ComfyUI para el TTS), vibevoice-community/VibeVoice (1 527, fork de la comunidad del modelo original), wildminder/ComfyUI-VibeVoice (596), zhao-kun/VibeVoiceFusion (490), voicepowered-ai/VibeVoice-finetuning (373), mpaepper/vibevoice (160, STT local con faster-whisper), localai-org/vibevoice.cpp (121, port a C++ sobre ggml), marhensa/vibevoice-realtime-openai-api (88), danielclough/vibevoice-rs (66, Rust).
El paquete vibevoice 0.0.1 en PyPI es una copia de seguridad del código TTS original antes del borrado. Simon Willison documentó un one-liner para correr VibeVoice-ASR en Mac con mlx-audio y la conversión MLX de 4 bits, indicador de un ecosistema de conversiones comunitarias (MLX, GGUF, cuantizaciones).
Estado oficial / semioficial
- Proyecto oficial de la organización
microsoften GitHub, con sitio propio, informes técnicos en arXiv y aceptación como Oral en ICLR 2026. - Integración en Azure AI Foundry Labs (12 de marzo de 2026): el único «respaldo de vendor» verificable, y proviene del propio vendor propietario.
- Distribución en Hugging Face Transformers (6 de marzo de 2026) para el ASR.
- Restricción oficial permanente del TTS 7B: el modelo original está «Disabled» en la tabla del README, su instalación fue desactivada «por mal uso generalizado».
- No hay estatus de «estándar de facto» verificable; el README declara que el proyecto es de investigación y desaconseja uso comercial.
Números del repo
De la API de GitHub, a las 00:35 UTC del 23 de agosto de 2026:
| Métrica | Valor |
|---|---|
| Estrellas | 53 121 |
| Bifurcaciones | 5 990 |
| Suscriptores (watchers) | 259 |
| Issues + PRs abiertos | 183 |
| Commits en la rama principal | 140 |
| Releases | ninguno |
| Lenguaje | Python |
| Licencia | MIT |
Top contribuidores: YaoyaoChang (50), MSLDCherryPick (18), pengzhiliang (16), jsoref (12), Damon-Salvetore (10). Descargas totales en Hugging Face: VibeVoice-ASR 697 553, VibeVoice-Realtime-0.5B 647 155, VibeVoice-1.5B 119 947, VibeVoice-ASR-BitNet 19 273.
Guía rápida de uso
Instalación y primer arranque
Prerrequisitos: GPU NVIDIA (recomendado) y el contenedor NVIDIA Deep Learning Container para CUDA.
Para el ASR:
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
pip install -e .
Para el TTS en tiempo real:
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice/
pip install -e .[streamingtts]
Para VibeASR.cpp (CPU, sin GPU):
git clone --recursive https://github.com/microsoft/VibeASR.cpp.git
cd VibeASR.cpp
pip install -r requirements.txt
python setup_env.py
El modelo se descarga a la caché de Hugging Face; el ASR-7B ocupa 17.3 GB en FP16.
Flujos de trabajo habituales
- Transcribir una reunión larga:
python demo/vibevoice_asr_gradio_demo.py --model_path microsoft/VibeVoice-ASR --share(requiereffmpeg). - Transcribir con hotwords de dominio:
python demo/vibevoice_asr_inference_from_file.py --model_path microsoft/VibeVoice-ASR --audio_files [ruta]. - Probar el TTS en tiempo real sin GPU propia: notebook de Colab o
python demo/vibevoice_realtime_demo.py --model_path microsoft/VibeVoice-Realtime-0.5B. - Servir el ASR como API compatible con OpenAI:
docker run -d --gpus all ... vllm/vllm-openai:v0.14.1 -c "python3 /app/vllm_plugin/scripts/start_server.py --dp 4".
Configuración esencial
--model_path: nombre del modelo de Hugging Face; se descarga automáticamente a la caché de HF.--hotwords: lista de términos que mejoran la precisión en jerga de dominio.VIBEVOICE_FFMPEG_MAX_CONCURRENCY(servidor vLLM, por defecto 64).--tp/--dp(servidor vLLM): paralelismo de tensor y de datos.
Trampas frecuentes y soluciones
- Música/sonidos aleatorios en el TTS: son espontáneos e incontrolables («un easter egg»); el modelo Large es más estable.
- Inestabilidad con texto chino: usar puntuación inglesa, la variante Large y trocear el texto en varios turnos con la misma etiqueta de hablante.
--max-tokensinsuficiente en el ASR: el valor por defecto (8192) alcanza para ~25 minutos; para una hora completa hay que subirlo (por ejemplo a 32768).- «CUDA out of memory»: reducir
--gpu-memory-utilization,--max-num-seqso--max-model-len. - El TTS 7B original no está disponible oficialmente: las únicas vías son forks/respaldos comunitarios, sin soporte oficial.
Integraciones y migración
vLLM: plugin oficial que expone endpoints compatibles con la API de OpenAI. Hugging Face Transformers: el ASR se consume como microsoft/VibeVoice-ASR-HF. ComfyUI: nodos comunitarios. MLX (Apple Silicon): vía mlx-audio y conversión 4-bit. Migración desde Whisper: VibeASR.cpp se compara directamente con Whisper.cpp (1.6–2.3× más rápido a tamaño comparable).
Cómo contribuir
El CONTRIBUTING.md documenta criterios estrictos: enfoque académico orientado a investigación; contribuciones preferidas de correcciones y funcionalidades nuevas; se rechazan la sobreingeniería, los PR solo estéticos y las contribuciones no en inglés; revisión línea a línea manual por los mantenedores, con rechazo explícito de grandes bloques de código generado por LLM sin limpieza humana.
Cómo lo recibió la comunidad
Hacker News — lanzamiento del TTS (448 puntos, 170 comentarios): baal80spam dice que «suena MUY impresionante»; la crítica más repetida es que los hombres suenan robóticos (simiones, IshKebab, strangescript). TheAceOfHearts señaló un problema de hardware: «generó un clip de 66 segundos en 832 segundos en CPU con float32». echelon: «cercano al SOTA emocional… me pregunto si ElevenLabs mantendrá su enorme ARR»; odie5533 replicó que Chatterbox le resulta más realista.
Hacker News — retirada del código: hilo donde mustaphah documentó el antes/después: más de 8 000 estrellas en pocos días y luego «código desaparecido, estrellas por debajo de 200».
Hacker News — revivir del ASR (386 puntos, 181 comentarios): CubsFan1060 enlazó la entrada de Simon Willison, quien corrió el ASR en un MacBook Pro M5 Max con mlx-audio: 8 min 45 s para transcribir una hora de podcast. walthamstow: «parece bastante pesado para un STT; Parakeet y Whisper son mucho más pequeños».
VibeVoice frente a otras propuestas
| Proyecto | Relación con VibeVoice |
|---|---|
| Whisper / Whisper.cpp (OpenAI) | El benchmark clásico de STT; VibeASR.cpp lo compara directamente (1.6–2.3× más rápido a tamaño comparable). |
| Parakeet (NVIDIA) | Alternativa STT más pequeña y rápida para dictado. |
| SenseVoice / FunASR (Alibaba) | Incluidos en las mismas tablas de WER. |
| ElevenLabs | Referencia comercial de TTS expresivo citada por comentaristas de HN. |
| Kokoro TTS | Alternativa local citada como preferida, con lectura por fonemas (IPA). |
| Chatterbox | Citado como «más realista, sin sonido robótico». |
Casos de uso y a quién puede ayudar este repositorio
- Equipos de transcripción de reuniones/pódcasts largas: el ASR de 60 minutos en un solo pase con diarización, marcas de tiempo y hotwords cubre el flujo completo sin cadenas de chunking externas; la variante BitNet abre despliegues sin GPU.
- Equipos de producto con voz en vivo: VibeVoice-Realtime-0.5B está diseñado para que asistentes empiecen a hablar desde el primer token.
- Producción de audio conversacional: el TTS-1.5B de 90 minutos y 4 hablantes cubre prototipado de diálogos; las integraciones ComfyUI lo meten en pipelines visuales/auditivos.
- Investigadores y equipos de ML speech: informes técnicos citables, afinamiento LoRA documentado y una arquitectura de referencia técnica.
- Desarrolladores de Apple Silicon / edge: conversión MLX 4-bit y el runtime VibeASR.cpp permiten transcripción local sin GPU.
Recursos
- Repositorio: https://github.com/microsoft/VibeVoice
- Documentación: https://microsoft.github.io/VibeVoice/
- Modelos oficiales: https://huggingface.co/microsoft/VibeVoice-ASR
- Playground ASR: https://aka.ms/vibevoice-asr
- Papeles técnicos: TTS https://arxiv.org/abs/2508.19205 · ASR https://arxiv.org/abs/2601.18184
- Repo hermano oficial: https://github.com/microsoft/VibeASR.cpp
- Reviews: Simon Willison (27 de abril de 2026) https://simonwillison.net/2026/Apr/27/vibevoice/
Nota: este artículo combina el README y la documentación oficial de VibeVoice, la API de GitHub, informes técnicos en arXiv, discusiones de Hacker News y la entrada de Simon Willison, consultados el 22 de agosto de 2026. Las cifras cambian con el tiempo. No se obtuvo evidencia recuperable de Reddit en esta ejecución.
Comentarios