

Academic Research Skills: ein akademischer Forschungs-Copilot mit menschlicher Aufsicht
Imbad0202/academic-research-skills · 49.449★ · 3.828 forks
Alles Wichtige zu Imbad0202/academic-research-skills: eine Skill-Suite für Claude Code, die einen Forscher durch den vollständigen Ablauf Recherche → Schreiben → Review → Überarbeitung → Fertigstellung begleitet, mit verpflichtenden menschlichen Kontrollpunkten.
Was Academic Research Skills ist
Academic Research Skills (ARS) ist ein Skills-Framework für Claude Code, ausgerichtet auf nicht-kommerzielle akademische Forschung. Es ist kein Modell, kein Server und kein autonomer Agent: Das Kernprodukt ist eine Sammlung von Anweisungen und Werkzeugen, die einen Menschen durch den gesamten Prozess der Erstellung einer Publikation führen. Die eigene Datei POSITIONING.md definiert es als „quelloffen einsehbaren (source-available) akademischen Forschungs-Copiloten” für nicht-kommerzielle akademische Nutzung.
Das Repository bündelt vier Skills, jede mit eigener SKILL.md, und insgesamt 27 Modi laut MODE_REGISTRY.md:
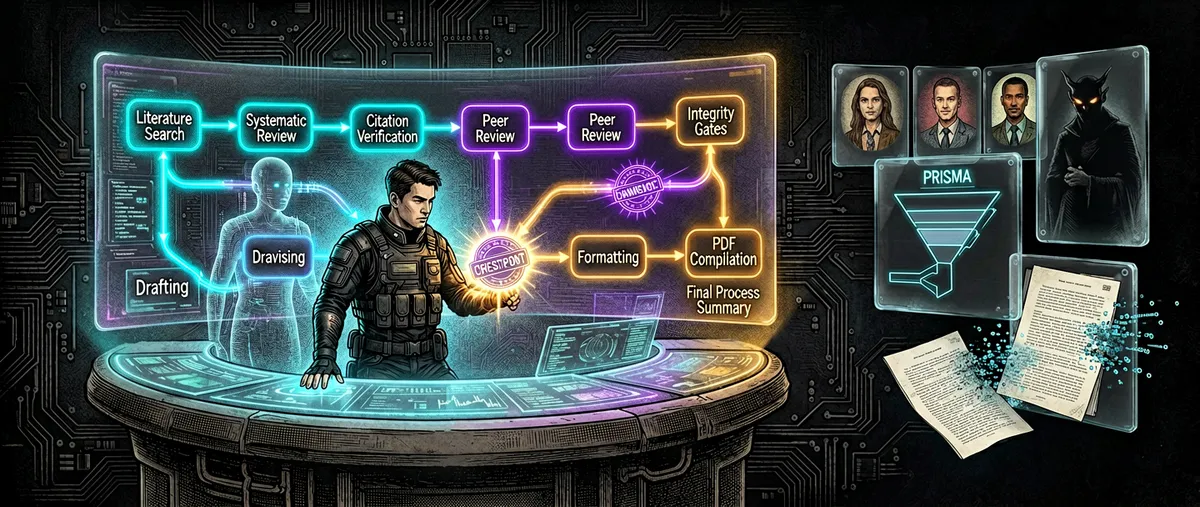
deep-research(Version 2.12.1, 8 Modi, 13 Agenten): Literatursuche, systematisches PRISMA-Review, Faktenprüfung und ein sokratischer Orientierungsmodus.academic-paper(Version 3.3.1, 11 Modi, 12 Agenten): Planung, Entwurfsschreiben, feedbackgetriebenes Umschreiben, Zitationsprüfung und Erzeugung von KI-Nutzungserklärungen.academic-paper-reviewer(Version 1.11.1, 6 Modi): Peer-Review-Simulation mit einem festen Panel aus fünf Gutachtern plus einem „Advocatus Diaboli”-Gutachter.academic-pipeline(Version 3.21.1): ein zehnstufiger Orchestrator, der die vorherigen drei mit verpflichtenden Kontrollpunkten verkettet.
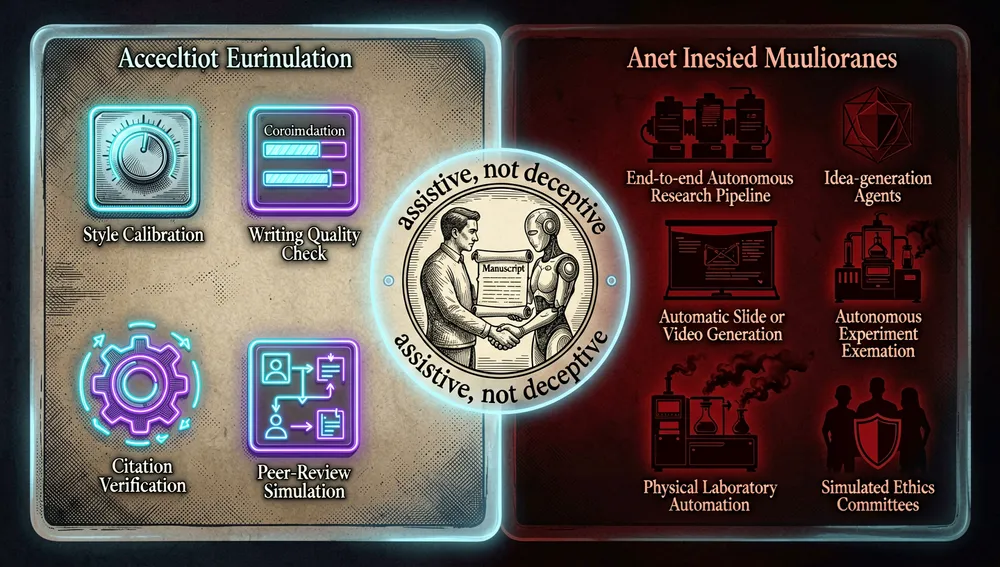
Das Design wird in einem Satz des Positionierungsdokuments zusammengefasst: „assistive, not deceptive” (unterstützend, nicht täuschend). ARS hilft, besser zu schreiben, nicht zu verbergen, dass KI genutzt wurde; es beansprucht keine Autorenschaft, und seine Ausgaben sind ohne menschliche Überprüfung nicht einreichbereit.
Der Ursprung: ein Toolkit für den einsamen Forscher
Das Repository wurde am 26. Februar 2026 von Edward Cheng-I Wu (Imbad0202) erstellt, dessen GitHub-Account weder Firma noch Profilbeschreibung angibt. Der erste datierte Commit-Eintrag entspricht dem 26. Februar 2026, in Pipeline-Version v2.0.
Wu veröffentlichte die ursprüngliche Ankündigung als Substack-Newsletter-Artikel mit dem Titel „Academic Writing Shouldn’t Be a Solo Act” (Akademisches Schreiben sollte kein Soloakt sein), Untertitel „An Open-Source AI Toolkit for Researchers”, datiert auf den 8. März 2026 und aktualisiert am 19. April 2026. Darin beschreibt er die Schmerzpunkte, die das Tool motivieren: das „schwarze Loch” der Literaturrecherche, den roten Faden mitten im Entwurf zu verlieren, Zitationsangst, das Fehlen eines verfügbaren Gutachters und die „Formatierungshölle”. Seine These: Was ein Forscher braucht, ist keine KI, die „den Paper für ihn schreibt”, sondern ein Begleiter, der ihn von der Forschungsfrage bis zum finalen PDF begleitet.
Der Autor selbst dokumentiert eine zentrale Spannung, die das Design prägt. Am 3. April 2026 veröffentlichte er v3.0, entstanden aus einem „vierrundigen dialektischen Experiment”, bei dem der „Advocatus-Diaboli”-Agent zu schnell nachgab, der sokratische Mentor vorzeitig zu konvergieren versuchte und die gesamte Debatte im vom Menschen gesetzten Rahmen gefangen blieb. Dieser Befund (dass die verifizierende KI und die generierende KI denselben kognitiven Rahmen teilen) motivierte die Verbesserungen gegen Adulation und für die Gesundheit des Dialogs. Der Launch-Artikel dokumentiert zudem einen Stresstest von v2.7, der eine Zitationsfehlerquote von 31 % aufdeckte: Ein vollständiges Web-Such-Audit der 68 Referenzen fand 21 Probleme, die drei Runden von Integritätsprüfungen passiert hatten, und das wurde zur Begründung für die verpflichtende externe Verifikation.
Philosophie und Prinzipien
POSITIONING.md und das README nennen verifizierbare Prinzipien:
- Unterstützend, nicht täuschend: Die Funktionen zur Stilkalibrierung und Schreibqualität zielen darauf, die Prosa zu verbessern, nicht die KI-Erkennung zu umgehen. Der Disclosure-Modus erzeugt KI-Nutzungserklärungen pro Publikationsort oder Richtlinie.
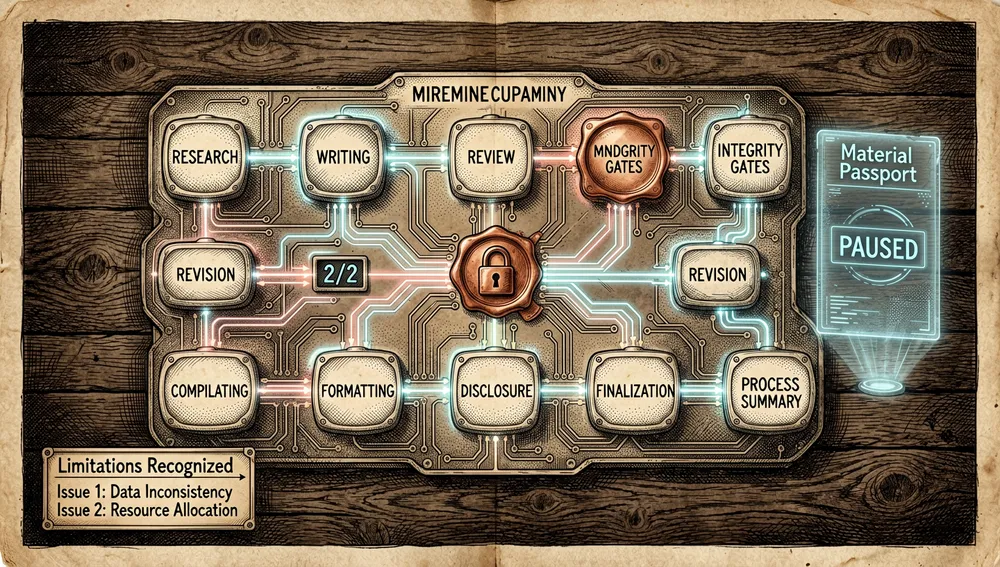
- Menschliche Aufsicht, immer: FULL-Kontrollpunkte präsentieren alle Deliverables und verlangen ausdrückliche Bestätigung; MANDATORY-Punkte (Integritätsgates der Stufen 2,5 und 4,5, Review-Entscheidungen) können nicht übersprungen werden. „Full Mode” bedeutet Ausführung der vollständigen Pipeline, nicht volle Autonomie. Maximal zwei Umschreibeschleifen; was übrig bleibt, wird zu „Anerkannten Einschränkungen”.
- Fehlermodi werden sichtbar gemacht: Die Liste von 7 Fehlermodi der KI-gestützten Forschung und der Kalibrierungsmodus des Gutachters existieren, damit der Nutzer sieht, wo die KI versagen kann.
- Grenzen werden protokolliert, nicht improvisiert:
POSITIONING.mdenthält einen Abschnitt „Abgelehnte Mechanismen” (Anti-Patterns autonomer Forschung, größtenteils katalogisiert von Kong et al., 2026, arXiv:2605.18661), die das Projekt ausdrücklich ablehnt: durchgängig autonome Forschungspipelines, Ideengenerierungs-Agenten, automatische Folien-/Videoerzeugung, autonome Experimentausführung, physische Laborautomation und simulierte Ethikkommissionen.
Eine wichtige Klarstellung der Positionierung: Die Prüfungen von ARS decken das Manuskript und den berichteten Prozess ab, nicht die tatsächliche Ausführung. Das Dokument sagt es unverblümt: „Eine auf erfundenen Daten aufgebaute Studie kann jedes ARS-Gate passieren, wenn die Fabrikation kohärent berichtet, zitiert und verpackt wird.”
Wie es funktioniert
Der Orchestrator academic-pipeline führt einen zehnstufigen Durchlauf mit adaptiven Kontrollpunkten (FULL / SLIM / MANDATORY) aus. Ein repräsentativer Ausschnitt des dokumentierten Ablaufs:
- Recherchieren (
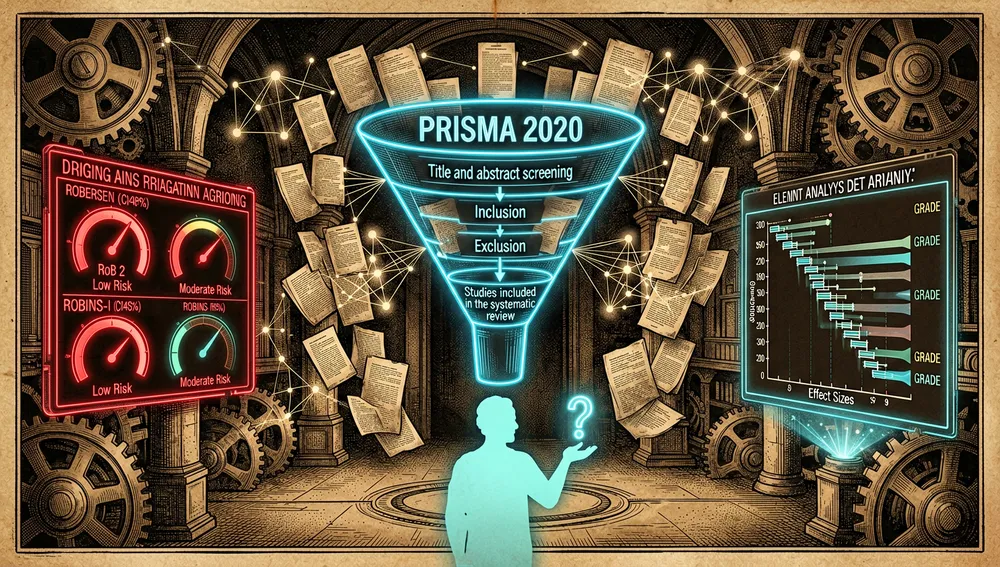
deep-research): Konvergenz auf Argumenten, nicht nur auf Papers. Enthält einensystematic-review-Modus mit PRISMA-2020-Vorlagen, einen Bias-Risk-Agenten (RoB 2 + ROBINS-I) und einen Meta-Analyse-Agenten (Effektgrößen, Heterogenität, Forest-Plot-Daten, GRADE-Bewertung).
- Schreiben (
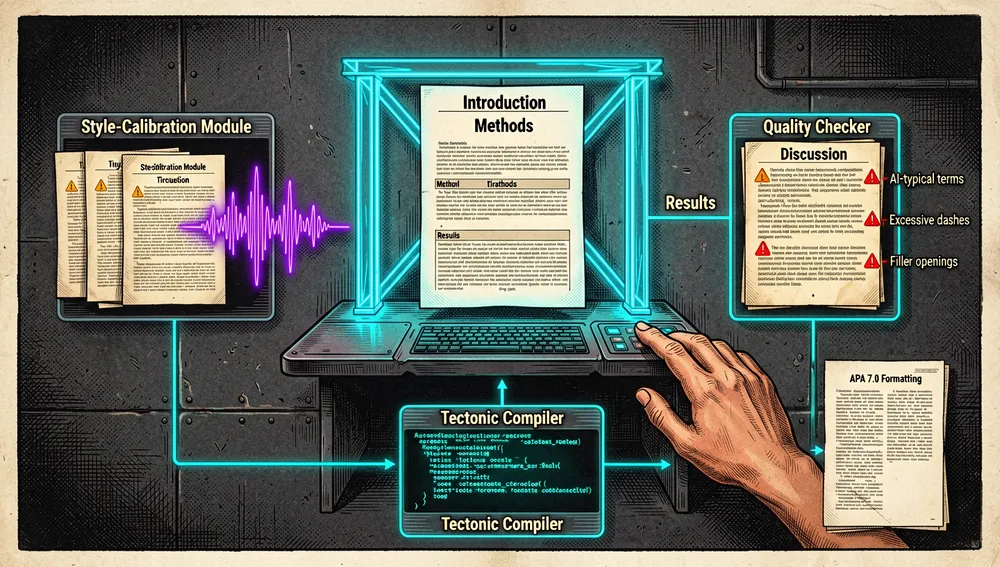
academic-paper): ein IMRaD-Entwurf oder einer nach Domänenstruktur, mit optionaler Stilkalibrierung (lernt die „Stimme” des Autors aus 3+ früheren Papers) und einer Schreibqualitätsprüfung, die 25 typische KI-Begriffe, übermäßigen Gedankenstrich-Einsatz (≤3 pro Paper) und Füllöffnungen markiert.
- Begutachten (
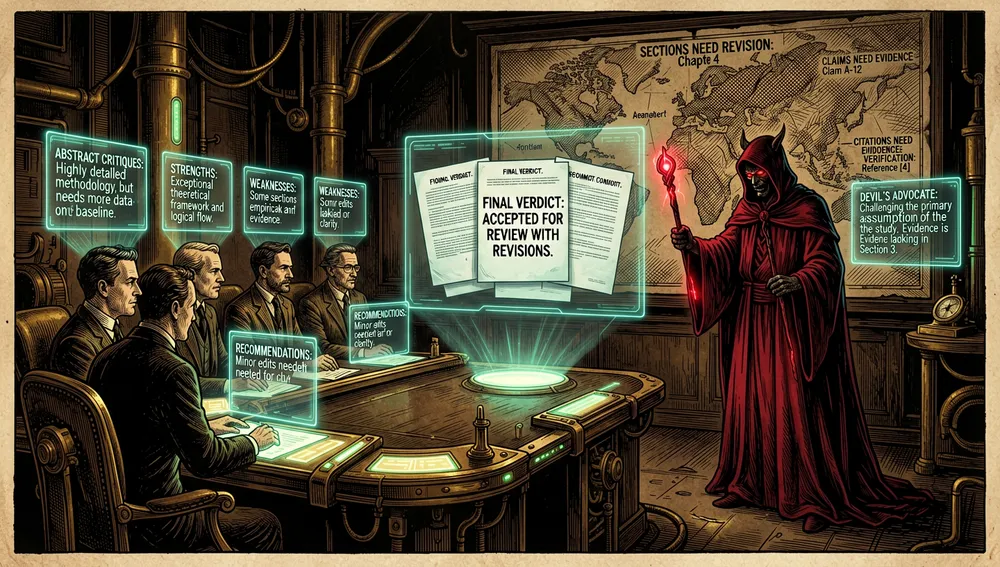
academic-paper-reviewer): ein festes Panel aus fünf Gutachtern plus einem „Advocatus Diaboli”; erzeugt fünf Gutachten, eine Redaktionsentscheidung und eine Umschreibkarte.
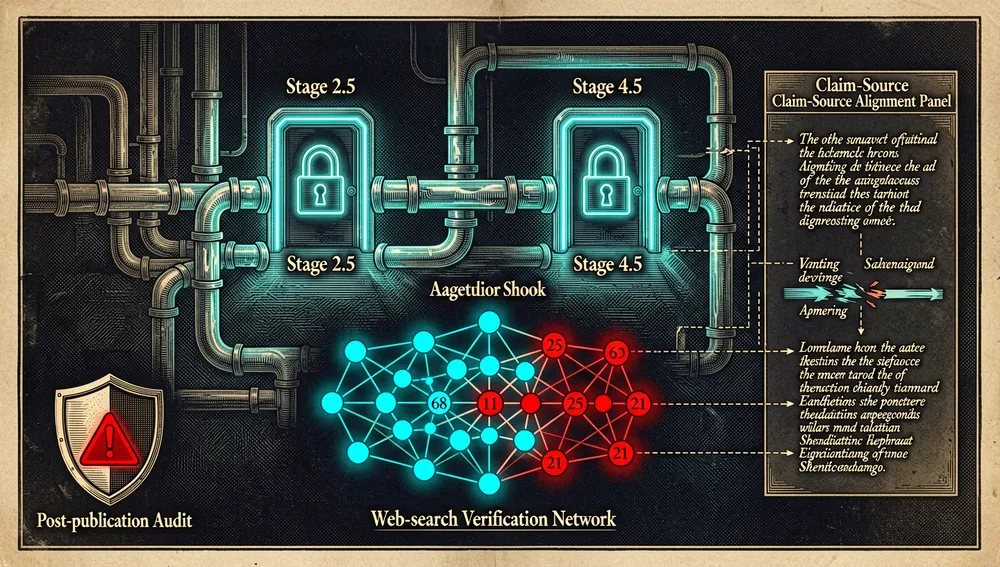
- Integritätskontrollpunkte (Stufen 2,5 und 4,5): Verifizierung der Existenz jeder Referenz per Websuche, Aussage-Quelle-Abgleich und Prüfung der Berichtsrichtlinien.
- Fertigstellen (
academic-pipelineStage 5/6): Formatkonvertierung (APA 7.0 / Chicago / IEEE), PDF-Kompilierung via LaTeX mittectonic, und eine abschließende „Process Summary”, die eine Bewertung der Kollaborationsqualität enthält.
Ein in examples/showcase/ dokumentierter realer Anwendungsfall zeigt das Ergebnis eines vollständigen zehnstufigen Pipeline-Durchlaufs: ein Vor-Review-Integritätsbericht, der „15 erfundene Referenzen + 3 statistische Fehler abfing”, zwei Runden Peer-Review, eine punktweise Antwort an die Gutachter, und ein Audit nach der Veröffentlichung (2026-03-09), das bei der Verifikation aller 68 Referenzen per Websuche 21 Probleme fand, die die drei Prüfrunden nicht entdeckt hatten.
Schnellstart-Anleitung
Installation und erster Start
Voraussetzungen: Claude Code (eine aktuelle Version, da die Plugin-Verpackung aktuelle Versionen erfordert) und eine exportierte Variable ANTHROPIC_API_KEY (oder eingegeben beim ersten Start von claude). Optional, aber empfohlen: Pandoc für DOCX-Ausgabe und tectonic (mit der Schriftart Source Han Serif TC) für APA-7.0-PDF; ohne sie funktioniert die Markdown-Ausgabe trotzdem. Die Kernagenten werden per Anweisung gesteuert und benötigen kein Python; einen echten Python-Interpreter brauchen nur optionale Funktionen (der PreToolUse-Schreibumfang-Guard, der Umschreibe-Patch-Modus, der Einreichungspaket-Prüfer).
Die empfohlene Methode (Plugin, ab v3.7.0):
/plugin marketplace add Imbad0202/academic-research-skills
/plugin install academic-research-skills
Die vier SKILL.md-Dateien werden automatisch aus dem skills/-Verzeichnis des Plugins erkannt. Das README empfiehlt, die Auto-Aktualisierung in der /plugin-Oberfläche zu aktivieren (ARS veröffentlicht alle 1–2 Wochen) und die Update-Prüfung mit ARS_UPDATE_CHECK=0 bei Bedarf zu deaktivieren.
Weitere in docs/SETUP.md dokumentierte Methoden: die vier Skill-Ordner in .claude/skills/ eines Projekts kopieren (Methode 1), das Repository klonen und direkt öffnen (Methode 2), ein Zip pro Skill in Claude Cowork hochladen (Methode 3), mit claude.ai Web nutzen (Methode 4) und in Claude Science importieren (Methode 5, ab v3.14.0). Für OpenAI Codex existiert eine separate Schwester-Distribution (Imbad0202/academic-research-skills-codex).
Übliche Workflows
Das README dokumentiert die Aktivierung per natürlicher Sprache:
# Vollständige Forschungspipeline
Du: "Ich möchte einen Paper über den Einfluss von KI auf die QA im Hochschulwesen schreiben"

# Sokratische Orientierung
Du: "Leite meine Recherche zu KI in der Bildungsbewertung an"

# Angeleitete Paper-Planung
Du: "Führe mich Schritt für Schritt durchs Schreiben eines Papers über demografischen Rückgang"

# Einen bestehenden Paper begutachten
Du: "Begutachte diesen Paper" (und den Paper bereitstellen)

# Pipeline-Status abfragen
Du: "status"
Der sokratische Modus und der Planungsmodus nutzen intentionsbasierte Aktivierung (nicht stichwortbasiert), weshalb sie in jeder Sprache funktionieren; nur die allgemeine Skill-Aktivierung listet weiterhin Stichwörter auf Englisch und traditionellem Chinesisch.
Wesentliche Konfiguration
Die optionalen Umgebungsvariablen (alle standardmäßig AUS), die ein neuer Nutzer laut docs/SETUP.md zuerst anfasst:
ARS_CROSS_MODEL: aktiviert die modellübergreifende Verifikation (z. B.gpt-5.6-sol,gemini-3.1-pro-previewodergpt-5.5), um Fakten mit einem anderen Modell als dem generierenden zu prüfen.ARS_SOCRATIC_READING_PROBE=1: aktiviert eine einmalige Lesesonde im sokratischen Mentor, wenn der Nutzer einen konkreten Paper zitiert hat.ARS_PASSPORT_RESET=1: verwandelt jeden FULL-Kontrollpunkt in eine Kontext-Reset-Grenze und erlaubt die Wiederaufnahme in einer neuen Sitzung ausgehend vomMaterial Passport.ARS_CROSS_MODEL_TRANSPORT=codex: nutzt den Transport des ChatGPT-Abos nur für die Zitationsintegrität-Aufrufe.ARS_MODEL_TIERING(economyoderquality-boost): optionale Modellzuweisung nach Agententyp.
Feste inhaltliche Präferenzen (Zitationsstil, Einbeziehung von Suchen) werden in CLAUDE.md deklariert, nicht in Umgebungsvariablen.
Häufige Fallstricke und Lösungen
- Installation als einzelner verschachtelter Ordner: Das README warnt ausdrücklich davor, das gesamte Repository unter
.claude/skills/academic-research-skills/zu kopieren, weil das die vierSKILL.md-Dateien eine Ebene zu tief vergräbt, als dass Claude sie erkennen könnte. Die vier Skill-Ordner müssen einzeln kopiert werden. - Cowork liest
~/.claude/skills/nicht: Dieses Verzeichnis gehört zu Claude Code CLI/IDE; Claude Cowork lädt Skills, die über Settings → Capabilities → Skills hochgeladen wurden, jede als eigenes Zip. Ordner dorthin zu verlinken oder zu kopieren lässt sie nicht erscheinen. python3aus dem Microsoft Store unter Windows: meist ein nicht funktionierender Platzhalter; echtes Python von python.org installieren. Der Launcher desPreToolUse-Guards ist ein POSIX-Skript, das unter Windows Git Bash benötigt; ohne Git Bash bleibt der Guard inaktiv (akzeptierte Degradation, blockiert nie Schreibvorgänge).- Befehle erscheinen nicht: Bei Plugin-Installationen sind Befehle als
/academic-research-skills:ars-<modus>namespaced; die Form ohne Präfix/ars-<modus>funktioniert nur in Claude Code v2.1.216 oder neuer. - Wiederaufnahme langer Sitzungen: Um in langen Sitzungen keinen Zustand zu verlieren, ist der
Material Passportder sitzungsübergreifende Wiederaufnahmemechanismus;docs/PERFORMANCE.mdbietet Leitlinien zu Token-Budgets.
Integrationen und Migration
- Modellübergreifende Verifikation: einen OpenAI-/Google-Anbieter mit
OPENAI_API_KEY-/GOOGLE_AI_API_KEY-Schlüsseln undARS_CROSS_MODELverbinden. Die Community listet ein kompatibles Gateway (OrcaRouter) als Anbieter für Cross-Verifikation. - Literaturkorpus-Adapter (ab v3.6.4):
scripts/adapters/enthält drei Referenz-Python-Adapter (folder_scan.pyfür PDFs,zotero.pyfür Better-BibTeX-Exporte,obsidian.pyfür Frontmatter), die aus der Bibliothek des Nutzers einepassport.yaml+rejection_log.yamlerzeugen. - Pi-Wrapper (von der Community gepflegt, im Baum):
pi install git:github.com/Imbad0202/academic-research-skills. Dokumentiert zwei Leistungsunterschiede: keine Agenten-Isolation/-Orchestrierung (die Rollen laufen sequenziell, eine zu deklarierende Degradation) und Claudes Hooks laufen unter Pi nicht. - Ein OpenCode-Port und eine Codex-Distribution existieren als unabhängige Repositories.
- Experiment-Begleiter:
experiment-agentfüllt die Lücke zwischen ARS-Stufe 1 (RECHERCHIEREN) und Stufe 2 (SCHREIBEN), führt Code-Experimente aus und verwaltet Protokolle für Humanstudien. - Es ist kein Migrationsprozess von einem konkreten vergleichbaren Tool dokumentiert; die übliche „Migration” findet zwischen den sechs dokumentierten Installationsmethoden und zwischen dem Hauptrepository und seiner Schwester-Distribution für Codex statt.
Offizieller und halboffizieller Status
ARS ist nicht Teil eines offiziellen Anthropic-Katalogs oder des eines anderen Anbieters: Es wird als Claude-Code-Plugin aus dem Repository selbst über /plugin marketplace add Imbad0202/academic-research-skills installiert, ein vom Projekt selbst verwalteter Marketplace, kein offizieller Markt. Die Seite THIRD_PARTY.md stellt klar, dass die dortige Auflistung von Drittprojekten ausdrücklich keine Empfehlung ist und dass diese Projekte von unabhängigen Parteien stammen, nicht vom Maintainer geprüft.
Was als externe Anerkennung verifizierbar ist:
- Zenodo-Registrierung: Das Projekt hat eine formale Zitation
Wu, C.-I. (2026). Academic Research Skills for Claude Code (Version 3.21.1) [Computer software]. Zenodo. https://doi.org/10.5281/zenodo.20696614. Die Abfrage der Zenodo-API in dieser Recherche lieferte einen lebenden Datensatz (aktueller DOI10.5281/zenodo.22080258, Datum 2026-08-24), was darauf hindeutet, dass das Projekt als Software zitiert und versioniert wird. - Lizenz CC BY-NC 4.0: Das README und
POSITIONING.mdbestehen darauf, dass es keine Open-Source-Lizenz sei; sie schränkt kommerzielle Nutzung absichtlich ein, um das Tool für akademische Communities kostenlos zu halten. Ein GitHub-Discussions-Thread („Commercial licensing inquiry for ARS”, vonacelsss) zeigt, dass Anfragen zu kommerziellen Lizenzen real sind und an den Maintainer weitergeleitet werden. - De facto: Die Präsenz Dutzender Ableger und Ports (siehe „Das Ökosystem”), die Video-Tutorials und der Artikel des Autors lassen es als De-facto-Referenz für das Muster „akademischer Forschungs-Copilot mit menschlicher Aufsicht” im Claude-Code-Skills-Raum fungieren. Es wurde jedoch keine formale Standardbezeichnung gefunden.
Das Ökosystem
Repositories desselben Autors
Laut der öffentlichen Repository-Liste von Imbad0202, konsultiert in dieser Recherche:
Imbad0202/academic-research-skills-codex: eine native Codex-Distribution desselben Arbeitsinhalts; 9.453 Sterne und 439 Forks, erstellt am 25. April 2026. Es ist das größte Schwesterstück.Imbad0202/experiment-agent: eine Begleit-Skill für Ausführung, Überwachung und statistische Interpretation von Experimenten; 179 Sterne und 12 Forks. Das README von ARS verlinkt sie als Füllung zwischen Stufe 1 und Stufe 2.Imbad0202/tw-formal-writing: eine Skill zum Schreiben taiwanesischer Formaldokumente (Amtsschreiben, Briefe, Verträge), importierbar in ChatGPT/Claude/Gemini; 163 Sterne und 19 Forks.Imbad0202/critical-thinking-for-humans: ein „Fitnessstudio für kritisches Denken”, in dem die KI der Trainer ist; 32 Sterne und 2 Forks.Imbad0202/cc-user-autopsy: eine Peer-Review-Skill mit Nachvollziehbarkeit für Claude-Code-Nutzer; 11 Sterne und 2 Forks.
Community-Ports, -Übersetzungen und -Erweiterungen
Eine GitHub-Repository-Suche nach „academic-research-skills” lieferte insgesamt 650 Ergebnisse; die bemerkenswertesten nach Sternen, einzeln abgerufen:
HughYau/AcademicForge: eine kuratierte Skill-Sammlung fürs akademische Schreiben; 2.491 Sterne und 147 Forks.aipoch/medical-research-skills: Hunderte medizinische Forschungs-Skills (Protokolldesign usw.); 1.771 Sterne und 164 Forks.LeonChaoX/qinyan-academic-skills: eine kuratierte, mehrsprachige Bibliothek von 182 installierbaren Skills; 842 Sterne und 72 Forks.hkcanan/katmer-code: eine Multi-Provider-Seitenleiste für Obsidian (Claude, Gemini, Codex); 473 Sterne und 32 Forks; vorgestellt auf Hacker News am 22. März 2026 („Show HN: KatmerCode – Claude Code in Obsidian with academic research skills”, 2 Punkte, 0 Kommentare).claesbackman/AI-research-feedback: Skills für die Begutachtung akademischer Forschung; 471 Sterne und 83 Forks.lingzhi227/agent-research-skills(297 Sterne und 37 Forks),wentorai/research-plugins(280 Sterne, 350+ Skills und MCP-Konfigurationen) undfranklee16/academic-research-skills(211 Sterne).aspi6246/Claude-Code-Skills-for-Academics(152 Sterne und 31 Forks): Das README zitiert es als Inspiration für die Anti-Context-Rot-Verbesserungen von v3.1.timpara/opencode-academic-research(49 Sterne und 11 Forks): ein Port für OpenCode (4 Skills, 13 Befehle).kael-odin/awesome-academic-research-skills(52 Sterne): ein automatisiertes, tägliches „Ranking” auf Chinesisch von akademischen Forschungs-Skills auf GitHub. Es ist der sichtbarste nicht-englische Port als kuratierte Liste.YuanyuanMa03/academic-research-skills(54 Sterne): eine auf CNKI (eine chinesische akademische Datenbank) ausgerichtete Variante.
THIRD_PARTY.md selbst listet zudem ClawMama (von kinhunt, ein gehosteter Dienst, der eine Testversion der Pipeline via Telegram/WhatsApp anbietet) und OrcaRouter (ein OpenAI-/Anthropic-kompatibles Gateway als Anbieter für Cross-Verifikation) und erkennt Yila-AI/sci-ssci-skills (von @MissOrangePeel) als „Upstream”-Projekt an, den Ursprung des in v3.19.0 adaptierten „Aussagestärke-Leiter”-Mechanismus. In GitHub Discussions kündigt kengo006 an, dass das Projekt alexandria ARS in seinem README zitiert, und YujxZJCN stellt Teaching Skills vor, eine architektonisch von ARS inspirierte „lehrseitige” Schwester-Suite.
Diese Zahlen sind das, was die GitHub-API/-Suche während dieser Recherche zurückgab; sie sind kein Qualitäts-, Support- oder Kompatibilitätsaudit jedes Ablegers.
Zahlen zum Repo
Messung: 28. August 2026, GitHub-API.
| Metrik | Wert |
|---|---|
| Sterne | 44.043 |
| Forks | 3.493 |
| Abonnenten (Watchers) | 120 |
| Commits | 748 |
| Von der API angegebene offene Issues | 18 |
| Hauptsprache | Python |
| Lizenz | CC BY-NC 4.0 |
| Erstellung | 26. Februar 2026 |
| Letzte Aktivität | 27. August 2026 |
| Letzte Veröffentlichung | v3.21.1, 24. August 2026 |
Die 748-Commits-Zahl wurde von der letzten Seite des Paginierungslinks der Commits-API ermittelt. Die GitHub-API nutzt open_issues_count; dieses Feld kann offene Pull Requests einschließen, weshalb die 18 „Issues” nicht als reine Issue-Zahl gelesen werden sollten. Das Feld subscribers_count (120) wird separat gemeldet, weil watchers_count in der allgemeinen Antwort meist die Sternezahl dupliziert.
Die wichtigsten von der API zurückgegebenen Contributor nach Beitragszahl waren Imbad0202 (720), 2023Anita (8), ktao732084-arch (3), madtriceps (3) und akshath-raj (2), gefolgt von mehreren mit einem Beitrag. Die sehr starke Konzentration auf den Maintainer spiegelt wider, dass dies, anders als bei superpowers, im Wesentlichen ein Einzelautor-Projekt mit kleineren Community-Beiträgen ist (Tippfehlerkorrekturen, Zeitschriftenlisten, Fachmodule).
Wie man beiträgt
CONTRIBUTING.md dokumentiert einen konkreten Fork-und-PR-Prozess (kein direkter Push):
- Das Repository auf GitHub forken, den Fork klonen, einen Branch erstellen, die Änderungen vornehmen, zum Fork pushen und einen PR gegen
Imbad0202/academic-research-skillsöffnen. - Was schnell akzeptiert wird (zügige Merges): Tippfehler- und Formatierungskorrekturen, neue Pipeline-Ausgabebeispiele, Übersetzungsverbesserungen (zh-TW/EN).
- Was Maintainer-Review erfordert: Zeitschriftenlisten und Referenzfelder, Bewertungssets (Goldstandard-Papers für den Kalibrierungsmodus), neue Referenzdateien, Drift-Korrekturen, Modusänderungen.
- Was Genehmigung + vorherige Diskussion erfordert (zuerst ein Issue öffnen): Änderungen an Agentendefinitionen (
*/agents/*.md), Änderungen an mit IRON RULE markierten Regeln, Ethik- und Integritätsregeln, Änderungen an Handoff-Schemata (shared/handoff_schemas.md), neue Skills oder Modi. - Plattform-Ports (nur von der Community gepflegt): in zwei Formen akzeptiert — ein In-Tree-Wrapper (
<platform>/) oder eine Schwester-Distribution in einem separaten Repo — und erfordern einen benannten Maintainer, Ende-zu-Ende-Nachweis eines vollständigenacademic-pipeline-Durchlaufs auf der Plattform, Abgleich von Aussagen und Belegen sowie einen Hinweis zur Modellportabilität.
Die Entscheidungsregeln des Maintainers sind explizit: Präzision vor Vollständigkeit; menschliche Aufsicht immer (Beiträge, die die Aufsicht verringern oder autonome Papergenerierung ermöglichen, werden abgelehnt); keine Umgehung der Erkennung; und Fachvielfalt ist willkommen. PRs müssen ein einziges Anliegen pro PR haben, das Was und Warum beschreiben, Issues referenzieren und die betroffenen sprachlichen READMEs synchron halten. Durch das Beitragen stimmt der Contributor zu, dass seine Arbeit unter CC BY-NC 4.0 lizenziert wird.
Wie die Community es aufnahm
Die gesammelten Belege zeigen breite Adoption (44.000 Sterne, Dutzende Ports, Video-Tutorials) zusammen mit konkreter Kritik. Die Hauptquelle mit verifizierbaren Ankern ist der Hacker-News-Thread 48083919 „Academic Research Skills for Claude Code”, eingereicht von arnon am 10. Mai 2026, mit 82 Punkten und 25 Kommentaren (neun Top-Level-Kommentare). Genannte Nutzer und ihre Positionen:
evanwolf: „Academic skills are a vector for cite injection” — akademische Skills als Vektor für Zitations-Injection (Sicherheits-/Prompt-Injection-Risiko).m3kw9: „Research paper slop starting pack” — ein „Starterpaket für Fülltext-Papers”.apwheele: „There needs to be a new name for people creating these with no obvious validation. Skill spam?”, woraufelashrimit „Skill-slop” antwortet.SubiculumCode: weist auf den Widerspruch hin, dass „die Seite damit eröffnet, wie sie Menschen im Loop hält, aber beim Weiterlesen fast wie eine vollständige Automatisierungsfunktion wirkt”.mmooss: verteidigt den Autor unter Berufung auf das dialektische Experiment und das „Frame-Lock”-Framework;janpeukerstimmt zu, dass es „zu weit geht”, mag aber den sokratischen State-Challenge-Reflect-Modus;cyanydeezfügt hinzu, dass die Trainingsmethode bewirkt, dass „Uneinigkeit die Token-Generierung stoppt”.varispeed: ein starker technischer Einwand: „Diese Dinge werden nicht zuverlässig sein, wenn du nicht weißt, wann deine Sitzung zu einem minderwertigeren Modell geroutet wird. Habe deswegen aufgehört, Opus zu nutzen… Das sagt, es sei für keine ernsthafte Arbeit bereit.”mdxmaker: „Academic Skills brauchen auch geeignete Werkzeuge, da viele Papers hinter Paywalls oder Anti-Bot-Systemen stecken.”implexa_founder: „Forschungs-Skills scheitern anders als Dev-Skills: Forschungs-Skills müssen die falschen Wege behalten, sonst wurde das eigentliche Artefakt entfernt.”
Auf der positiven Seite ist das Video-Tutorial-Ökosystem umfangreich: „How To Use Claude For Academic Research (My Actual AI Stack)” von Prof. David Stuckler (58.031 Aufrufe), „Claude 4 Just Made Research 10x Faster” von Andy Stapleton (81.337 Aufrufe), „Master Claude for Researchers | Step-by-step Tutorial” von WiseUp Communications (180.624 Aufrufe), „Claude Cowork for Academics: Full Setup & Use Cases” von Andy Stapleton (77.873 Aufrufe), und auf Spanisch „Habilidades de investigación académica: escribe trabajos de investigación 10 veces más rápido” von CLI Stack (666 Aufrufe) und „Cómo usar Claude Skills para investigación académica (guía paso a paso)” von Muhammad Irfan (2.672 Aufrufe).
In dieser Recherche konnten keine Reddit-Threads mit Inhalt abgerufen werden (die API lieferte HTML-Blockaden, und der PullPush-Spiegel lieferte keine Ergebnisse), ebenso wenig eine verifizierbare X/Twitter-Ankündigung (der Account des Autors veröffentlicht keinen twitter_username) oder eine Product-Hunt-Launch-Seite mit verifizierbarer Zählung. Es wird daher kein Sentiment jenseits des Zitierten von diesen Plattformen abgeleitet; Video-Zahlen und Hacker-News-Kommentare sind die direkt abgerufenen Rezeptionsquellen.
ARS im Vergleich zu anderen Ansätzen
| Ansatz | Verifizierbare Überschneidung | Verifizierbarer Unterschied |
|---|---|---|
aspi6246/Claude-Code-Skills-for-Academics (152 ⭐) | Eine Skill-Sammlung für Akademiker auf Claude Code. | Das README von ARS zitiert es als Inspiration für die Anti-Context-Rot-Verbesserungen von v3.1; es ist eine frühere, kleinere Sammlung, kein zehnstufiger Orchestrator mit Integritätsgates. |
HughYau/AcademicForge (2.491 ⭐) | Eine kuratierte Skill-Sammlung fürs akademische Schreiben. | Präsentiert sich als „One Forge, All Skills”: eine Sammlung, nicht die mehrstufige Pipeline mit Fünf-Gutachter-Panel und modellübergreifender Verifikation, die ARS auszeichnet. |
aipoch/medical-research-skills (1.771 ⭐) | Akademische/medizinische Forschungs-Skills für Agenten. | Spezialisiert auf medizinische Forschung (Protokolldesign); ARS ist standardmäßig fachübergreifend im Hochschulwesen, und ARS selbst hat Vorschläge für ein klinisches Modul erhalten (ein Issue von ktao732084-arch). |
timpara/opencode-academic-research (49 ⭐) | Derselbe Arbeitsinhalt (4 Skills, 13 Befehle). | Es ist ein Port von ARS für OpenCode, kein unabhängiger Wettbewerber; ARS ist die Referenzdistribution für Claude Code. |
Imbad0202/academic-research-skills-codex (9.453 ⭐) | Derselbe Arbeitsinhalt und dieselbe Philosophie. | Es ist ARS’ Schwester-Distribution für Codex, kein Wettbewerber: gleiche Lizenz, gleicher Autor. |
Der nützlichste Vergleich ist nicht der nach Popularität: ARS sticht hervor, wenn man einen durchgängigen Prozess von Forschung zu Publikation mit Integritätsverifikation und menschlicher Aufsicht an jedem Gate durchsetzen will. Eine generische Skill-Sammlung mag vorzuziehen sein, wenn nur Fragmente gebraucht werden; ein Domänen-Set (medizinisch, chinesisches CNKI), wenn die Domäne Regeln erfordert, die der allgemeine Ablauf nicht enthält.
Anwendungsfälle
- Einzelforscher, die einen Paper ohne verfügbaren Gutachter schreiben: Die Pipeline
academic-paper+academic-paper-reviewersimuliert ein Fünf-Gutachter-Panel plus einen „Advocatus Diaboli” und erzeugt eine Redaktionsentscheidung sowie eine Umschreibkarte — etwas, das der Artikel des Autors als seinen zentralen Schmerzpunkt identifiziert („niemand, der deine Arbeit überprüft”). - Doktoranden, die ein systematisches Review oder eine Meta-Analyse durchführen: Der Modus
systematic-reviewenthält PRISMA-2020-Vorlagen, einen Bias-Risk-Agenten (RoB 2 + ROBINS-I mit Ampel-Ausgabe) und einen Meta-Analyse-Agenten (Effektgrößen, Heterogenität, Forest Plot, GRADE), mit Zitationsverifikation per Websuche. - Wer die Integrität von Referenzen vor der Einreichung prüfen muss: Die Integritätsgates an den Stufen 2,5 und 4,5 sowie die Modi
fact-check/citation-checkadressieren direkt die „Zitationsangst”, die der Autor beschreibt; das dokumentierte Post-Publikations-Audit (21/68 Fehler) zeigt den Wert externer Verifikation. - Studierende, die ihr eigenes Urteilsvermögen trainieren wollen, nicht nur einen Entwurf erhalten: Der sokratische Modus mit dem State-Challenge-Reflect-Protokoll zwingt zur Vorhersage, bevor Belege gesehen werden — eine Nutzung, die das README selbst als „Methodentraining” positioniert.
- Forschungsteams oder -abteilungen mit gemeinsamem Workflow: Die Lizenz CC BY-NC 4.0 erlaubt gemeinsame nicht-kommerzielle akademische Nutzung (Gruppen, Labore, Abteilungen), und die Stilkalibrierung anhand früherer Papers hilft, Konsistenz in Teams zu wahren.
- Autoren, die die KI-Nutzung korrekt pro Publikationsort erklären wollen: Der Modus
disclosureerzeugt KI-Nutzungserklärungen für ICLR, NeurIPS, Nature, Science, ACL, EMNLP und eine v2-Datenbank mit medizinischen und chinesischsprachigen Zielen, im Einklang mit dem Prinzip „unterstützend, nicht täuschend”. - Nutzer anderer Plattformen als Claude Code: Die Schwester-Distribution für Codex, der Port für OpenCode, der Pi-Wrapper und die Community-Ports erweitern die Reichweite auf Umgebungen, die keine Claude-Code-Plugins unterstützen.
Ressourcen
- Repository: https://github.com/Imbad0202/academic-research-skills
- Dokumentation und Einrichtung: https://github.com/Imbad0202/academic-research-skills/blob/main/docs/SETUP.md
- Architektur (einzige Quelle der Wahrheit): https://github.com/Imbad0202/academic-research-skills/blob/main/docs/ARCHITECTURE.md
- Positionierung und Philosophie: https://github.com/Imbad0202/academic-research-skills/blob/main/POSITIONING.md
- Modus-Register (27 Modi): https://github.com/Imbad0202/academic-research-skills/blob/main/MODE_REGISTRY.md
- Offizielle Skills (4
SKILL.md): https://github.com/Imbad0202/academic-research-skills/tree/main - Schwester-Distribution für Codex: https://github.com/Imbad0202/academic-research-skills-codex
- Experiment-Begleiter: https://github.com/Imbad0202/experiment-agent
- Drittanbieter- und Upstream-Projekte: https://github.com/Imbad0202/academic-research-skills/blob/main/THIRD_PARTY.md
- Launch-Ankündigung des Autors: https://edwardwu223235.substack.com/p/academic-writing-shouldnt-be-a-solo
- Zenodo-Zitation: https://doi.org/10.5281/zenodo.20696614
- Hacker-News-Thread (82 Punkte, 25 Kommentare): https://news.ycombinator.com/item?id=48083919
- Video-Tutorials: Prof. David Stuckler (youtube.com/watch?v=GWtx-d3dALQ), Andy Stapleton (youtube.com/watch?v=YTRxrEKNBx0), WiseUp Communications (youtube.com/watch?v=bANtRh9qIWM); auf Spanisch CLI Stack (youtube.com/watch?v=ZLB2CkiuuQ0) und Muhammad Irfan (youtube.com/watch?v=whaKrmfy01s)
- Verwandte npm-Pakete:
academic-research-kit,@wentorai/research-plugins,@portos-wang/academic-research-skills-pi-extension(registry.npmjs.org) - Community: GitHub Discussions im Repository aktiviert; der Maintainer verweist auf seine Support-Seite (buymeacoffee.com/crucify020v). In den abgerufenen Quellen wurde kein offizieller Discord-Server gefunden.
Hinweis: Dieser Artikel kombiniert das README, POSITIONING.md, CONTRIBUTING.md, THIRD_PARTY.md, docs/SETUP.md, MODE_REGISTRY.md und die Release-Notizen von ARS, die GitHub-API, das Zenodo-Register, den Launch-Artikel des Autors auf Substack sowie Hacker-News- und YouTube-Ergebnisse, abgerufen am 28. August 2026. Zahlen ändern sich mit der Zeit; die aufgeführten Ports und Drittanbieterprojekte sind vom Maintainer von ARS nicht auditiert oder empfohlen.
Kommentare