

codebase-memory-mcp: ein Code-Wissensgraph für KI-Agenten
DeusData/codebase-memory-mcp · 44.891★ · 3.668 forks
Alles Wissenswerte über DeusData/codebase-memory-mcp: ein in C geschriebener MCP-Server, der ein Repository als persistenten Wissensgraphen indexiert, damit Programmier-Agenten Struktur abfragen können, statt Dateien einzeln zu lesen. Am 1. September 2026 stand es bei 41.626 Sternen.
Was codebase-memory-mcp ist
codebase-memory-mcp ist ein MCP-Server (Model Context Protocol) für Code-Intelligenz. Er indexiert ein Repository in einen persistenten Wissensgraphen — Funktionen, Klassen, Aufrufketten, HTTP-Routen und Verbindungen zwischen Diensten —, den der bereits genutzte KI-Agent mit 15 Werkzeugen abfragt, statt Dateien mit grep und sequenziellem Lesen zu durchsuchen.
Es ist kein Sprachmodell: das README definiert es als ein Backend zur strukturellen Analyse, das kein LLM enthält. Die Intelligenzschicht ist der MCP-Client (Claude Code, Cursor, Codex oder jeder kompatible Agent), der die Frage des Nutzers in Graphabfragen übersetzt. Das README dokumentiert diesen Ablauf mit einem Beispiel: bei der Frage „was ruft ProcessOrder auf?” ruft der Agent trace_path(function_name="ProcessOrder", direction="inbound") auf, der Server führt die Abfrage aus und liefert das strukturierte Ergebnis zurück.
Es wird als eine einzige statische native ausführbare Datei verteilt — in reinem C geschrieben, ohne Sprach-Runtime, ohne Docker und ohne API-Schlüssel —, wobei die tree-sitter-Grammatiken, die Cypher-Engine, die semantische Auflösungsschicht und die Visualisierungsoberfläche im Binary verlinkt sind. Laut README läuft die gesamte Verarbeitung lokal, und das Projekt sammelt keine Telemetrie.
Der Ursprung: 412.000 Tokens gegenüber 3.400
Das Repository wurde am 24. Februar 2026 von DeusData erstellt, einem GitHub-Konto, dessen Profil den Autor als Martin Vogel ausweist (Konto erstellt im April 2021). Das erste Release, v0.0.2, erschien am 25. Februar 2026; am 1. September 2026 gab es 46 Releases.
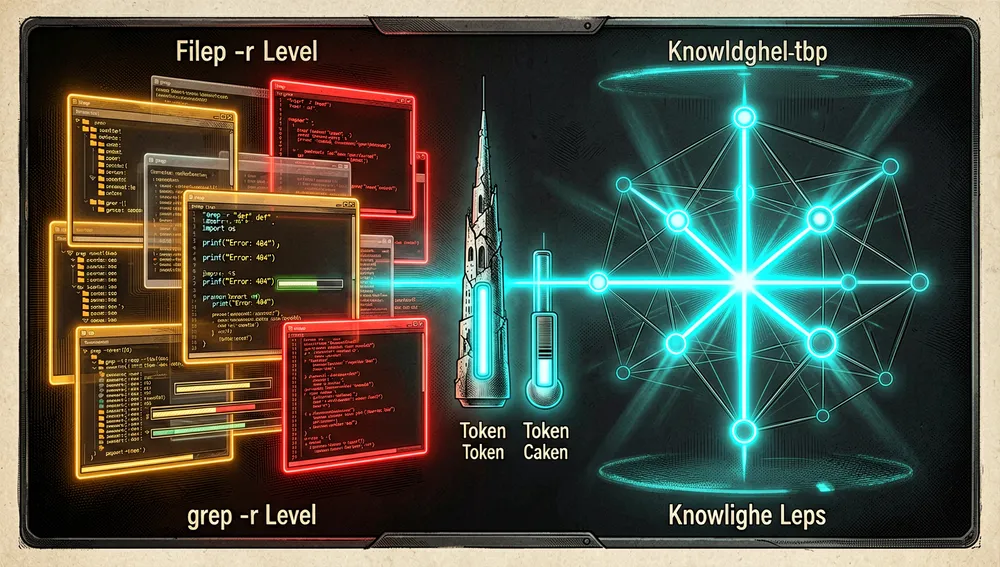
Die Ursprungsgeschichte ist der eigene Launch des Autors auf Hacker News, 47234516 („I replaced grep-based code exploration with a knowledge graph – 10x less token”, 3. März 2026, 4 Punkte und 3 Kommentare). DeusData schrieb, das Werkzeug sei entstanden, weil Code-Assistenten (Claude Code, Cursor, Codex) Codebasen durchsuchen, indem sie „Dateien einzeln grepen”: fünf strukturelle Fragen zu einem Repository verbrauchten mit dateiweiser Suche etwa 412.000 Tokens, dieselben fünf Fragen über den Graphen etwa 3.400 Tokens. In seinem Kommentar merkt der Autor an, dass es bei der Reduktion nicht nur darum gehe, den Kontext „passend zu machen”, und ein Nutzer, sturza, forderte sofort Genauigkeitsmessungen — eine Forderung, die das Projekt Monate später mit einem Preprint beantwortete.
Die Geschichte enthält zudem einen dokumentierten Implementierungswechsel: das Projekt war ursprünglich in Go geschrieben und wurde in v0.5.0 auf reines C umgeschrieben, wie CONTRIBUTING.md ausdrücklich erklärt („This project is a pure C binary (rewritten from Go in v0.5.0)”). Die Community fragte prompt nach: in den GitHub Discussions eröffnete DaniDeer den Thread „Maybe a strange question, and can be closed shortly: But why C?” (29. Juli 2026), als vom Autor beantwortet markiert.
Die technische Begründung wurde als Paper veröffentlicht: der Preprint „Codebase-Memory: Tree-Sitter-Based Knowledge Graphs for LLM Code Exploration via MCP” (arXiv:2603.27277) beschreibt das über 31 reale Repositories evaluierte System: 83 % Antwortqualität gegenüber 92 % bei einem dateibasierten Explorations-Agenten, mit 10-fach weniger Tokens und 2,1-fach weniger Werkzeugaufrufen; bei nativen Graphabfragen (Hub-Erkennung, Aufrufer-Ranking) erreicht oder übertrifft es den Explorer in 19 von 31 Sprachen. Anders gesagt: das eigene Paper des Projekts räumt ein, dass die Qualität pro Abfrage etwas geringer ist als bei erschöpfender Exploration, im Austausch gegen eine massive Token-Ersparnis.
Philosophie und Prinzipien
Das README und die Dokumentation drücken eine Reihe überprüfbarer Designentscheidungen aus:
- Der Agent ist das Gehirn, der Graph ist das Gedächtnis: kein eingebettetes LLM, kein API-Schlüssel, kein gehosteter Dienst. Das README argumentiert, andere Code-Graph-Werkzeuge betten ein LLM ein, um natürliche Sprache in eine Graphabfrage zu übersetzen, was Schlüssel, Kosten und ein weiteres zu konfigurierendes Modell hinzufügt; hier ist „der Agent, mit dem du ohnehin schon sprichst, der Abfrage-Übersetzer”.
- Extreme Geschwindigkeit als Anforderung, nicht als Extra: vollständige Indexierung des Linux-Kernels (28 Mio. Zeilen, 75.000 Dateien) in 3 Minuten; Beziehungsabfragen unter 1 ms. Die Pipeline ist „RAM-first”: LZ4-Kompression, In-Memory-SQLite und ein einziger Dump am Ende.
- Ein einziges Binary, null Abhängigkeiten: mitgelieferte Grammatiken, gebündelte Bibliotheken (SQLite, yyjson, mimalloc, xxhash, tre, nomic), kein Docker und keine Runtime. Der Installer erkennt installierte Agenten und konfiguriert ihre dokumentierten MCP-Einträge.
- Sicherheit als erklärte Priorität: das README eröffnet seinen Sicherheitsabschnitt mit „Security is Priority #1 for us”. Jedes Release unterzieht 24 ausführbare Kandidaten (ohne Strip, debug-ungestrippt und gestrippt, über 8 Release-Produkte hinweg) vor der Veröffentlichung VirusTotal, erzeugt SLSA-Level-3-Nachweise, signiert mit Sigstore cosign, veröffentlicht SHA-256-Prüfsummen und blockiert die Pipeline, wenn CodeQL offene Warnungen hinterlässt.
- Lokale Privatsphäre: alles geschieht auf der Maschine des Nutzers; dieselbe „Null-Telemetrie”-Garantie übersetzt sich in einen dokumentierten freiwilligen Diagnoseprozess (
CBM_DIAGNOSTICS=1), der eine Gedächtnis-Trajektorie intrajectory.ndjsonerfasst, die der Nutzer einem Issue beifügen kann. - Ehrlichkeit bei den Zahlen: das README verlinkt
docs/MEASURING_SAVINGS.mdund weist darauf hin, dass die exakte Reproduktion seiner Zahlen „die ursprünglichen Eingaben und Rohartefakte erfordert”.
Wie es funktioniert
Das System hat laut README und docs/BENCHMARK.md vier Hauptblöcke:
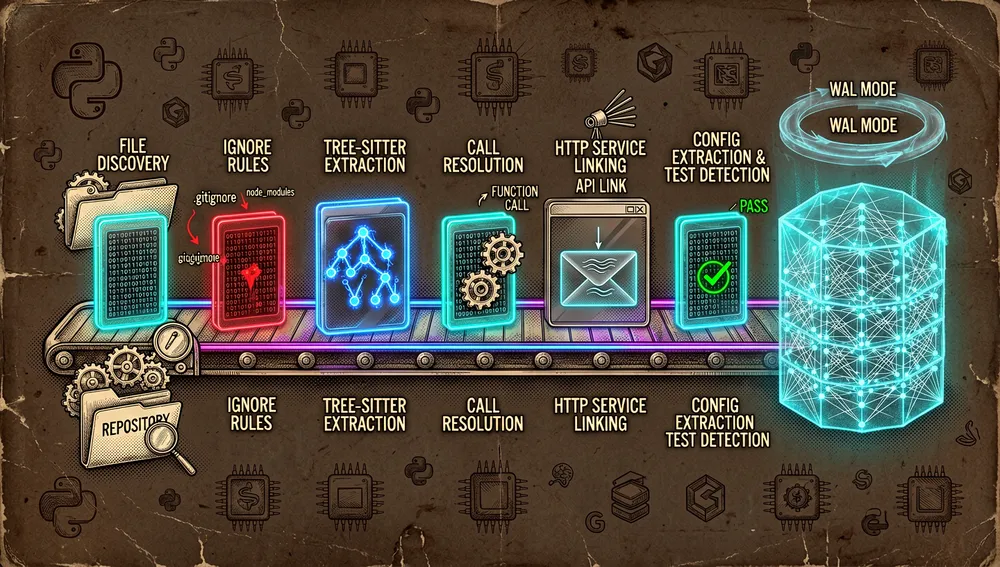
- Mehrstufige Indexierungs-Pipeline: Dateierkennung (unter Beachtung von
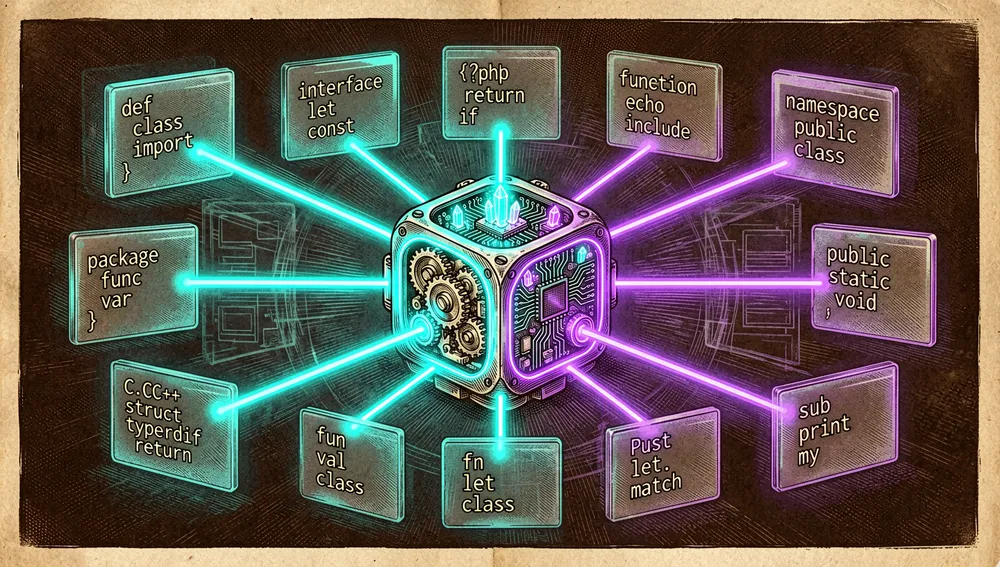
.gitignoreund einer eigenen.cbmignore) → Definitionsextraktion mit tree-sitter → Aufrufauflösung → HTTP-Verknüpfungen zwischen Diensten → Konfiguration → Tests. Das README kündigt 162 unterstützte Sprachen an; sein Abschnitt „Indexing pipeline” und die Repository-Beschreibung nennen 158 mitgelieferte tree-sitter-Grammatiken, die im Binary kompiliert sind.
- Hybrid LSP: über dem syntaktischen Durchgang von tree-sitter eine C-Implementierung von Typauflösungsalgorithmen, „strukturell inspiriert von und kompatibel mit den wichtigsten Sprachservern” (tsserver/typescript-go, pyright, gopls, Roslyn, Eclipse JDT, rust-analyzer), für 10 Sprachfamilien: Python, TypeScript/JavaScript/JSX/TSX, PHP, C#, Go, C/C++, Java, Kotlin, Rust und Perl. Verfeinert
CALLS/CALL_REFERENCE-Kanten wie ein „Gehe zu Definition” einer IDE, ohne pro Projekt einen Sprachserver zu starten.
- SQLite-Graphspeicher (WAL-Modus, ACID) unter
~/.cache/codebase-memory-mcp/, mit FTS5 (ein für camelCase/snake_case sensibler Tokenizer) und einer eigenen, in C geschriebenen, schreibgeschützten Cypher-Engine (eine Teilmenge von openCypher). - MCP-Dienstschicht + Koordinationsdaemon: 15 angekündigte MCP-Werkzeuge (die README-Tabelle führt 14 auf, und der Funktionsabschnitt ergänzt
semantic_querymit im Binary kompiliertennomic-embed-code-Embeddings). Ein Daemon pro Konto teilt Watcher, Indexierungsjobs und die 3D-Grafik-UI unterlocalhost:9749zwischen Sitzungen von Claude Code, Codex, OpenCode und anderen Clients.
Zu den konkreten Fähigkeiten gehören: Erkennung von totem Code, Wirkungsanalyse eines git diff mit Risikoklassifizierung (detect_changes), Louvain-Gemeinschaftserkennung, semantische Vektorsuche ohne API, Erkennung von Ereigniskanälen (EMITS/LISTENS_ON) für Socket.IO/EventEmitter, Indexierung von Infrastructure-as-Code (Dockerfiles, Kubernetes-Manifeste, Kustomize) sowie ein geteiltes Team-Artefakt, .codebase-memory/graph.db.zst, komprimierbar und commit-fähig, damit Teammitglieder nicht von Grund auf neu indexieren müssen (typisches Verhältnis 8–13:1, mit automatischem merge=ours in .gitattributes).
Die lokale Testsuite dokumentiert 6.768 Tests in 120 Suiten, ausgeführt mit ASan+UBSan (scripts/test.sh, derselbe Einstiegspunkt, den auch CI nutzt).
Offizieller und halboffizieller Status
- Community-Liste von MCP-Servern:
punkpeye/awesome-mcp-servers(die Referenzliste der MCP-Community) führtDeusData/codebase-memory-mcpmit seinem Glama-Bewertungsabzeichen und beschreibt es als „Code-intelligence engine that indexes a repo into a persistent knowledge graph… 159 languages via tree-sitter + Hybrid LSP… ~99% fewer tokens than grep”. - Registrierungsmanifest: das Repository enthält seit dieser Recherche ein
server.jsonim Wurzelverzeichnis (io.github.DeusData/codebase-memory-mcp, Version 0.10.8, npm- und PyPI-Pakete, stdio-Transport), das vom zentralen MCP-Register geforderte Format. Die Diskussion, die es vorschlug, war „Register in MCP Registry for better discovery” (LukasHeimann, 24. Juli 2026); der Maintainer antwortete am 25. Juli, dass Manifest und MCPB fehlten und ein OCI-Container eine „echte” Wartungsverpflichtung wäre. Das Manifest existiert nun inmain; ob der Server tatsächlich im zentralen Register gelistet ist, konnte in dieser Recherche nicht verifiziert werden (die API-Abfrage lieferte für den getesteten Pfad einen 404-Fehler), sodass dieser konkrete Status unbestätigt bleibt. - Anerkennung in Repository-Listen: in den GitHub Discussions kündigte ahkdees (14. Juli 2026) an, das Projekt sei im PR #38 von „Repository Radar” erschienen; astandrik kündigte (5. August 2026) einen von der Community gepflegten „Skill” für das Projekt in
github/awesome-copilotan (die tatsächliche Aufnahme wurde in dieser Recherche nicht verifiziert). - Redaktionelle Berichterstattung: das Projekt wurde als Fallstudie im Show-HN-Thread von Semble präsentiert (48169874, 445 Punkte, 17. Mai 2026), wo Nutzer
_ink_fragte, ob Semble codebase-memory-mcp ersetzen oder verbessern würde — ein Zeichen, dass CBM bereits als Referenz in der Nische fungierte.
In den konsultierten Quellen existiert keine formale Empfehlung eines Anbieters und keine Standardbezeichnung: es handelt sich um ein unabhängiges Ein-Personen-Projekt mit Zugkraft aus Community-Listen und Paketregistern.
Das Ökosystem
Repositories des Autors
Das Konto von DeusData (Martin Vogel) umfasst neben codebase-memory-mcp eine Reihe kleinerer Repositories: mehrere Forks von „awesome”-Listen für MCP und Claude Code (awesome-mcp-servers-1/2/3, awesome-claude-code, awesome-claude-code-2, awesome-claude, awesome-claude-code-plugins, best-of-mcp-servers, Letzteres ein wöchentliches Ranking von MCP-Servern) sowie Forks von tree-sitter-Grammatiken (tree-sitter-dockerfile, tree-sitter-perl, tree-sitter-swift, tree-sitter-sql, tree-sitter-scss, tree-sitter-groovy, tree-sitter-r, tree-sitter-erlang, tree-sitter-dart), passend zu den im Binary mitgelieferten Grammatiken. Alle Nebenprojekte haben zwischen 0 und 5 Sternen; das Gewicht des Kontos liegt beim Hauptprojekt.
Community-Forks und -Werkzeuge
win4r/codebase-memory-mcp-pro: beschreibt sich selbst als „Community fork of DeusData/codebase-memory-mcp (MIT) — incremental-reindex CALLS-edge fix + 9 integrated upstream PRs”. 224 Sterne und 44 Forks (erstellt am 21. Juni 2026, zuletzt aktualisiert am 5. Juli 2026). Unterscheidet sich vom Original durch eine Korrektur derCALLS-Kanten bei der inkrementellen Reindexierung und die Integration von neun Upstream-PRs.- In den GitHub Discussions (Kategorie „Show and tell”) hat die Community, ohne offizielle Zugehörigkeit, präsentiert:
cbm-tool(ein plattformübergreifender CLI-Assistent zum Indexieren und Konfigurieren von Editoren, vorgestellt von fxjs am 18. Juli 2026) und „Better Codebase Memory MCP”, ein VS-Code-Panel zur Bedienung der Engine (vorgestellt von smoochy am 14. August 2026); neo37 (25. August 2026) schlug vor, den Graphen mit einem Community-Wiki zu koppeln, das das „Warum” hinter Entscheidungen festhält. - Im README genannte benachbarte Werkzeuge: das README selbst vergleicht sein Team-Artefakt mit dem Verzeichnis
graphify-out/von graphify, was CBM in direkten Kontakt mit jenem Ökosystem bringt.
Verwandte Projekte und Konkurrenten
| Projekt | Sterne (GitHub-API, 1. September 2026) | Beziehung |
|---|---|---|
Graphify-Labs/graphify | 113.213 | Verwandelt jede Codebasis (samt Dokumentation, SQL-Schemas, Konfigurationen und PDFs) in einen abfragbaren Wissensgraphen; erstellt am 3. April 2026. Das README von CBM nennt es als verwandten Geist für das geteilte Artefakt. |
oraios/serena | 28.704 | Ein MCP-Toolkit mit semantischer Abfrage und Bearbeitung auf Symbolebene über tree-sitter; erstellt am 23. März 2025. Genannt von ipiyer im Ask HN 47659469. |
MinishLab/semble | 5.976 | Schnelle Codesuche für Agenten („99 % fewer tokens than grep+read”); dessen Show HN (445 Punkte) diskutiert CBM direkt. |
elbruno/graphify-dotnet | 90 | Ein Port von graphify auf .NET 10 (Copilot SDK + MCP). |
TtTRz/graphify-rs | 61 | Eine Rust-Neuimplementierung von graphify. |
CBM unterscheidet sich von den beiden größten Konkurrenten im Ansatz: graphify nimmt auch Nicht-Code-Dokumentation auf (PDF, SQL, Konfiguration), und serena fügt semantisches Bearbeiten hinzu; CBM setzt auf das ultraschnelle Einzelbinary, 158+ Sprachen, ein eigenes Hybrid LSP und die Integration über 45 Client-Oberflächen mit vordefinierten Scout/Verify/Auditor-Subagenten.
Repo-Kennzahlen
Messung: 1. September 2026, GitHub-API (aktueller Stand der Repository-Seite).
| Kennzahl | Wert |
|---|---|
| Sterne | 41.626 |
| Forks | 3.387 |
| Abonnenten | 171 |
| Von der API angegebene offene Issues | 552 |
| Hauptsprache | C |
| Lizenz | MIT |
| Erstellung | 24. Februar 2026 |
| Letzter Push | 1. September 2026 |
| Letzte Veröffentlichung | v0.10.8, 19. August 2026 (insgesamt 46 Releases; das älteste, v0.0.2, vom 25. Februar 2026) |
| Zuletzt abgefragter Commit | a824d82a34, 2026-09-01T12:18:32Z („Merge pull request #1939 from xkchok/fix/go-cross-package-field-dispatch”) |
| Testsuite | 6.768 Tests in 120 Suiten (laut README) |
Die GitHub-API nutzt open_issues_count, was offene Pull Requests einschließen kann (die Seite zeigt 445 Issues und 107 PRs); das sollte nicht als reine Issue-Zahl gelesen werden.
Die wichtigsten Beitragenden laut API, nach Anzahl der Beiträge: DeusData (1.459), shanemccarron-maker (53), dependabot[bot] (39), 86208620 (19), atirna (13), musichen (10), Flipper1994 (9), jstar0 (9), rarepops (9), WarGloom (9). Die Aktivität ist stark auf den Autor konzentriert.
Paket-Downloads (offizielle APIs, 1. September 2026):
| Register | Letzte 7 Tage | Letzte 30 Tage |
|---|---|---|
npm (codebase-memory-mcp, v0.10.8) | 9.040 | 43.448 |
PyPI (codebase-memory-mcp) | 1.374 | 18.255 |
Wie man beiträgt
Die CONTRIBUTING.md dokumentiert einen anspruchsvollen Prozess:
- Ausschließlich C-Code: „This project is a pure C binary (rewritten from Go in v0.5.0). Please submit C code, not Go. Go PRs may be ported but cannot be merged directly”.
- Build: das Repository klonen,
git config core.hooksPath scripts/hooks(aktiviert Sicherheitsprüfungen bei Pre-Commit) undscripts/build.sh; das Binary landet inbuild/c/codebase-memory-mcp. - Tests:
scripts/test.sh(Build mit ASan + UBSan und vollständiger Suite),scripts/lint.sh(clang-tidy, cppcheck und clang-format; alles muss bestehen, auch im Hook), undmake -f Makefile.cbm security(8 Schichten: Allow-List-Audit, Binary-String-Scan, UI-Audit, Installer-Audit, Netzwerk-Egress-Test, MCP-Robustheits-Fuzzing sowie Integrität mitgelieferter Abhängigkeiten und des Frontends). - Konventionelle Commits:
type(scope): descriptionmit den Typenfeat,fix,test,refactor,perf,docs,chore. - Immer zuerst ein Issue: jeder PR muss auf ein Tracking-Issue verweisen (
Fixes #NoderCloses #N) mit vorheriger Diskussion; PRs ohne vorherige Diskussion werden geschlossen. Ausnahme: Bugfixes und das Hinzufügen von Tests. - Ausdrückliche Genehmigung erforderlich für: Änderungen der API-Oberfläche (Hinzufügen, Entfernen, Umbenennen von MCP-Werkzeugen oder Änderung von Standardwerten), neue Pipeline-Durchgänge oder Indexierungsalgorithmen, Änderungen am Build-System, Projektkonfiguration (CLAUDE.md, Skills,
.mcp.json, CI), neue Abhängigkeiten und Breaking Changes. - Ein Issue pro PR, idealerweise unter 500 Zeilen; Features nicht mit Fixes vermischen.
Für Sprachunterstützung berührt der dokumentierte Ablauf internal/cbm/lang_specs.c und extract_*.c (die tree-sitter-Schicht) oder die Durchgänge von src/pipeline/ (Aufrufauflösung, HTTP-Verknüpfungen), mit Regression in tests/test_pipeline.c und Verifikation gegen ein reales offenes Repository.
Wie die Community reagierte
Die abgerufenen Belege zeigen konkreten technischen Enthusiasmus, aber auch eine bescheidene öffentliche Präsenz und messbare Kritik:
Hacker News:
- Der Launch-Thread 47234516 (DeusData, 3. März 2026) erhielt 4 Punkte und 3 Kommentare. Der meistzitierte Kommentar, von sturza, fragt „Any accuracy measurements?” — die Forderung nach Belegen, die das Projekt Monate später mit dem arXiv-Preprint beantwortete.
- 48596084 („High-performance code intelligence MCP server”, eingereicht von giamma, 19. Juni 2026) erhielt 3 Punkte und 2 Kommentare. denn-gubsky schrieb, er habe es von Claude Code aus installiert und ein Repository mit 3.500 Knoten in unter 2 Sekunden indexiert („Outstanding”), kritisierte aber die Navigation der 3D-UI: der Zoom „zentriert sich nicht auf die Mausposition”, was die direkte Auswahl und Vergrößerung eines Knotens erschwert. aniokono meinte, „Things like these should be getting more views and comments irrespective of who added it” — eine ausdrückliche Anerkennung, dass Sichtbarkeit nicht der wahrgenommenen Qualität entsprach.
- 48579579 (vantareed, 18. Juni 2026) erhielt 3 Punkte und 0 Kommentare.
- Im Ask HN 47659469 („SoTA of Context Building Methods”, 5 Punkte) erscheint das Projekt als eine der Optionen im Bereich „context building MCPs”.
- Im Show HN von Semble 48169874 (445 Punkte) fragte Nutzer ink, ob Semble codebase-memory-mcp ersetzen oder verbessern würde, wenn beide zusammen genutzt werden — ein Zeichen, dass CBM bereits ein Referenzpunkt der Nische war, wenn auch ohne ausführliche Weiterentwicklung.
Es wurden keine verifizierbaren Reddit-Threads gefunden (Abfragen an old.reddit lieferten Weiterleitungen, und die konsultierten Aggregatoren lieferten keine Ergebnisse), ebenso wenig eine zugängliche Product-Hunt-Seite (die Website antwortete mit einer Cloudflare-Challenge); daher werden keine Kennzahlen dieser Plattformen behauptet.
GitHub Discussions (Hauptkanal der Community):
- Reale Installationskritik: iandol eröffnete „V0.10 update / install fails” (11. August 2026, 5 Kommentare, als vom Autor beantwortet markiert) und „V0.10.2 — Install errors with Opencode & Hermes” (12. August 2026, 11 Kommentare, mit Beteiligung von Galaxy-VN und dem Maintainer selbst) — zwei Threads derselben Woche, die zeigen, dass Updates Installationen weniger verbreiteter Agenten beschädigten.
- Positionierungsfragen: DenTheProgrammer, „How does this differ with graphify?” (24. Juni 2026, 5 Upvotes, vom Autor beantwortet); charger89, „Q: does this tool replace/overlap with these other tools?” und „does this project complement codegraph?” (16. August 2026, beide unbeantwortet); DaniDeer, „But why C?” (29. Juli 2026, beantwortet).
- Fortgeschrittene Nutzung durch die Community: rajeshgmv präsentierte (6. August 2026) eine Multi-Agent-Datenherkunftserkennung, gebaut auf CBMs Graphabfragen; listepo bat um Multi-Projekt-Unterstützung (12. August 2026).
Video (YouTube-Suche, 1. September 2026): das Projekt hat ein nennenswertes spanisch- und englischsprachiges Publikum: „Save tokens in Claude Code with Codebase Memory MCP (free)” vom Kanal Joaquín Ruiz — IA para Desarrolladores (46.498 Aufrufe), „Dale MEMORIA a CLAUDE CODE - codebase-memory-mcp vs graphify” von chris.enprod (8.671 Aufrufe), „Should You Install Codebase-Memory-MCP? Here’s What You Need to Know” von Prospectus Lab (6.499 Aufrufe) und „Unlock Claude’s Memory: Knowledge Graph MCP Server Tutorial” von JeredBlu (6.694 Aufrufe), unter anderen.
Die messbarste Kritik stammt vom Projekt selbst: das eigene Preprint des Projekts (arXiv:2603.27277) berichtet, die Antwortqualität des grafenbasierten Ansatzes liege bei 83 % gegenüber 92 % bei dateiweiser Exploration, im Austausch gegen 10-fach weniger Tokens und 2,1-fach weniger Aufrufe. Wer sich für CBM entscheidet, akzeptiert diesen von den eigenen Autoren dokumentierten Kompromiss.
codebase-memory-mcp im Vergleich zu anderen Ansätzen
| Ansatz | Verifizierbare Übereinstimmung | Verifizierbarer Unterschied |
|---|---|---|
Graphify-Labs/graphify (113.213 Sterne) | Ein abfragbarer Code-Wissensgraph; das README von CBM vergleicht sein Team-Artefakt mit graphify-out/. | Graphify nimmt auch Dokumentation, SQL-Schemas, Konfigurationen und PDFs auf; CBM konzentriert sich auf Code und die Geschwindigkeit eines Einzelbinarys, und seine Agentenintegration umfasst Subagenten und Hooks pro Client. |
oraios/serena (28.704 Sterne) | Ein auf tree-sitter basierendes Code-MCP mit semantischer Navigation auf Symbolebene. | Serena fügt semantisches Bearbeiten hinzu (Ersetzen von Symbolkörpern, Einfügungen, Umbenennung); CBM ist strukturell schreibgeschützt und ergänzt lokale semantische Vektorsuche, HTTP/gRPC/GraphQL-Verbindungen zwischen Diensten und eine 3D-UI. |
MinishLab/semble (5.976 Sterne) | Codesuche für Agenten mit demselben Argument „~99 % weniger Tokens als grep”. | Semble ist eine Codesuchmaschine (Indexierung + Suche); CBM ist ein vollständiger struktureller Graph mit Cypher, Aufrufverfolgung, Diff-Wirkung und Erkennung von totem Code. |
| Native Agenten-Exploration (Grep/Glob/Read) | Die Alternative, die CBM ersetzt; laut eigenem Preprint bessere Qualität pro Antwort (92 % vs. 83 %). | Kosten: ~412.000 Tokens gegenüber ~3.400 im von den Autoren dokumentierten Szenario mit fünf strukturellen Abfragen. |
Schnellstart-Anleitung
Installation und erster Start
Voraussetzungen: keine Sprach-Runtime und kein Docker. Der Installer lädt ein statisches Binary pro Plattform herunter (macOS arm64/amd64, Linux amd64/arm64, Windows amd64).
macOS / Linux (eine Zeile):
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bashWindows (PowerShell): install.ps1 herunterladen, Unblock-File .\install.ps1 und .\install.ps1 ausführen (blockiert die Ausführungsrichtlinie das Skript: Set-ExecutionPolicy -Scope Process Bypass).
Installer-Optionen: --skip-config (nur das Binary, ohne Agenten zu konfigurieren) und --dir=<path> (benutzerdefinierter Speicherort). Dokumentierte Paketalternativen: npm, PyPI, Homebrew, Scoop, WinGet, Chocolatey, AUR (yay -S codebase-memory-mcp-bin) und ein Nix-Flake (nix run github:DeusData/codebase-memory-mcp).
Nach Abschluss den Code-Assistenten neu starten und ihn bitten, „Index this project”. Der Befehl install erkennt installierte Agenten und schreibt deren MCP-Einträge (45 Oberflächen: 39 automatische und 6 bedingte). Verifikation: in Claude Code sollte /mcp codebase-memory-mcp mit seinen Werkzeugen anzeigen.
Beim ersten Start: der Koordinationsdaemon startet mit der ersten Sitzung, die Indexierung registriert sich beim Git-Watcher, um den Graphen mit Änderungen aktuell zu halten, und die Daemon-Logs landen in ~/.cache/codebase-memory-mcp/logs/. Für die grafische 3D-UI:
codebase-memory-mcp --ui=true --port=9749und http://localhost:9749 öffnen.
Typische Arbeitsabläufe
Alles kann über den Agenten in natürlicher Sprache oder über die Einzelaufruf-CLI (codebase-memory-mcp cli <werkzeug>) erledigt werden, die den Daemon nicht startet:
- Ein Repository indexieren:
codebase-memory-mcp cli index_repository --repo-path /absoluter/pfad/zum/repo; das Ergebnis bleibt in~/.cache/codebase-memory-mcp/erhalten, und der Watcher hält es aktuell. - Symbole finden:
codebase-memory-mcp cli search_graph --project my-project --name-pattern '.*Handler.*' --label Function(der Projektname stammt auscli list_projects); die Ausgabe ist JSON, geeignet fürjq. - Aufrufe verfolgen:
codebase-memory-mcp cli trace_path --project my-project --function-name Search --direction both(BFS, Tiefe 1–5; Aliastrace_call_path). - In Cypher abfragen:
codebase-memory-mcp cli query_graph --project my-project --query 'MATCH (f:Function) RETURN f.name LIMIT 5'; für toten Code zum BeispielWHERE NOT EXISTS { (f)<-[:CALLS]-() }. - Die Wirkung eines Diffs prüfen: der Agent ruft
detect_changesauf, was den nicht committetengit diffauf betroffene Symbole mit Risikoklassifizierung abbildet. - Die Architektur verstehen:
get_architectureliefert in einem Aufruf Sprachen, Pakete, Einstiegspunkte, Routen, Hotspots, Schichten und Cluster.
Wesentliche Konfiguration
codebase-memory-mcp config set auto_index true— neue Projekte beim Verbinden automatisch indexieren (mitauto_index_limit, z. B.50000, als Dateiobergrenze).config set auto_watch false— das Projekt nicht pro Sitzung beim Git-Watcher registrieren (nützlich bei vielen Projekten).config set watcher_enabled false— den Watcher-Thread vollständig abschalten; erfordertcodebase-memory-mcp daemon stop, da dies beim Start des Daemons gelesen wird.CBM_CACHE_DIR— ändert den Speicherort der Indizes (standardmäßig~/.cache/codebase-memory-mcp/); nur eine kanonische Wurzel pro Konto gleichzeitig.extra_extensionsin.codebase-memory.json(Projekt) oder in~/.config/codebase-memory-mcp/config.json(global) — ordnet eigene Erweiterungen unterstützten Sprachen zu, z. B.{"extra_extensions": {".blade.php": "php"}}.CBM_ALLOWED_ROOT— beschränktindex_repositoryauf ein Verzeichnis (für Multi-Tenant-Deployments oder nicht vertrauenswürdige Aufrufe).
Häufige Stolperfallen und Lösungen
Laut der Troubleshooting-Tabelle des READMEs und Community-Threads:
/mcpzeigt den Server nicht → prüfen, dass der Binary-Pfad in.mcp.jsonabsolut ist, und den Agenten neu starten; Rauchtest:echo '{}' | /absoluter/pfad/binarysollte mit JSON antworten.index_repositoryschlägt fehl → einen absoluten Pfad verwenden (repo_path="/absolute/path").trace_pathliefert 0 Ergebnisse → zuerst den exakten Namen mitsearch_graph(name_pattern=".*PartialName.*")finden.- Ergebnisse aus dem falschen Projekt → immer
project="name"hinzufügen;list_projectszeigt gültige Namen. - Binary nach der Installation nicht gefunden →
~/.local/binzumPATHhinzufügen. - Die UI lädt nicht → prüfen, dass mit
--ui=truegestartet wurde (bei Nix weigert sich das Standardpaketdefault, die UI bereitzustellen;#codebase-memory-mcp-uiverwenden). - Alle Versionen müssen übereinstimmen: Daemon, MCP-Server, Hooks und CLI teilen sich eine Zulassungsschranke für den exakten Build; ein Prozess mit anderer Version schlägt fehl, bevor er arbeitet, und protokolliert den Konflikt in
logs/daemon-conflicts.ndjson. Updates erfolgen über das Installationsskript (unter Windows eine Anforderung, da eine ausführbare Datei sich nicht selbst ersetzen kann), und das Binary stellt von sich aus keine Netzwerkanfragen. - Microsoft Defender kann das Binary markieren als
Trojan:Script/Wacatac.B!ml: das README dokumentiert dies als Fehlalarm (typischerweise 61 von ~62 sauberen Engines; dieselbe Familie betrifftgh, llama.cpp, Godot und Microsofts Go-Toolchain), mit überprüfbaren Belegen in SECURITY.md. - Update-Fehlalarme (Thread von iandol, 11.–12. August 2026): bei Agenten wie OpenCode oder Hermes schlug das Update auf v0.10 fehl; der Maintainer antwortete im Thread, und es wurde gelöst; bei einem Update sollten offene Sitzungen des Agenten neu gestartet werden.
Integrationen und Migration
- Mit jedem MCP-Client: Claude Code, Codex CLI, Gemini CLI, Cursor, Windsurf, VS Code/Copilot, Zed, OpenCode, Aider, KiloCode, Cline, Warp, OpenHands, Amp, Devin, Tabnine, Factory Droid, GitLab Duo, Rovo Dev, Qwen Code, Kimi Code und andere (vollständige Matrix im README). Über den MCP-Eintrag hinaus fügt der Installer Skills, dauerhafte Anweisungen und, wo der Client es dokumentiert, dreistufige Subagenten hinzu: Scout (schnelle Entdeckung mit 3–4 Aufrufen), Verify (gezielte Belege, die Standardstufe) und Auditor (begrenzter Umfang mit Paginierungsabdeckung), zusammen mit Fail-open-Hooks, die bei der Nutzung von Grep/Glob/Bash/Read Graphkontext injizieren, ohne den Aufruf je zu blockieren.
- Mit CI/CD:
scripts/ci/smoke-artifact.shprüft das gepackte Artefakt; SLSA-Level-3-Signaturen werden mitgh attestation verify <file> --repo DeusData/codebase-memory-mcp --signer-workflow .../_build.ymlverifiziert, und die Prüfsummen auschecksums.txtwerden in den Installern validiert. - Mit dem Team:
.codebase-memory/graph.db.zstins Repository committen, damit Teammitglieder ohne Reindexierung klonen können (Artefakt-Import + inkrementelle Indexierung ihres Diffs);.codebase-memory/zur.gitignorehinzufügen, wenn man lieber von Grund auf neu indexiert. - Migration von nativer Exploration (grep/read): keine Datenmigration nötig — es genügt, das Repository zu indexieren und den Agenten die Graph-Werkzeuge nutzen zu lassen; das README bietet
docs/MEASURING_SAVINGS.md, um die Token-Ökonomie in der eigenen Umgebung zu messen. Zwischen Graph-Werkzeugen (z. B. von graphify oder serena) existiert kein dokumentierter Konverter: das Repository müsste von Grund auf neu indexiert werden.
Anwendungsfälle
- Entwickler, die täglich mit Claude Code, Codex, Cursor oder einem der 45 unterstützten Clients an großen Repositories arbeiten: die fünf strukturellen Abfragen im Beispiel des Autors kosten ~3.400 statt ~412.000 Tokens, und die vollständige Indexierung des Linux-Kernels dauert 3 Minuten. Das ist der zentrale Anwendungsfall: Agenten, die aufhören, „blind zu lesen” (wie es das Video von chris.enprod betitelt), und stattdessen Struktur abfragen.
- Teams, die ein großes Repository teilen: das commit-fähige Artefakt
.codebase-memory/graph.db.zsterspart jedem neuen Teammitglied die Reindexierung (Kompression 8–13:1, keine Merge-Konflikte dank automatischemmerge=ours). - Ingenieure für Änderungsprüfung:
detect_changesbildet den offenen Diff auf betroffene Symbole mit Risikoklassifizierung ab, undtrace_pathbeantwortet „was bricht, wenn ich X anfasse?” mit Graph-Belegen, bevor die Überprüfung vorgeschlagen wird. - Architekten und Microservices-Teams: die Verknüpfung zwischen Diensten (HTTP-Routen, gRPC, GraphQL, tRPC, Ereigniskanäle mit
EMITS/LISTENS_ON,CROSS_*-Kanten zwischen Repos) und die Multi-Galaxie-3D-UI unterstützen die Abbildung von Abhängigkeiten zwischen Diensten; der von rajeshgmv veröffentlichte Fall (Multi-Agent-Datenherkunft über den Graphen) zeigt das Muster. - Maintainer, die Sicherheit und Lieferkette prüfen: ein Einzelbinary mit SLSA Level 3, Sigstore-Signaturen, VirusTotal-Scans pro Release und blockierendem CodeQL erlaubt es, das Artefakt vor dem Deployment zu verifizieren;
CBM_ALLOWED_ROOTerlaubt die Eingrenzung in Multi-Tenant-Deployments. - Personen, die den Stand der Technik bei „Context Building” für Agenten erforschen: der Preprint arXiv:2603.27277 und
docs/BENCHMARK.md(63/159 Sprachen, 12 Fragen pro Sprache, echte offene Repos) bieten ein reproduzierbares Protokoll zum Vergleich von Code-Graphen mit grep+read, mit dem ehrlichen Vorbehalt von 83 % Qualität gegenüber 92 % beim nativen Explorer. - Arch/Nix-Nutzer oder Paketmanager-Puristen, die keine Binaries verwalten wollen: AUR (
codebase-memory-mcp-bin), ein Nix-Flake mit und ohne UI, npm, PyPI, Homebrew, Scoop, WinGet, Chocolatey undgo installdecken praktisch alle Plattformen ab.
Ressourcen
- Repository: https://github.com/DeusData/codebase-memory-mcp
- Offizielle Dokumentation (Projektwebsite): https://deusdata.github.io/codebase-memory-mcp/
- LLM-Referenz (
docs/llms.txt): https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/docs/llms.txt - Offizielle Benchmarks: https://github.com/DeusData/codebase-memory-mcp/blob/main/docs/BENCHMARK.md
- Evaluationsplan (159 Sprachen, in Peer Review): https://github.com/DeusData/codebase-memory-mcp/blob/main/docs/EVALUATION_PLAN.md
- Wie man die Ersparnisse misst: https://github.com/DeusData/codebase-memory-mcp/blob/main/docs/MEASURING_SAVINGS.md
- Sicherheitsrichtlinie und Antivirus-Fehlalarme: https://github.com/DeusData/codebase-memory-mcp/blob/main/SECURITY.md
- Beitragsleitfaden: https://github.com/DeusData/codebase-memory-mcp/blob/main/CONTRIBUTING.md
- Technischer Preprint (arXiv:2603.27277): https://arxiv.org/abs/2603.27277
- npm-Register: https://www.npmjs.com/package/codebase-memory-mcp · PyPI: https://pypi.org/project/codebase-memory-mcp/ · AUR: https://aur.archlinux.org/packages/codebase-memory-mcp-bin
- Community (GitHub Discussions, mit Kategorien Announcements/General/Ideas/Q&A/Show and tell): https://github.com/DeusData/codebase-memory-mcp/discussions
- Launch auf Hacker News (Autor, 4 Punkte, 3 Kommentare): https://news.ycombinator.com/item?id=47234516
- Community-Thread auf Hacker News (3 Punkte, 2 Kommentare): https://news.ycombinator.com/item?id=48596084
- Gelistet in awesome-mcp-servers: https://github.com/punkpeye/awesome-mcp-servers
- Community-Fork: https://github.com/win4r/codebase-memory-mcp-pro
- Videos: „Save tokens in Claude Code with Codebase Memory MCP (free)” — Joaquín Ruiz — IA para Desarrolladores (46.498 Aufrufe): https://www.youtube.com/watch?v=5_5yik4Y0cw · „Dale MEMORIA a CLAUDE CODE - codebase-memory-mcp vs graphify” — chris.enprod (8.671 Aufrufe): https://www.youtube.com/watch?v=zQeutn76A4g · „Should You Install Codebase-Memory-MCP?” — Prospectus Lab (6.499 Aufrufe): https://www.youtube.com/watch?v=Y8EXg3aVZgw
Hinweis: dieser Artikel stützt sich auf das README, die CONTRIBUTING.md, den docs/-Ordner und die server.json von codebase-memory-mcp, die GitHub-API (Repos, Releases, Contributors, Commits), die npm- und PyPI-Register, die GitHub Discussions des Projekts, den Preprint arXiv:2603.27277, Hacker-News-Threads, die Liste punkpeye/awesome-mcp-servers und YouTube-Ergebnisse, konsultiert am 1. September 2026. Zahlen ändern sich mit der Zeit. Quellen auf Reddit und Product Hunt konnten während dieser Recherche nicht verifiziert werden.
Kommentare