

codebase-memory-mcp: un grafo de conocimiento del código para agentes de IA
DeusData/codebase-memory-mcp · 44.891★ · 3.668 forks
Todo lo que hay que saber sobre DeusData/codebase-memory-mcp: un servidor MCP escrito en C que indexa un repositorio como grafo de conocimiento persistente para que los agentes de programación consulten estructura en lugar de leer archivos uno a uno. A 1 de septiembre de 2026 lleva 41.626 estrellas.
Qué es codebase-memory-mcp
codebase-memory-mcp es un servidor MCP (Model Context Protocol) de inteligencia de código. Indexa un repositorio en un grafo de conocimiento persistente —funciones, clases, cadenas de llamadas, rutas HTTP y enlaces entre servicios— que el agente de IA ya en uso consulta con 15 herramientas, en vez de explorar archivos con grep y lectura secuencial.
No es un modelo de lenguaje: el README lo define como un backend de análisis estructural que no incluye ningún LLM. La capa de inteligencia es el cliente MCP (Claude Code, Cursor, Codex o cualquier agente compatible), que traduce la pregunta del usuario en consultas al grafo. El README documenta este flujo con un ejemplo: ante «¿qué llama a ProcessOrder?», el agente invoca trace_path(function_name="ProcessOrder", direction="inbound"), el servidor ejecuta la consulta y devuelve el resultado estructurado.
Se distribuye como un único ejecutable nativo estático —escrito en C puro, sin tiempo de ejecución de lenguaje, sin Docker y sin clave de API— con los gramáticos tree-sitter, el motor Cypher, la capa de resolución semántica y la interfaz de visualización enlazados en el binario. Todo el procesamiento ocurre en local y el proyecto no recopila telemetría, según su README.
El origen: 412.000 tokens frente a 3.400
El repositorio fue creado el 24 de febrero de 2026 por DeusData, cuenta de GitHub cuyo perfil identifica al autor como Martin Vogel (cuenta creada en abril de 2021). El primer release, v0.0.2, se publicó el 25 de febrero de 2026; el 1 de septiembre de 2026 llevaban 46 releases.
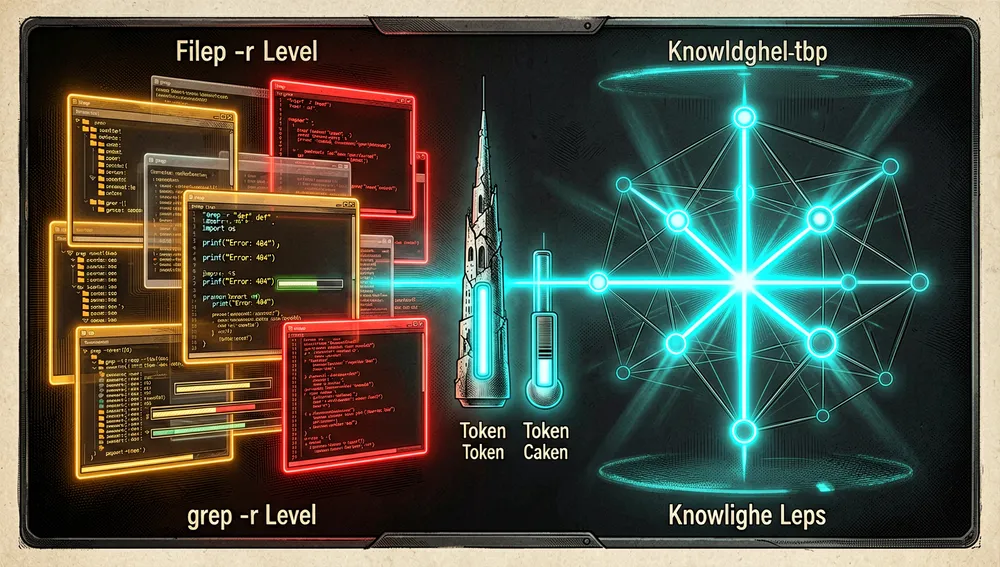
El relato de origen es el propio lanzamiento del autor en Hacker News, 47234516 («I replaced grep-based code exploration with a knowledge graph – 10x less token», 3 de marzo de 2026, 4 puntos y 3 comentarios). DeusData escribió que construyó la herramienta porque los asistentes de código (Claude Code, Cursor, Codex) exploran las bases de código «grepando archivos uno a uno»: cinco preguntas estructurales sobre un repositorio consumían unos 412.000 tokens con búsqueda archivo por archivo, y las mismas cinco preguntas mediante el grafo consumían unos 3.400 tokens. En su comentario, el autor puntualiza que la reducción no se trata solo de «encajar» el contexto, y un usuario, sturza, le pidió de inmediato mediciones de precisión —pedida que el proyecto terminó respondiendo con un preprint.
La historia tiene además un cambio de implementación documentado: el proyecto era originalmente Go y fue reescrito a C puro en la versión v0.5.0, como declara explícitamente el CONTRIBUTING.md («This project is a pure C binary (rewritten from Go in v0.5.0)»). La comunidad no tardó en preguntarlo: en las GitHub Discussions, DaniDeer abrió el hilo «Maybe a strange question, and can be closed shortly: But why C?» (29 de julio de 2026), marcado como respondido por el autor.
La justificación técnica se publicizó como paper: el preprint «Codebase-Memory: Tree-Sitter-Based Knowledge Graphs for LLM Code Exploration via MCP» (arXiv:2603.27277) describe el sistema evaluado sobre 31 repositorios reales del mundo: 83 % de calidad de respuesta frente al 92 % de un agente de exploración por archivos, con 10 veces menos tokens y 2,1 veces menos llamadas a herramientas; en consultas nativas del grafo (detección de hubs, ranking de llamadores) iguala o supera al explorador en 19 de 31 lenguajes. Es decir: el propio paper del proyecto admite que la calidad por consulta es algo menor a la exploración exhaustiva, a cambio de un ahorro masivo de tokens.
Filosofía y principios
El README y la documentación expresan una serie de decisiones de diseño verificables:
- El agente es el cerebro, el grafo es la memoria: no hay LLM embebido, ni clave de API, ni servicio alojado. El README argumenta que otras herramientas de grafo de código incrustan un LLM para traducir lenguaje natural a consulta de grafo, lo que añade claves, coste y un modelo más que configurar; aquí «el agente con el que ya estás hablando es el traductor de consultas».
- Velocidad extrema como requisito, no como extra: índice completo del kernel de Linux (28 M de líneas, 75.000 archivos) en 3 minutos; consultas de relación en menos de 1 ms. La pipeline es «RAM-first»: compresión LZ4, SQLite en memoria y un volcado único al final.
- Un solo binario, cero dependencias: gramáticos vendidos, bibliotecas empaquetadas (SQLite, yyjson, mimalloc, xxhash, tre, nomic), sin Docker ni runtime. El instalador detecta los agentes instalados y configura sus entradas MCP documentadas.
- Seguridad como prioridad declarada: el README abre su sección de seguridad con «Security is Priority #1 for us». Cada release somete los 24 candidatos ejecutables (sin strip, depurado sin strip y strip, a lo largo de 8 productos de release) a VirusTotal antes de publicar, genera evidencia SLSA Level 3, firma con Sigstore cosign, publica checksums SHA-256 y bloquea el pipeline si CodeQL deja alertas abiertas.
- Privacidad local: todo ocurre en la máquina del usuario; la misma garantía de «cero telemetría» se traduce en un proceso documentado de diagnóstico voluntario (
CBM_DIAGNOSTICS=1), que captura una trayectoria de memoria entrajectory.ndjsonque el usuario puede adjuntar a una incidencia. - Honestidad en las cifras: el README enlaza
docs/MEASURING_SAVINGS.mdy avisa de que la reproducción exacta de sus números «requiere las entradas originales y los artefactos crudos».
Cómo funciona
El sistema tiene cuatro bloques principales, según el README y docs/BENCHMARK.md:
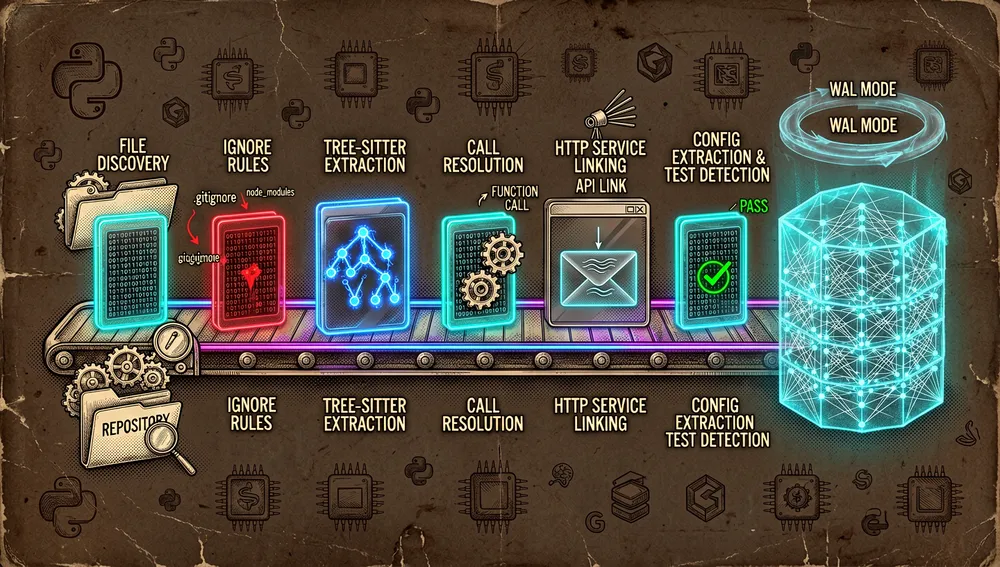
- Pipeline de indexación multi-paso: descubrimiento de archivos (respetando
.gitignorey un.cbmignorepropio) → extracción de definiciones con tree-sitter → resolución de llamadas → enlaces HTTP entre servicios → configuración → pruebas. El README anuncia 162 idiomas soportados; su sección «Indexing pipeline» y la descripción del repositorio citan 158 gramáticas tree-sitter vendidas compiladas en el binario.
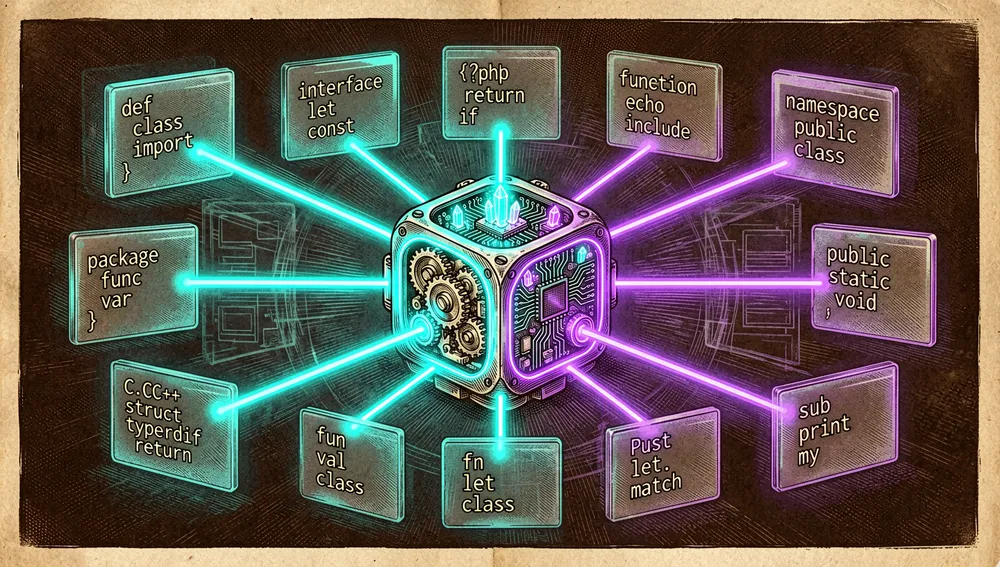
- Hybrid LSP: sobre el pase sintáctico de tree-sitter, una implementación en C de algoritmos de resolución de tipos «estructuralmente inspirados y compatibles con los principales servidores de lenguaje» (tsserver/typescript-go, pyright, gopls, Roslyn, Eclipse JDT, rust-analyzer), para 10 familias de lenguajes: Python, TypeScript/JavaScript/JSX/TSX, PHP, C#, Go, C/C++, Java, Kotlin, Rust y Perl. Refina las aristas
CALLS/CALL_REFERENCEcomo haría un «Ir a la definición» de un IDE, sin lanzar un servidor de lenguaje por proyecto.
- Almacenamiento en grafo SQLite (modo WAL, ACID) en
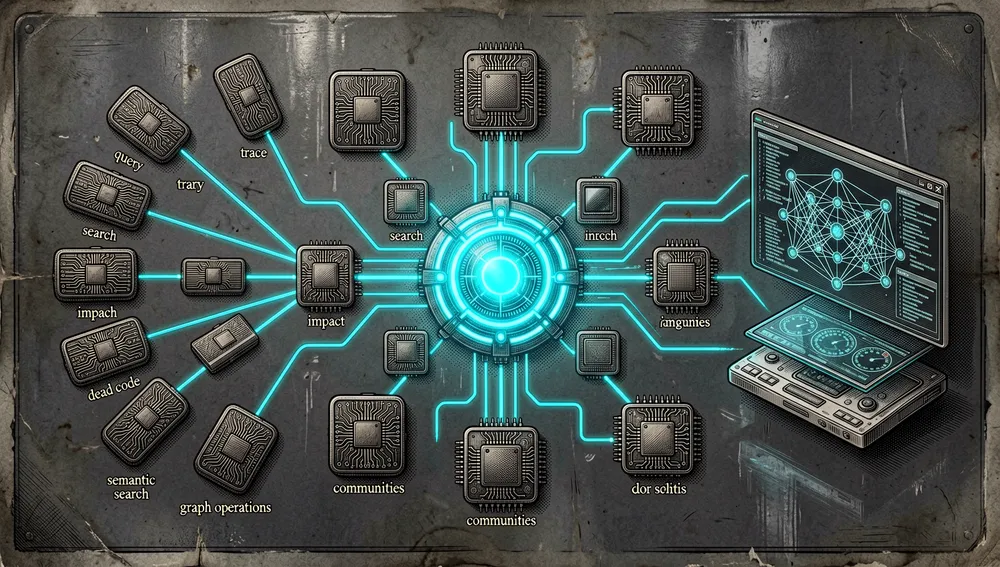
~/.cache/codebase-memory-mcp/, con FTS5 (tokenizador sensible a camelCase/snake_case) y un motor Cypher de solo lectura (subconjunto de openCypher) propio, escrito en C. - Capa de servicio MCP + demonio de coordinación: 15 herramientas MCP anunciadas (la tabla del README detalla 14, y la sección de funciones añade
semantic_querycon embeddingsnomic-embed-codecompilados en el binario). Un demonio por cuenta comparte entre sesiones de Claude Code, Codex, OpenCode y el resto de clientes los watchers, los trabajos de indexación y la UI gráfica 3D enlocalhost:9749.
Entre las capacidades concretas: detección de código muerto, análisis de impacto de un git diff con clasificación de riesgo (detect_changes), detección de comunidades de Louvain, búsqueda semántica por vectores sin API, detección de canales de eventos (EMITS/LISTENS_ON) para Socket.IO/EventEmitter, indexación de infraestructura como código (Dockerfiles, manifiestos de Kubernetes, Kustomize) y un artefacto de equipo compartido, .codebase-memory/graph.db.zst, comprimible y commiteable para que los compañeros no reindexen desde cero (relación 8–13:1 típica, con merge=ours automático en .gitattributes).
La suite de pruebas local documenta 6.768 pruebas en 120 suites ejecutadas con ASan+UBSan (scripts/test.sh, la misma entrada que usa CI).
Estado oficial y semioficial
- Lista de servidores MCP comunitaria:
punkpeye/awesome-mcp-servers(la lista de referencia de la comunidad MCP) incluye aDeusData/codebase-memory-mcpcon su insignia de puntuación de Glama, describiéndolo como «Code-intelligence engine that indexes a repo into a persistent knowledge graph… 159 languages via tree-sitter + Hybrid LSP… ~99% fewer tokens than grep». - Manifiesto de registro: el repositorio incluye desde esta investigación un
server.jsonen la raíz (io.github.DeusData/codebase-memory-mcp, versión 0.10.8, paquetes npm y PyPI, transporte stdio), el formato exigido por el registro central MCP. La discusión que lo propuso fue «Register in MCP Registry for better discovery» (LukasHeimann, 24 de julio de 2026); el maintainer respondió el 25 de julio que faltaban manifest y MCPB, y que un contenedor OCI sería un compromiso de mantenimiento «real». El manifiesto ya existe ahora enmain; no se pudo verificar desde esta ejecución que el servidor esté de hecho listado en el registro central (la consulta de la API devolvió 404 para la ruta probada), por lo que ese estado concreto queda sin confirmar. - Reconocimiento en listas de repositorios: en GitHub Discussions, ahkdees anunció (14 de julio de 2026) que el proyecto aparecía en el PR #38 de «Repository Radar»; astandrik anunció (5 de agosto de 2026) un «skill» mantenido por la comunidad para el proyecto en
github/awesome-copilot(la inclusión efectiva no se verificó en esta ejecución). - Cobertura editorial: el proyecto fue presentado como caso de estudio en el hilo Show HN de Semble (48169874, 445 puntos, 17 de mayo de 2026), donde el usuario
_ink_preguntó si Semble reemplazaría o mejoraría a codebase-memory-mcp —señal de que ya operaba como referencia en el nicho.
No existe, en las fuentes consultadas, ningún aval formal de un proveedor ni designación de estándar: es un proyecto independiente de una persona, con la tracción de las listas comunitarias y los registros de paquetes.
El ecosistema
Repositorios del autor
La cuenta de DeusData (Martin Vogel) es, además de codebase-memory-mcp, un conjunto de repositorios menores: varios forks de listas «awesome» de MCP y de Claude Code (awesome-mcp-servers-1/2/3, awesome-claude-code, awesome-claude-code-2, awesome-claude, awesome-claude-code-plugins, best-of-mcp-servers, este último un ranking semanal de servidores MCP) y forks de gramáticas tree-sitter (tree-sitter-dockerfile, tree-sitter-perl, tree-sitter-swift, tree-sitter-sql, tree-sitter-scss, tree-sitter-groovy, tree-sitter-r, tree-sitter-erlang, tree-sitter-dart), coherentes con los gramáticos vendidos en el binario. Todos los secundarios tienen entre 0 y 5 estrellas; el peso de la cuenta está en el proyecto principal.
Forks y herramientas comunitarias
win4r/codebase-memory-mcp-pro: se describe a sí mismo como «Community fork of DeusData/codebase-memory-mcp (MIT) — incremental-reindex CALLS-edge fix + 9 integrated upstream PRs». 224 estrellas y 44 bifurcaciones (creado el 21 de junio de 2026, última actualización el 5 de julio de 2026). Se distingue del original por una corrección de las aristasCALLSen la reindexación incremental y por incorporar nueve PR upstream.- En las GitHub Discussions (categoría «Show and tell») la comunidad ha presentado, sin afiliación oficial:
cbm-tool(asistente CLI multiplataforma para indexar y configurar editores, presentado por fxjs el 18 de julio de 2026) y «Better Codebase Memory MCP», un panel de VS Code para operar el motor (presentado por smoochy el 14 de agosto de 2026); neo37 (25 de agosto de 2026) planteó emparejar el grafo con una wiki comunitaria que conserve el «por qué» de las decisiones. - Herramientas vecinas citadas en el README: el propio README compara su artefacto de equipo con el directorio
graphify-out/de graphify, lo que sitúa a CBM en una conversación directa con ese ecosistema.
Proyectos relacionados y competidores
| Proyecto | Estrellas (API de GitHub, 1 de septiembre de 2026) | Relación |
|---|---|---|
Graphify-Labs/graphify | 113.213 | Convierte cualquier base de código (con documentación, esquemas SQL, configuraciones y PDF) en un grafo de conocimiento consultable; creado el 3 de abril de 2026. El README de CBM lo nombra como espíritu afín para el artefacto compartido. |
oraios/serena | 28.704 | Toolkit MCP con recuperación y edición semántica a nivel de símbolo vía tree-sitter; creado el 23 de marzo de 2025. Nombrado por ipiyer en el Ask HN 47659469. |
MinishLab/semble | 5.976 | Búsqueda de código rápida para agentes («99 % fewer tokens than grep+read»); su Show HN (445 puntos) discute directamente a CBM. |
elbruno/graphify-dotnet | 90 | Puerto de graphify a .NET 10 (Copilot SDK + MCP). |
TtTRz/graphify-rs | 61 | Reescritura de graphify en Rust. |
CBM se diferencia de los dos mayores competidores en el enfoque: graphify ingiere también documentación no código (PDF, SQL, configuración) y serena añade edición semántica; CBM apuesta por el binario único ultra-rápido, 158+ idiomas, Hybrid LSP propio y la integración en 45 superficies de cliente con subagentes Scout/Verify/Auditor predefinidos.
Números del repo
Medición: 1 de septiembre de 2026, API de GitHub (RAM actual de la página del repositorio).
| Métrica | Valor |
|---|---|
| Estrellas | 41.626 |
| Bifurcaciones | 3.387 |
| Suscriptores | 171 |
| Incidencias abiertas indicadas por la API | 552 |
| Lenguaje principal | C |
| Licencia | MIT |
| Creación | 24 de febrero de 2026 |
| Último push | 1 de septiembre de 2026 |
| Última publicación | v0.10.8, 19 de agosto de 2026 (46 releases en total; el más antiguo, v0.0.2, de 25 de febrero de 2026) |
| Último commit consultado | a824d82a34, 2026-09-01T12:18:32Z («Merge pull request #1939 from xkchok/fix/go-cross-package-field-dispatch») |
| Test suite | 6.768 pruebas en 120 suites (según README) |
La API de GitHub usa open_issues_count, que puede incluir solicitudes de cambios abiertas (la página muestra 445 incidencias y 107 PR); no debe leerse como un conteo exclusivo de incidencias.
Los principales contribuidores devueltos por la API, por número de contribuciones: DeusData (1.459), shanemccarron-maker (53), dependabot[bot] (39), 86208620 (19), atirna (13), musichen (10), Flipper1994 (9), jstar0 (9), rarepops (9), WarGloom (9). La actividad está muy concentrada en el autor.
Descargas de paquetes (APIs oficiales, 1 de septiembre de 2026):
| Registro | Últimos 7 días | Últimos 30 días |
|---|---|---|
npm (codebase-memory-mcp, v0.10.8) | 9.040 | 43.448 |
PyPI (codebase-memory-mcp) | 1.374 | 18.255 |
Cómo contribuir
El CONTRIBUTING.md documenta un proceso exigente:
- Código en C únicamente: «This project is a pure C binary (rewritten from Go in v0.5.0). Please submit C code, not Go. Go PRs may be ported but cannot be merged directly».
- Construcción: clonar el repositorio,
git config core.hooksPath scripts/hooks(activa comprobaciones de seguridad en pre-commit) yscripts/build.sh; el binario queda enbuild/c/codebase-memory-mcp. - Pruebas:
scripts/test.sh(build con ASan + UBSan y suite completa),scripts/lint.sh(clang-tidy, cppcheck y clang-format; todo debe pasar, también en el hook), ymake -f Makefile.cbm security(8 capas: auditoría de allow-list, escaneo de cadenas del binario, auditoría de UI, auditoría del instalador, prueba de egreso de red, fuzz de robustez MCP, integridad de dependencias vendidas y del frontend). - Commits convencionales:
type(scope): descriptioncon tiposfeat,fix,test,refactor,perf,docs,chore. - Incidencia primero, siempre: toda PR debe referenciar una incidencia de seguimiento (
Fixes #NoCloses #N) con discusión previa; las PR sin discusión previa se cierran. Excepción: correcciones de errores y adición de pruebas. - Aprobación explícita requerida para: cambios de superficie de API (añadir, eliminar, renombrar herramientas MCP o cambiar por defecto), nuevas pases de pipeline o algoritmos de indexación, cambios del sistema de construcción, configuración del proyecto (CLAUDE.md, skills,
.mcp.json, CI), dependencias nuevas y cambios rompedores. - Una incidencia por PR, idealmente menos de 500 líneas; no mezclar funcionalidades con correcciones.
Para soporte de lenguaje, el flujo documentado toca internal/cbm/lang_specs.c y extract_*.c (capa tree-sitter) o las pases de src/pipeline/ (resolución de llamadas, enlaces HTTP), con regresión en tests/test_pipeline.c y verificación contra un repositorio abierto real.
Cómo lo recibió la comunidad
La evidencia recuperada muestra entusiasmo técnico concreto, pero también una presencia pública modesta y críticas medibles:
Hacker News:
- El hilo de lanzamiento 47234516 (DeusData, 3 de marzo de 2026) obtuvo 4 puntos y 3 comentarios. El comentario más citado, de sturza, pregunta «Any accuracy measurements?» —la exigencia de evidencia que el proyecto respondió meses después con el preprint de arXiv.
- 48596084 («High-performance code intelligence MCP server», presentado por giamma, 19 de junio de 2026) obtuvo 3 puntos y 2 comentarios. denn-gubsky escribió que lo instaló desde Claude Code e indexó un repositorio de 3.500 nodos en menos de 2 segundos («Outstanding»), pero criticó la navegación de la UI 3D: el zoom «no centeriza en la posición del ratón», lo que dificulta seleccionar un nodo y acercarse directamente. aniokono opinó que «Things like these should be getting more views and comments irrespective of who added it» —reconocimiento explícito de que la visibilidad no compensaba la calidad percibida.
- 48579579 (vantareed, 18 de junio de 2026) sumó 3 puntos y 0 comentarios.
- En el Ask HN 47659469 («SoTA of Context Building Methods», 5 puntos) el proyecto aparece como una de las opciones del espacio de «context building MCPs».
- En el Show HN de Semble 48169874 (445 puntos), el usuario ink preguntó si Semble reemplazaría o mejoraría a codebase-memory-mcp cuando ambos se usasen juntos: una señal de que CBM era ya un punto de referencia del nicho, aunque sin desarrollo extenso.
No se encontraron hilos de Reddit verificables (las consultas a old.reddit devolvieron redirecciones y los agregadores consultados no arrojaron resultados) ni página de Product Hunt accesible (el sitio respondió con desafío de Cloudflare); por tanto no se afirman métricas de esas plataformas.
GitHub Discussions (canal principal de la comunidad):
- Crítica de instalación real: iandol abrió «V0.10 update / install fails» (11 de agosto de 2026, 5 comentarios, marcada como respondida por el autor) y «V0.10.2 — Install errors with Opencode & Hermes» (12 de agosto de 2026, 11 comentarios, con participación de Galaxy-VN y el propio maintainer) —dos hilos de la misma semana que muestran que las actualizaciones rompían instalaciones de agentes menos comunes.
- Dudas de posicionamiento: DenTheProgrammer, «How does this differ with graphify?» (24 de junio de 2026, 5 upvotes, respondida por el autor); charger89, «Q: does this tool replace/overlap with these other tools?» y «does this project complement codegraph?» (16 de agosto de 2026, ambas sin responder); DaniDeer, «But why C?» (29 de julio de 2026, respondida).
- Uso avanzado de la comunidad: rajeshgmv presentó (6 de agosto de 2026) una detección de linaje de datos multi-agente construida sobre las consultas de grafo de CBM; listepo pidió soporte multi-proyecto (12 de agosto de 2026).
Video (búsqueda de YouTube, 1 de septiembre de 2026): el proyecto tiene una audiencia notable en español e inglés: «Save tokens in Claude Code with Codebase Memory MCP (free)» del canal Joaquín Ruiz — IA para Desarrolladores (46.498 vistas), «Dale MEMORIA a CLAUDE CODE - codebase-memory-mcp vs graphify» de chris.enprod (8.671 vistas), «Should You Install Codebase-Memory-MCP? Here’s What You Need to Know» de Prospectus Lab (6.499 vistas) y «Desbloquea la memoria de Claude: Tutorial del servidor MCP del Gráfico de conocimiento» de JeredBlu (6.694 vistas), entre otros.
La crítica más medible es propia: el preprint del proyecto (arXiv:2603.27277) reporta que la calidad de respuesta del enfoque por grafo es del 83 % frente al 92 % del explorado archivo por archivo, a cambio de 10 veces menos tokens y 2,1 veces menos llamadas. Quien elija CBM está aceptando ese intercambio, documentado por sus propios autores.
codebase-memory-mcp frente a otras propuestas
| Propuesta | Coincidencia verificable | Diferencia verificable |
|---|---|---|
Graphify-Labs/graphify (113.213 estrellas) | Grafo de conocimiento del código consultable; el README de CBM compara su artefacto de equipo con graphify-out/. | Graphify incluye también documentación, esquemas SQL, configuraciones y PDF; CBM se centra en el código y en la velocidad del binario único, y su integración de agentes incluye subagentes y hooks por cliente. |
oraios/serena (28.704 estrellas) | MCP de código basado en tree-sitter con navegación semántica a nivel de símbolo. | Serena añade edición semántica (reemplazo de cuerpo de símbolo, inserciones, renombrado); CBM es de solo lectura estructural y añade búsqueda semántica por vectores local, enlaces HTTP/gRPC/GraphQL entre servicios y UI 3D. |
MinishLab/semble (5.976 estrellas) | Búsqueda de código para agentes con el mismo argumento de «~99 % menos tokens que grep». | Semble es un buscador de código (indexación + búsqueda); CBM es un grafo estructural completo con Cypher, trazas de llamadas, impacto de diffs y detección de código muerto. |
| Exploración nativa del agente (Grep/Glob/Read) | La alternativa que CBM sustituye; según el propio preprint, mejor calidad por respuesta (92 % vs 83 %). | Coste: ~412.000 tokens frente a ~3.400 en el escenario de cinco consultas estructurales documentado por los autores. |
Guía rápida de uso
Instalación y primer arranque
Prerrequisitos: ningún runtime de lenguaje ni Docker. El instalador descarga un binario estático por plataforma (macOS arm64/amd64, Linux amd64/arm64, Windows amd64).
macOS / Linux (una línea):
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bashWindows (PowerShell): descargar install.ps1, Unblock-File .\install.ps1 y ejecutar .\install.ps1 (si la política de ejecución bloquea el script: Set-ExecutionPolicy -Scope Process Bypass).
Opciones del instalador: --skip-config (solo el binario, sin configurar agentes) y --dir=<path> (ubicación custom). Alternativas de paquete documentadas: npm, PyPI, Homebrew, Scoop, WinGet, Chocolatey, AUR (yay -S codebase-memory-mcp-bin) y flake de Nix (nix run github:DeusData/codebase-memory-mcp).
Al terminar, reiniciar el agente de código y pedirle «Index this project». El comando install detecta los agentes instalados y escribe sus entradas MCP (45 superficies: 39 automáticas y 6 condicionales). Verificación: en Claude Code, /mcp debe mostrar codebase-memory-mcp con sus herramientas.
En el primer arranque: el daemon de coordinación se levanta con la primera sesión, la indexación se registra en el watcher de git para actualizar el grafo con los cambios, y los logs del daemon quedan en ~/.cache/codebase-memory-mcp/logs/. Para la UI gráfica 3D:
codebase-memory-mcp --ui=true --port=9749y abrir http://localhost:9749.
Flujos de trabajo habituales
Todo puede hacerse con el agente en lenguaje natural o desde la CLI de un solo disparo (codebase-memory-mcp cli <herramienta>), que no arranca el daemon:
- Indexar un repositorio:
codebase-memory-mcp cli index_repository --repo-path /ruta/absoluta/al/repo; el resultado persiste en~/.cache/codebase-memory-mcp/y el watcher lo mantiene fresco. - Encontrar símbolos:
codebase-memory-mcp cli search_graph --project my-project --name-pattern '.*Handler.*' --label Function(el nombre de proyecto se obtiene concli list_projects); la salida es JSON apto parajq. - Trazar llamadas:
codebase-memory-mcp cli trace_path --project my-project --function-name Search --direction both(BFS, profundidad 1–5; aliastrace_call_path). - Consultar en Cypher:
codebase-memory-mcp cli query_graph --project my-project --query 'MATCH (f:Function) RETURN f.name LIMIT 5'; para código muerto, por ejemploWHERE NOT EXISTS { (f)<-[:CALLS]-() }. - Revisar el impacto de un diff: el agente invoca
detect_changes, que mapea elgit diffno commitado a símbolos afectados con clasificación de riesgo. - Entender la arquitectura:
get_architecturedevuelve en una llamada lenguajes, paquetes, puntos de entrada, rutas, hotspots, capas y clusters.
Configuración esencial
codebase-memory-mcp config set auto_index true— indexar nuevos proyectos automáticamente al conectar (conauto_index_limit, p. ej.50000, como tope de archivos).config set auto_watch false— no registrar el proyecto en el watcher de git por sesión (útil con muchos proyectos).config set watcher_enabled false— apagar el hilo del watcher del todo; requierecodebase-memory-mcp daemon stopporque se lee al arrancar el daemon.CBM_CACHE_DIR— cambia la ubicación de los índices (por defecto~/.cache/codebase-memory-mcp/); solo una raíz canónica por cuenta a la vez.extra_extensionsen.codebase-memory.json(proyecto) o en~/.config/codebase-memory-mcp/config.json(global) — mapea extensiones propias a lenguajes soportados, p. ej.{"extra_extensions": {".blade.php": "php"}}.CBM_ALLOWED_ROOT— confinaindex_repositorya un directorio (para despliegues multiinquilino o con llamadas no confiables).
Trampas frecuentes y soluciones
Según la tabla de troubleshooting del README y los hilos de la comunidad:
/mcpno muestra el servidor → comprobar que la ruta del binario en.mcp.jsones absoluta y reiniciar el agente; prueba de humo:echo '{}' | /ruta/absoluta/binariodebe responder JSON.index_repositoryfalla → usar ruta absoluta (repo_path="/absolute/path").trace_pathdevuelve 0 resultados → localizar primero el nombre exacto consearch_graph(name_pattern=".*PartialName.*").- Resultados del proyecto equivocado → añadir siempre
project="nombre";list_projectsmuestra los nombres válidos. - Binario no encontrado tras instalar → añadir
~/.local/binalPATH. - La UI no carga → confirmar que se arrancó con
--ui=true(con Nix, el paquete estándardefaultse niega a servir el UI; hay que usar#codebase-memory-mcp-ui). - Todas las versiones deben coincidir: el daemon, el servidor MCP, los hooks y las CLI comparten una barrera de admisión por build exacto; un proceso con otra versión falla antes de trabajar y registra el conflicto en
logs/daemon-conflicts.ndjson. Las actualizaciones se hacen desde el script de instalación (en Windows es un requisito, porque un ejecutable no puede reemplazarse a sí mismo), y el binario no hace peticiones de red por su cuenta. - Microsoft Defender puede marcar el binario como
Trojan:Script/Wacatac.B!ml: el README lo documenta como falso positivo (típicamente 61 de ~62 motores limpios; la misma familia afecta agh, llama.cpp, Godot y la toolchain de Go de Microsoft), con evidencia verificable en SECURITY.md. - Falsos positivos de actualización (hilo de iandol, 11–12 de agosto de 2026): con agentes como OpenCode o Hermes la actualización a la v0.10 falló; el maintainer respondió en el hilo y se resolvió; si se actualiza, relanzar las sesiones abiertas del agente.
Integraciones y migración
- Con cualquier cliente MCP: Claude Code, Codex CLI, Gemini CLI, Cursor, Windsurf, VS Code/Copilot, Zed, OpenCode, Aider, KiloCode, Cline, Warp, OpenHands, Amp, Devin, Tabnine, Factory Droid, GitLab Duo, Rovo Dev, Qwen Code, Kimi Code y otras (matriz completa en el README). El instalador añade, además de la entrada MCP, skills, instrucciones duraderas y, donde el cliente lo documenta, subagentes de tres niveles: Scout (descubrimiento rápido con 3–4 llamadas), Verify (evidencia dirigida, el nivel por defecto) y Auditor (alcance acotado con cobertura de paginación), junto con hooks fail-open que inyectan contexto de grafo al usar Grep/Glob/Bash/Read sin nunca bloquear la llamada.
- Con CI/CD:
scripts/ci/smoke-artifact.shfuma el artefacto empaquetado; las firmas SLSA Level 3 se verifican congh attestation verify <file> --repo DeusData/codebase-memory-mcp --signer-workflow .../_build.yml, y los checksums dechecksums.txtse validan en los instaladores. - Con el equipo: commitear
.codebase-memory/graph.db.zstal repositorio y los compañeros clonan sin reindexar (importación del artefacto + indexación incremental de su diff); añadir.codebase-memory/a.gitignoresi se prefiere indexar desde cero. - Migración desde la exploración nativa (grep/read): no hay migración de datos — basta con indexar el repositorio y que el agente use las herramientas del grafo; el README ofrece
docs/MEASURING_SAVINGS.mdpara medir la economía de tokens en el propio entorno. Entre herramientas de grafo (p. ej. desde graphify o serena), no existe un conversor documentado: se reindexaría el repositorio de cero.
Casos de uso
- Desarrolladores que trabajan a diario con Claude Code, Codex, Cursor u otro de los 45 clientes soportados en repositorios grandes: las cinco consultas estructurales del ejemplo del autor cuestan ~3.400 tokens en lugar de ~412.000, y el índice completo del kernel de Linux en 3 minutos. Es el caso de uso central: agentes que dejan de «leer a ciegas» (como lo titula el video de chris.enprod) y consultan estructura.
- Equipos que comparten un repositorio grande: el artefacto
.codebase-memory/graph.db.zstcommiteable elimina la reindexación de cada nuevo compañero (compresión 8–13:1, sin conflictos de merge pormerge=oursautomático). - Ingenieros de revisión de cambios:
detect_changesmapea el diff abierto a símbolos afectados con clasificación de riesgo, ytrace_pathpermite responder «¿qué se rompe si toco X?» con evidencia de grafo antes de proponer la revisión. - Arquitectos y equipos con microservicios: el enlace entre servicios (rutas HTTP, gRPC, GraphQL, tRPC, canales de eventos con
EMITS/LISTENS_ON, aristasCROSS_*entre repos) y la UI 3D multi-galaxia soportan el mapeo de dependencias entre servicios; el caso publicado por rajeshgmv (linaje de datos multi-agente sobre el grafo) muestra el patrón. - Mantenedores que auditan seguridad y supply chain: binario único con SLSA Level 3, firmas Sigstore, escaneos VirusTotal por release y CodeQL bloqueante permiten verificar el artefacto antes de desplegarlo;
CBM_ALLOWED_ROOTpermite acotarlo en despliegues multiinquilino. - Personas que investigan el estado del arte en «context building» para agentes: el preprint arXiv:2603.27277 y
docs/BENCHMARK.md(63/159 lenguajes, 12 preguntas por lenguaje, repos abiertos reales) ofrecen un protocolo reproducible para comparar grafos de código frente a grep+read, con la advertencia honesta del 83 % de calidad frente al 92 % del explorador nativo. - Usuario de Arch/Nix o de gestor de paquetes que no quiere gestionar binarios: AUR (
codebase-memory-mcp-bin), flake de Nix con y sin UI, npm, PyPI, Homebrew, Scoop, WinGet, Chocolatey ygo installcubren la práctica totalidad de plataformas.
Recursos
- Repositorio: https://github.com/DeusData/codebase-memory-mcp
- Documentación oficial (sitio del proyecto): https://deusdata.github.io/codebase-memory-mcp/
- Referencia para LLMs (
docs/llms.txt): https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/docs/llms.txt - Benchmarks oficiales: https://github.com/DeusData/codebase-memory-mcp/blob/main/docs/BENCHMARK.md
- Plan de evaluación (159 lenguajes, en revisión por pares): https://github.com/DeusData/codebase-memory-mcp/blob/main/docs/EVALUATION_PLAN.md
- Cómo medir los ahorros: https://github.com/DeusData/codebase-memory-mcp/blob/main/docs/MEASURING_SAVINGS.md
- Política de seguridad y falsos positivos de antivirus: https://github.com/DeusData/codebase-memory-mcp/blob/main/SECURITY.md
- Guía de contribución: https://github.com/DeusData/codebase-memory-mcp/blob/main/CONTRIBUTING.md
- Preprint técnico (arXiv:2603.27277): https://arxiv.org/abs/2603.27277
- Registro npm: https://www.npmjs.com/package/codebase-memory-mcp · PyPI: https://pypi.org/project/codebase-memory-mcp/ · AUR: https://aur.archlinux.org/packages/codebase-memory-mcp-bin
- Comunidad (GitHub Discussions, con categorías Announcements/General/Ideas/Q&A/Show and tell): https://github.com/DeusData/codebase-memory-mcp/discussions
- Lanzamiento en Hacker News (autor, 4 puntos, 3 comentarios): https://news.ycombinator.com/item?id=47234516
- Hilo de la comunidad en Hacker News (3 puntos, 2 comentarios): https://news.ycombinator.com/item?id=48596084
- Listado en awesome-mcp-servers: https://github.com/punkpeye/awesome-mcp-servers
- Fork comunitario: https://github.com/win4r/codebase-memory-mcp-pro
- Videos: «Save tokens in Claude Code with Codebase Memory MCP (free)» — Joaquín Ruiz — IA para Desarrolladores (46.498 vistas): https://www.youtube.com/watch?v=5_5yik4Y0cw · «Dale MEMORIA a CLAUDE CODE - codebase-memory-mcp vs graphify» — chris.enprod (8.671 vistas): https://www.youtube.com/watch?v=zQeutn76A4g · «Should You Install Codebase-Memory-MCP?» — Prospectus Lab (6.499 vistas): https://www.youtube.com/watch?v=Y8EXg3aVZgw
Nota: este artículo combina el README, el CONTRIBUTING.md, la carpeta docs/ y el server.json de codebase-memory-mcp, la API de GitHub (repos, releases, contributors, commits), los registros npm y PyPI, las GitHub Discussions del proyecto, el preprint arXiv:2603.27277, hilos de Hacker News, la lista punkpeye/awesome-mcp-servers y resultados de YouTube consultados el 1 de septiembre de 2026. Las cifras cambian con el tiempo. No se pudieron verificar fuentes en Reddit ni en Product Hunt durante esta investigación.
Comentarios