

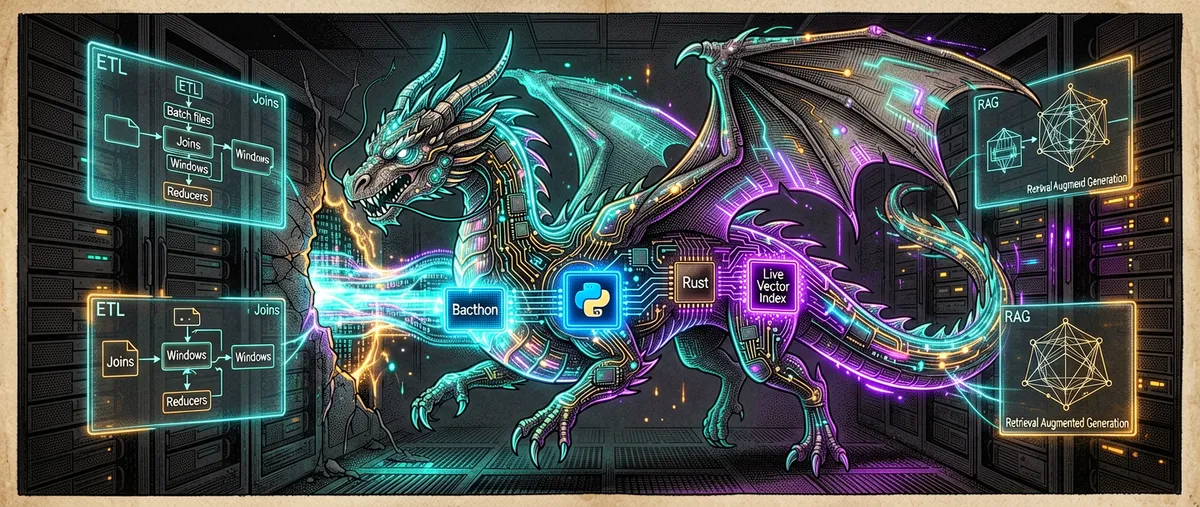
Pathway: ein Live-Daten-Framework für ETL, Echtzeit-Analytik und RAG
pathwaycom/pathway · 62.241★ · 1.681 forks
Alles Wissenswerte über pathwaycom/pathway: ein Python-ETL-Framework, dessen Rust-Engine denselben Code sowohl für Batch- als auch für Stream-Verarbeitung ausführt, mit einer Erweiterung für LLM-Pipelines und RAG. Dieser Bericht konzentriert sich auf das Repository und seine Organisation, die 2025-2026 ihr öffentliches Bild auf eine „post-transformer”-KI-Architektur (BDH) neu ausgerichtet hat.
Was Pathway ist
Das Pathway Live Data Framework (im Code als pw abgekürzt) ist ein Python-ETL-Framework für Stream-Verarbeitung, Echtzeit-Analytik, LLM-Pipelines und RAG. Es ist keine Datenbank-Engine und kein Dienst: Es ist eine Python-Bibliothek, die der Nutzer als normalen Code schreibt und die eine Rust-Engine ausführt.
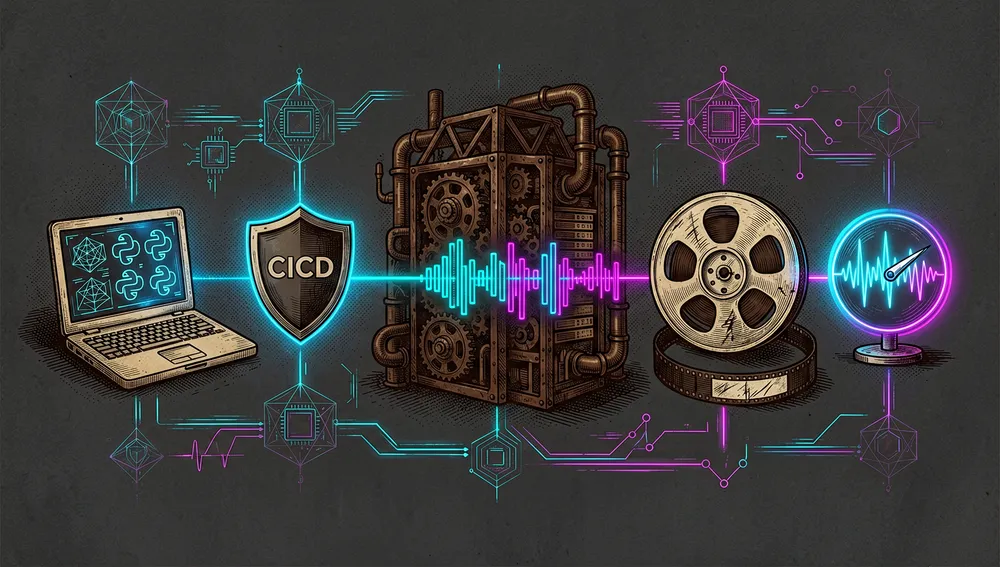
Die zentrale, im README verifizierbare Prämisse ist die Vereinheitlichung von Batch und Stream: Derselbe Code funktioniert für lokale Entwicklung, CI/CD-Tests, Batch-Jobs, Stream-Replay und Live-Stream-Verarbeitung. Die Engine basiert auf Differential Dataflow und führt inkrementelle Berechnung durch, sodass das Framework bei einer Datenänderung nur das Betroffene neu berechnet.
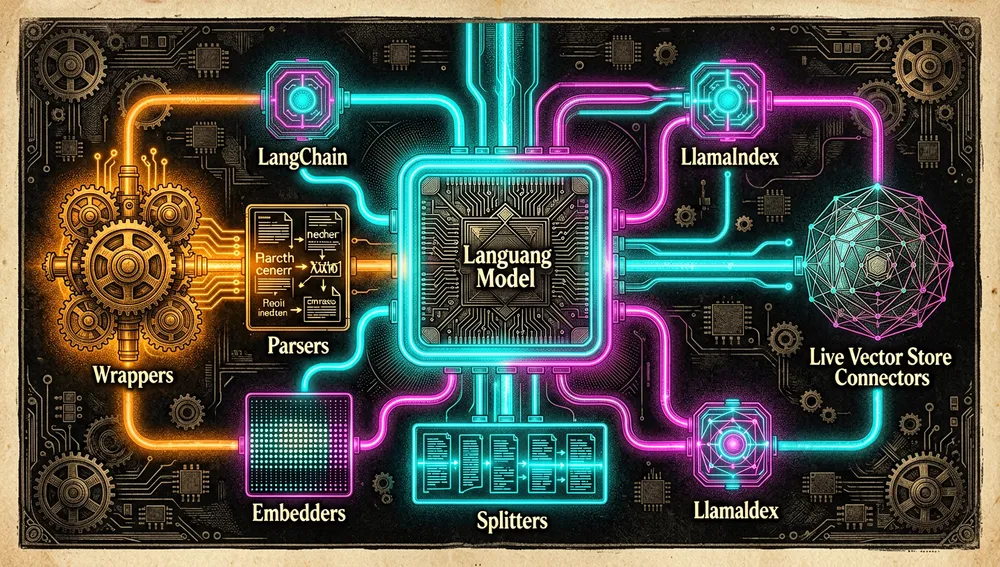
Das Produkt umfasst drei Bausteine: einen Connector zu den Quellen, Transformationen (zustandsbehaftet und zustandslos: Joins, Fenster, Sortierungen) und eine LLM-Erweiterung mit Hilfsmitteln (Wrapper, Parser, Embedder, Splitter) sowie einen live geführten In-Memory-Vektorindex, mit dokumentierten Integrationen für LangChain und LlamaIndex.
Ursprung
Das Repository wurde am 27. November 2022 unter der Organisation pathwaycom erstellt. Das Unternehmen ist Pathway mit Sitz in Polen. Die drei auf der offiziellen Website gelisteten Gründer sind:
- Zuzanna Stamirowska, CEO. Promovierte in komplexen Systemen, Absolventin der École Polytechnique, mit Netzwerkvorhersagemodellen, veröffentlicht in den National Academy of Sciences.
- Jan Chorowski, CTO. Ehemaliger Forscher bei MILA und Google Brain (unter Samy Bengio), Co-Autor von Arbeiten mit Geoffrey Hinton und früher Attention-Modelle, Co-Autor der Theano-Bibliothek; die Website nennt über 12.000 Zitationen und einen h-Index von 24. Sein GitHub-Benutzername
janchorowskiist der Autor der Show-HN-Beiträge des Projekts. - Adrian Kosowski, CSO. Promovierter Algorithmiker, ehemals Inria, über 100 Publikationen, h-Index von 29; Co-Autor des BDH-Papers.
Die verifizierbare Chronologie der Organisation laut eigenem Blog und Presse: eine Finanzierungsrunde über 10 Millionen Dollar (TechCrunch, 29. November 2024); Anerkennung als „Emerging Visionary” im GenAI-Bereich von Gartner (November 2024); eine erklärte Partnerschaft mit AWS und NVIDIA zur Bereitstellung adaptiver KI-Systeme (businesswire, 1. Dezember 2025); und eine im August 2025 angekündigte Bewertung von 500 Millionen Dollar.
Die bemerkenswerteste erzählerische Note ist eine Identitätswende: Das Repository ist ein Daten-/ETL-/RAG-Framework, aber die Startseite von pathway.com präsentiert sich heute als „Intelligence with no ceiling”, ein Frontier-KI-Labor, das BDH (Dragon Hatchling) entwickelt, eine vom Gehirn inspirierte, rekurrente „post-transformer”-Architektur. Das Paper „The Dragon Hatchling: The Missing Link between the Transformer and Models of the Brain” (arXiv 2509.26507, 2025) ist von Kosowski, Uznański, Chorowski, Stamirowska und Bartoszkiewicz unterzeichnet. Der Blog behauptet, BDH sei das zweitpopulärste KI-Paper von 2025 gewesen. Dieser doppelte Fokus — Live-Daten auf der einen, Architekturforschung auf der anderen Seite — ist die eigentliche Spannung des Projekts: Das ETL-Framework bleibt das installierbare, codebasierte Produkt, während BDH die Forschungswette ist, die die Presse einfängt (WSJ, Forbes, MIT Technology Review, Live Science, Semafor).
Philosophie und Prinzipien
Aus dem README und der Dokumentation ergeben sich diese Prinzipien, alle im offiziellen Text verifizierbar:
- Ein Code für Batch und Stream: Dieselbe Pipeline-Definition läuft lokal, in Tests, im Batch, im Replay und live.
- Inkrementelle Berechnung: Die Engine berechnet bei eintreffenden Daten nicht alles neu; sie aktualisiert nur das Abgeleitete (basierend auf Differential Dataflow).
- Python für die Logik, Rust für die Ausführung: Der Nutzer schreibt Python (und kann jede Python-Bibliothek aufrufen), aber die Rust-Engine ermöglicht Multithreading, Multiprocessing und verteilte Berechnung und umgeht so die Single-Thread-Grenze von Python.
- Persistenz und Konsistenz als Dienst: Das Framework speichert den Zustand, um nach einem Update oder Ausfall neu zu starten, und verwaltet die Zeit, indem es Ergebnisse aktualisiert, wenn verspätete oder ungeordnete Daten eintreffen.
- „Live”-RAG: Der Vektorindex wird aufgebaut und gepflegt, während sich Dokumente ändern, sodass RAG-Antworten den aktuellen Zustand der Quelle widerspiegeln.
Wie es funktioniert
Das grundlegende dokumentierte Muster (aus dem README-Beispiel) ist:
pw.io.<quelle>.read(...)verbindet sich mit der Quelle und liefert eine Tabelle (mit einem optionalenpw.Schema, das die Spalten typisiert).- Transformationen werden auf die Tabelle angewendet:
.filter(...),.reduce(...)mitpw.reducers.*, Joins, Fenster oder jede beliebige Python-Funktion. pw.io.<ziel>.write(tabelle, ...)lädt das Ergebnis in ein externes System.pw.run()startet die Berechnung.
Das Projekt läuft als normales Python-Skript: python main.py. Das Framework startet ein Monitoring-Panel (Nachrichten pro Connector, Latenz und Logs). Dokumentierte Start-Alternativen: pathway spawn python main.py und für Multithreading pathway spawn --threads 3 python main.py.
Die Engine hält die Pipeline im Speicher. Die freie Version bietet eine Konsistenzgarantie „mindestens einmal”; die Enterprise-Version bietet „genau einmal”. Mit dem Release v0.32.1 (1. August 2026) wurden unter anderem die Schreib-Connectors pw.io.chroma.write und pw.io.qdrant.write hinzugefügt, die eine Vektordatenbank-Collection synchron mit der Tabelle halten.
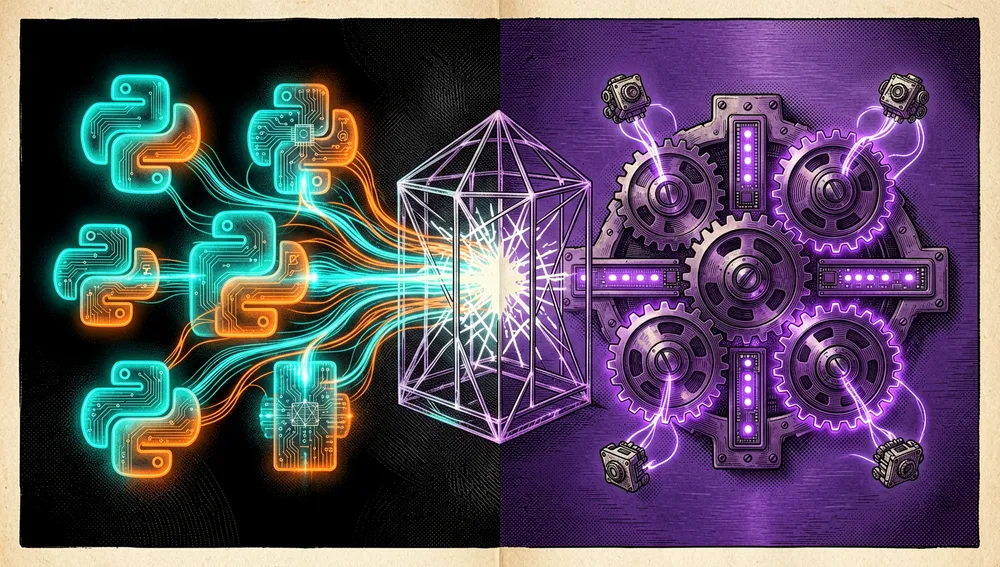
Die LLM-Erweiterung (in der Dokumentation LLM xpack genannt) fügt Wrapper für LLM-Dienste, Parser, Embedder, Splitter, einen live geführten In-Memory-Vektorindex und die LangChain-/LlamaIndex-Integrationen hinzu. Die auf der Website gelisteten „hervorgehobenen Kooperationen” umfassen Databento, LangChain, LlamaIndex, MinIO, PaddleOCR und Redpanda.
Das Ökosystem
Repositorys der Organisation pathwaycom
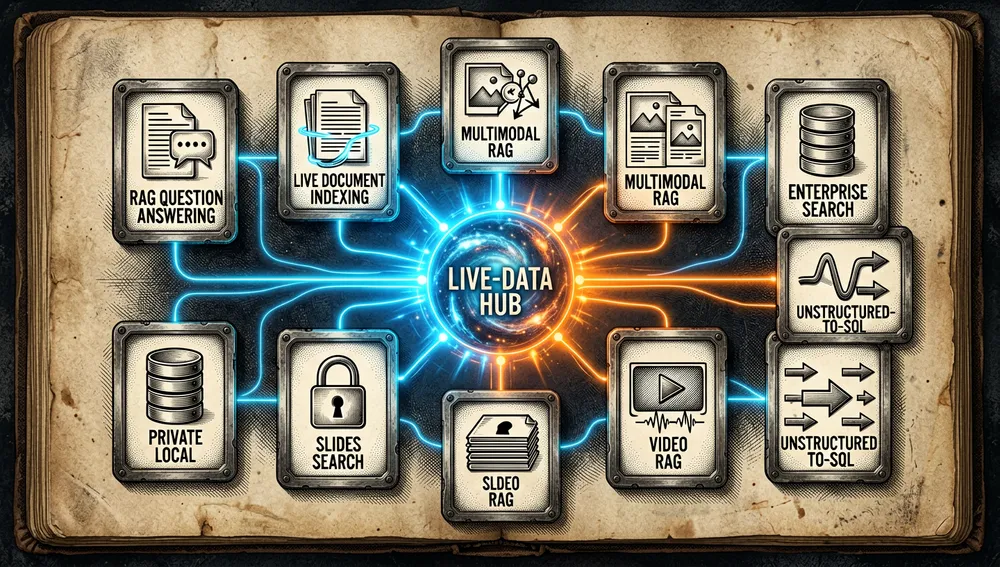
pathwaycom/llm-app: einsatzbereite Anwendungsvorlagen (RAG, Unternehmenssuche, KI-Pipelines) auf Basis des Frameworks; 58.937 Sterne und 1.479 Forks. Es ist das größte Schwester-Repository und dort lebt der Vorlagenkatalog: Question-Answering RAG App, Live Document Indexing, Multimodal RAG mit GPT-4o, Unstructured-to-SQL, Adaptive RAG App, Private RAG mit Mistral und Ollama, Slides AI Search und Video RAG mit TwelveLabs. Das README dieses Repositorys erklärt, dass der Standard-Vektorindex usearch und hybride Volltextindizes Tantivy verwenden, und dass sie separate Module für Vektordatenbank (Pinecone/Weaviate/Qdrant), Cache (Redis) und API-Framework (FastAPI) ersetzen.pathwaycom/arc-task-gen: generiert neue Aufgaben im ARC-AGI-1-Stil zur Evaluierung von Modellen wie BDH-CQ; 10.625 Sterne und 68 Forks.pathwaycom/bdh: die offizielle Implementierung der Dragon-Hatchling-Architektur (das Paper von 2025); 3.545 Sterne und 252 Forks.pathwaycom/pathway-benchmarks: Benchmarks gegen Spark, Flink und Kafka Streams; 302 Sterne und 12 Forks.pathwaycom/cookiecutter-pathway: Scaffolding-Vorlage zum Bootstrapping produktionsreifer Pathway-Projekte; 277 Sterne und 17 Forks.pathwaycom/serviette: ein als „Universal RAG tool” beschriebenes RAG-Werkzeug; 4 Sterne.
Verwandte Repositorys außerhalb der Organisation
pathway-labs/pathway-examples: Codebeispiele des Frameworks; 43 Sterne und 6 Forks (gehören zu einer anderen Organisation,pathway-labs, nicht zupathwaycom).xyphoes0727/FraudDetection(5 Sterne): eine mit Pathway gebaute Echtzeit-Betrugserkennungspipeline, ein Beispiel für Community-Adoption.
Forks
Die sternestärksten Forks des Haupt-Repositorys haben wenige Sterne (höchstens 6, z. B. sheikhsajid69/pathway), was darauf hindeutet, dass das Ökosystem eher durch offizielle Schwester-Repos und Vorlagen wächst als durch unabhängige Forks des Kerns. In dieser Recherche wurde keine Community-Übersetzung ins Spanische oder eine andere Sprache des Frameworks gefunden.
Offizieller und halboffizieller Status
Pathway ist ein Produkt mit Anbieter-Unterstützung und Anerkennung durch Dritte, kein benannter offener Standard:
- Gartner erkannte es im November 2024 als Emerging Visionary im GenAI-Bereich an.
- Es gibt eine erklärte Partnerschaft mit AWS und NVIDIA für adaptive KI-Systeme und kontinuierliches Lernen (businesswire, 1. Dezember 2025).
- Das README listet Kooperationen und Integrationen mit Databento, LangChain, LlamaIndex, MinIO, PaddleOCR und Redpanda. LangChain und LlamaIndex dokumentieren Pathway als Integration (Vektorspeicher / Retriever).
- Das Projekt erscheint in kuratierten Listen wie
vinta/awesome-python(Eintrag „pathway”, Zeile 497 des READMEs dieser Liste).
In der Praxis bedeutet das: Pathway ist eine installierbare, dokumentierte Option innerhalb der LangChain- und LlamaIndex-Ökosysteme und eine kommerzielle Alternative zu ausgereiften Streaming-Engines (Flink, Spark, Kafka Streams) mit einem Differenzierungsmerkmal bei Live-RAG. In den konsultierten Quellen gibt es keine formale Bezeichnung als „De-facto-Standard”; seine Position ist die eines vertikalen Anbieters (Live-Daten + RAG + KI) mit Presse- und Partner-Traktion.
Schnellstart-Anleitung
Installation und erster Start
Voraussetzungen: Python 3.10 oder höher und macOS oder Linux (das README rät bei anderen Systemen zu einer virtuellen Maschine).
pip install -U pathwayDas dokumentierte Minimalbeispiel (positive Werte in Echtzeit summieren) lautet:
import pathway as pw

class InputSchema(pw.Schema):
  value: int

input_table = pw.io.csv.read("./input/", schema=InputSchema)
filtered_table = input_table.filter(input_table.value >= 0)
result_table = filtered_table.reduce(
  sum_value = pw.reducers.sum(filtered_table.value)
)

pw.io.jsonlines.write(result_table, "output.jsonl")
pw.run()
Beim Ausführen von python main.py öffnet sich ein Monitoring-Panel mit Nachrichten pro Connector, Latenz und Logs. Um mit einer bestimmten Anzahl von Threads zu starten: pathway spawn --threads 3 python main.py. Im README ist ein Google-Colab-Notebook verlinkt, weitere Beispiele finden sich in examples/.
Gängige Workflows
- Echtzeit-ETL aus Kafka: Es wird eine Pipeline definiert, die ein Kafka-Topic liest, transformiert und in ein Ziel schreibt; das README verlinkt die Vorlage
kafka-etlund die Anleitung „Switch from batch to streaming”. Das Ergebnis ist eine Pipeline, die bei Eintreffen einer neuen Nachricht nur die betroffenen Berechnungen aktualisiert. - Privates, eigenständiges RAG: Aus
pathwaycom/llm-appläuft die Vorlage Private RAG mit Mistral und Ollama lokal; durch Synchronisation mit einem Ordner/Google Drive/SharePoint bleibt der Index live und Antworten spiegeln die aktuellsten Dokumente wider. - Unstructured-to-SQL: Die Vorlage
unstructured_to_sql_on_the_flyliest Finanz-PDFs, strukturiert sie in SQL, lädt sie in PostgreSQL und beantwortet Fragen in natürlicher Sprache, indem sie diese in SQL übersetzt. - Ausführung in Docker: Für ein Ein-Datei-Skript:
docker run -it --rm --name my-pathway-app -v "$PWD":/app pathwaycom/pathway:latest python my-pathway-app.py.
Wesentliche Konfiguration
pw.Schema: typisiert die Spalten einer Tabelle; optional, aber zur Validierung empfohlen.pw.io.*-Connectors: Wahl der Quelle/des Ziels (csv,jsonlines,kafka,postgresql,gdrive,chroma,qdrant, unter anderem); das Erste, was die meisten Nutzer anfassen.pathway spawn --threads N: steuert die lokale Multithread-Parallelität.- Persistenz-Backend: Das Zustands-Backend (S3 oder lokale Datei) wird über einen Konfigurationsparameter im Code gewählt, laut Klarstellung des Teams im Hacker-News-Thread.
llm-app-Vorlagen: Für RAG geht man von einer Vorlage aus und ändert die Quelle oder den Indextyp (vektoriell → hybrid) mit „einer Ein-Zeilen-Änderung”, laut deren README.
Häufige Fallstricke und Lösungen
- Nicht unterstützte Systeme: Das README warnt, dass Pathway nur für macOS und Linux verfügbar ist; für andere Umgebungen wird eine virtuelle Maschine empfohlen.
- Konsistenz: Die freie Version bietet „mindestens einmal”; für „genau einmal” ist die Enterprise-Version erforderlich. Das ist eine Lizenzgrenze, kein Bug.
- RAM-Anforderung in Produktion: Das Team stellte im Hacker-News-Thread klar, dass der dominante Faktor beim RAM-Verbrauch die Größe der eingespeisten Daten ist, besonders bei einem In-Memory-Index. Die Frage eines Nutzers zum „Community 8 GB / 4 Kerne”-Plan blieb in den gesammelten Quellen ohne eine konkrete Mindestanforderungszahl beantwortet.
- Große Forks: Das CONTRIBUTING-Dokument erklärt, dass ein umfangreicher PR ohne vorherige Genehmigung eines Maintainers ohne detaillierte Review geschlossen werden kann; für große Beiträge empfiehlt sich, zuerst ein Issue zu eröffnen.
Integrationen und Migration
- LangChain / LlamaIndex: Pathway integriert sich als Vektorspeicher / Retriever (in beiden Ökosystemen dokumentiert);
llm-app-Vorlagen fungieren als Retrieval-Backend für LangChain- oder LlamaIndex-Anwendungen. - Vektordatenbanken:
pw.io.chroma.writeundpw.io.qdrant.write(v0.32.1) schreiben die Tabelle nach Chroma/Qdrant und halten die Collection synchron. - Streaming: Kafka-Connectors (und damit auch Streaming-Ökosysteme wie Redpanda) sowie ein Airbyte-Connector für über 300 Quellen.
- Deployment: Docker (Image
pathwaycom/pathway:latest), Kubernetes und Clouds; es gibt eine Render-Deployment-Anleitung in der Dokumentation. - Migration von separater Vektordatenbank/Cache/API: Das README von
llm-apppositioniert Pathway als Ersatz für einen Stack separater Module (Vektor-DB + Redis + FastAPI) durch ein einziges Framework mit integriertem Vektorindex (usearch) und Volltextindex (Tantivy).
Aktuelle Kennzahlen
Messung: 5. September 2026, GitHub-API.
| Kennzahl | Wert |
|---|---|
| Sterne | 62.344 |
| Forks | 1.687 |
| Abonnenten | 120 |
| Offene Issues laut API | 35 |
| Commits | ≈2.233 |
| Hauptsprache | Python |
| Lizenz | BSL 1.1 („Other” in der API) |
| Standard-Branch | main |
| Erstellt | 27. November 2022 |
| Neuestes Release | v0.32.1, 1. August 2026 |
Top-Contributor laut API, nach Anzahl der Beiträge, waren Pathway-Dev (837), zxqfd555 (436), pw-ppodhajski (136), szymondudycz (123), olruas (122), KamilPiechowiak (113) und berkecanrizai (92). Der Wert von ≈2.233 Commits stammt aus der letzten Seite des Paginierungs-Links der Commits-API. watchers_count der allgemeinen Antwort spiegelt die Sternezahl wider, und open_issues_count (35) kann offene Pull Requests einschließen. Auf PyPI ist die aktuelle Version 0.32.1 mit 80 veröffentlichten Releases und requires_python >=3.10; pypistats meldete 172 Downloads am letzten Tag, 927 in der Woche und 7.273 im Monat. Auf Docker Hub verzeichnete das Image pathwaycom/pathway 14.000 kumulative Downloads und 2 Sterne (letzte Aktualisierung 31. Juli 2026).
Community-Resonanz
Die gesammelten Belege zeigen konkretes Interesse, besonders an Live-RAG, sowie praktische Fragen an das Team:
- Im Hacker-News-Thread 40669434 —„Show HN: Pathway – Build Mission Critical ETL and RAG in Python (NATO, F1 Used)”, veröffentlicht am 13. Juni 2024 von
janchorowski(CTO)— wurden 73 Punkte erreicht. Unter den verifizierten Kommentaren: pipboyguy schrieb „I’ve built DE and AI solutions based on Pathway for multiple clients. It’s robust and fast” (Beleg für professionelle Nutzung, keine unabhängige Bewertung); snowpid kommentierte ironisch die Unternehmensnutzung („Good old ‘Enterprise’ NATO!”); Arimbr fragte, ob Pathway, da alles im Speicher gehalten wird, irgendwo Zustand persistiert; threecheese fragte nach dem „Community 8 GB RAM / 4 Kerne”-Plan und ob etwas dauerhaft gehostet wird; sriyansh7 fragte, welche Anwendungsfälle es für RAG über Streaming-Daten sieht. - Teammitglieder antworteten:
dxtrous(Adrian, von Pathway) stellte klar, dass alles RAM-basiert ist und Persistenz/Caching auf konfigurierbaren Datei-Backends (S3 oder lokal) beruht, dass der RAM-Verbrauch hauptsächlich von der Datengröße abhängt (besonders bei einem In-Memory-Index) und dass die Domäne weiterhin größtenteils unstrukturierte Daten sind (Messaging, Live-Indexierung von Kommunikation, soziale Medien, Nachrichten).janchorowskibedankte sich und bat um Details zu Anwendungsfällen. - Weitere Show-HN-Beiträge des Projekts mit geringerer Reichweite: 39852514 „Adaptive RAG – How we cut LLM costs without sacrificing accuracy” (8 Punkte, 28.03.2024, von
dxtrous); 38304483 „Alerting in realtime RAG: spot changes to LLM answers, using few tokens” (8 Punkte, 5 Kommentare, 17.11.2023); 42318221 „Build Live AI and RAG Pipelines in Minutes with YAML Templates” (8 Punkte, 04.12.2024, vonjanchorowski); 40987194 „Private RAG with Mistral, Ollama and Pathway” (5 Punkte, vonberkecanrizai).
Reddit war während dieser Recherche nicht zugänglich (die öffentliche API antwortete mit 403), daher werden keine Reddit-Threads berichtet, und es wurde weder eine Product-Hunt-Seite noch ein verifiziertes YouTube-Video des Produkts gefunden. Daher wird kein breiterer Diskurs oder Konsens abgeleitet, als die Quellen zeigen. Die Presseberichterstattung über die Organisation (WSJ, Forbes, MIT Technology Review, Live Science, Semafor, TechCrunch) konzentriert sich größtenteils auf die BDH-Architektur und die Bewertung, nicht auf das ETL-Framework selbst.
Pathway im Vergleich zu anderen Ansätzen
| Projekt | Verifizierte Beziehung | Verifizierter Unterschied |
|---|---|---|
| Apache Flink / Apache Spark / Kafka Streams | Stream- und Datenverarbeitungs-Engines, mit denen sich Pathway in seinem README explizit vergleicht (mit dem Anspruch, sie zu übertreffen) und in pathwaycom/pathway-benchmarks. | Flink/Spark/Kafka Streams sind ausgereifte, offene Streaming-Engines; Pathway bietet eine High-Level-Python-API, Batch-/Stream-Vereinheitlichung mit einer Codebasis und eine integrierte LLM-/RAG-Erweiterung. Die Performance-Zahlen stammen vom Projekt selbst, keine unabhängige Bewertung. |
| Vektordatenbanken + Redis + FastAPI (z. B. Pinecone/Weaviate/Qdrant) | Ein klassischer Stack zum Bau von RAG mit Vektorindex, Cache und separater API. | Das README von llm-app positioniert Pathway als Ersatz dieser Module durch ein einziges Framework mit integriertem Vektorindex (usearch) und Volltextindex (Tantivy), wobei der Index live synchron gehalten wird. |
| LangChain / LlamaIndex | Frameworks zum Bau von LLM-/RAG-Anwendungen. | Keine Konkurrenten: Pathway integriert sich mit beiden als Vektorspeicher/Retriever. Der Unterschied liegt auf der Ebene: Pathway ist die zugrunde liegende Live-Daten-Engine. |
| Airbyte | Werkzeug zur Datenkonnektivität. | Pathway enthält einen Airbyte-Connector für über 300 Quellen; es konkurriert nicht, sondern nutzt es als Quelle. |
Der nützlichste Vergleich ist nicht nach Popularität: Pathway sticht hervor, wenn man eine einzige Python-Codebasis für Batch und Stream mit Live-RAG möchte; ausgereifte Engines (Flink/Spark) können vorzuziehen sein, wenn die Anforderung ein offener, weit verbreiteter Streaming-Stack ist, und KI-Frameworks (LangChain/LlamaIndex) lösen die Agenten-Orchestrierungsebene, nicht die Daten-Engine.
Wie man beiträgt
Der in CONTRIBUTING.md dokumentierte Prozess ist explizit und hat eine ungewöhnliche Nuance:
- Der Hauptkanal ist Discord (ein Forumskanal für Fragen, Design-Diskussionen oder RFCs) und der GitHub-Issue-Tracker für Bugs, Abstürze und Performance-Probleme.
- Das Eröffnen eines Issues wird als „der wertvollste Beitrag” erklärt: Das Team bittet darum, zu beschreiben, wie Pathway genutzt wird, was fehlt, welche Reibungspunkte, Bugs und wiederkehrenden Nutzungsmuster es gibt.
- Für Code wird ein PR akzeptiert, wenn er (a) klein und in sich geschlossen ist (ein Fix, eine Korrektur, eine Dokumentationsverbesserung) oder (b) eine explizite Genehmigung eines Maintainers hat (angefragt über Issue oder Discord, mit vorherigem Design-Ratschlag).
- Für große Änderungen ohne vorherige Genehmigung behält sich das Team vor, „diese ohne detaillierte Review zu schließen”, mit der Begründung, dass die Rekonstruktion des Kontexts einer großen externen Änderung mehr kostet als das Problem von Grund auf zu lösen.
- Für Bibliotheken oder Connectors, die integriert werden sollen, schlägt das README vor, diese zunächst als separates Repository unter MIT/Apache 2.0 zu veröffentlichen.
Anwendungsfälle und wem dieses Repository helfen kann
- Datenteams, die Pipelines über Kafka betreiben und Echtzeit-Analytik mit einer einzigen Codebasis wollen, können das Framework nutzen, damit derselbe Code lokale Entwicklung, CI/CD-Tests und Streaming-Produktion bedient und so vermeidet, eine separate Batch- und Streaming-Implementierung zu pflegen.
- KI-Teams, die RAG über sich ändernde Dokumente bauen (Verträge, Finanzberichte, Kommunikation), können von den Vorlagen von
pathwaycom/llm-appausgehen (z. B. Private RAG mit Ollama und Mistral oder Multimodal RAG mit GPT-4o), damit der Vektorindex live bleibt und Antworten die aktuellen Quellen widerspiegeln, ohne Vektorspeicher, Cache und API separat zu verwalten. - Personen, die RAG mit LangChain oder LlamaIndex integrieren, können Pathway als zugrunde liegenden Vektorspeicher/Retriever nutzen, dokumentiert in beiden Ökosystemen, und als Retrieval-Backend für ihre Anwendungen.
- Teams, die RAG über unstrukturierte Daten im großen Maßstab benötigen (Milliarden von Dokumentseiten, laut README von
llm-app), können die auf Genauigkeit oder Einfachheit optimierten Vorlagen nutzen und auf Docker, Kubernetes oder Clouds (GCP, AWS, Azure, Render) bereitstellen. - Forscher oder Evaluatoren von Reasoning-Modellen können
pathwaycom/arc-task-gennutzen, um ARC-AGI-1-artige Aufgaben zu generieren, die nicht im öffentlichen Datensatz enthalten sind, nützlich zur Evaluierung von Modellen wie BDH-CQ.
Ressourcen
- Repository: https://github.com/pathwaycom/pathway
- Dokumentation und Benutzerhandbuch: https://pathway.com/developers/user-guide/introduction/welcome
- RAG-/KI-Anwendungsvorlagen: https://github.com/pathwaycom/llm-app und https://pathway.com/developers/templates
- LangChain-/LlamaIndex-Integrationen: https://docs.langchain.com/oss/python/integrations/vectorstores/pathway , https://developers.llamaindex.ai/python/examples/retrievers/pathway_retriever/
- Benchmarks: https://github.com/pathwaycom/pathway-benchmarks
- Community / Discord: https://discord.gg/pathway
- Paketregister (PyPI): https://pypi.org/project/pathway/
- Docker Hub: https://hub.docker.com/r/pathwaycom/pathway
- Offizieller Blog und Changelog: https://pathway.com/blog/
- Hacker-News-Threads: https://news.ycombinator.com/item?id=40669434 , https://news.ycombinator.com/item?id=39852514 , https://news.ycombinator.com/item?id=38304483 , https://news.ycombinator.com/item?id=42318221
- Kuratierte Listen:
vinta/awesome-python(Eintrag „pathway”)
Methodischer Hinweis: Dieser Artikel stützt sich auf das README, CONTRIBUTING.md, die Release-Notes, die GitHub-API, PyPI, Docker Hub, die offizielle Website (pathway.com) und Hacker-News-Threads, konsultiert am 5. September 2026. Zahlen ändern sich mit der Zeit. Daten zur Organisation und ihrem BDH-Schwenk stammen von der eigenen Website und der zitierten Presse; die Performance-Behauptungen des Frameworks stammen vom Projekt selbst und stellen keine unabhängige Bewertung dar. Reddit war nicht zugänglich (403), und es wurde weder eine Product-Hunt-Seite noch ein verifiziertes YouTube-Video des Produkts gefunden.
Kommentare