

llm-app: einsatzbereite RAG-Vorlagen für das Pathway-Framework
pathwaycom/llm-app · 58.898★ · 1.500 forks
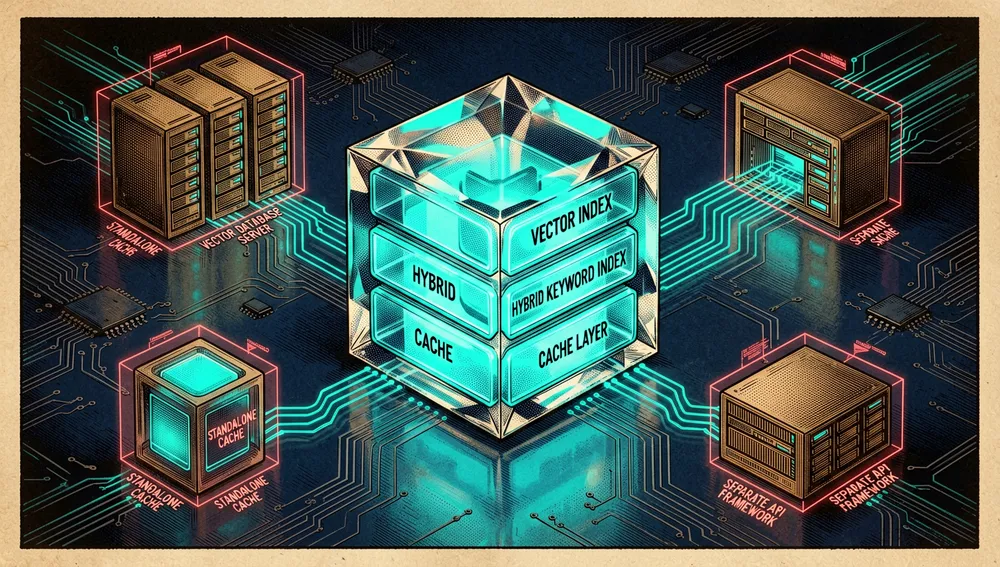
llm-app ist die Sammlung offizieller KI-Anwendungsvorlagen auf Basis des Pathway Live Data Framework (pathwaycom/pathway, dem Schwester-Repository mit der Bibliothek und der Rust-Engine): RAG, Dokumenten- und Videosuche sowie Echtzeit-Indizes, die dauerhaft mit den Datenquellen synchron bleiben. Jede Vorlage ist ein einsatzbereiter Docker-Container, der eine HTTP-API bereitstellt und den Vektorindex, den Hybridindex und den Cache direkt in der Bibliothek integriert — ohne separate Vektordatenbank, Cache oder API-Framework.
Ursprung
Das Repository wurde am 19. Juli 2023 von der Organisation pathwaycom (dem Unternehmen Pathway, pathway.com) erstellt, acht Monate nachdem das Basis-Framework pathwaycom/pathway existierte (erstellt am 27. November 2022). Acht Tage nach der Erstellung, am 27. Juli 2023, stellte Pathway es auf Hacker News vor: „Show HN: LLM App – build a realtime LLM app in 30 lines, with no vector database” (Thread 36894142), der 11 Punkte und 8 Kommentare erreichte.
Der Launch-Thread setzt die Erzählung bereits im Titel: eine Echtzeit-LLM-App in ~30 Zeilen ohne Vektordatenbank. Nutzer Arimbr fragte, was das Pathway-Paket genau sei, und janchorowski (Pathway) antwortete, es handle sich um ein Datenverarbeitungs-Framework, das Stream- und Batch-Verarbeitung großer Datensätze vereinheitlicht und Entwicklern erlaubt, sich auf die Logik zu konzentrieren, statt Datenänderungen manuell nachzuverfolgen.
Das Repository hat sich zu einem Katalog entwickelt: Die ursprüngliche Präsentation war ein einziges „30 Zeilen”-Beispiel; heute (2026) umfasst es zehn Vorlagen. Weitere Hacker-News-Auftritte folgen demselben Muster eines „Show HN” pro Vorlage: 38304483 (17.11.2023, Echtzeit-RAG-Alerts, 8 Pkt. / 5 Komm.), 40987194 (17.07.2024, privates RAG mit Mistral und Ollama, 5 Pkt. / 0 Komm.) und 42318221 (04.12.2024, YAML-Vorlagen, 8 Pkt. / 2 Komm.). Im Thread des Basis-Frameworks —40669434 „Show HN: Pathway – Build Mission Critical ETL and RAG in Python (NATO, F1 Used)” (73 Pkt., 19 Kommentare, 13.06.2024)— behauptet das Team selbst, das Produkt werde von Kunden genutzt, die die Überschrift als „NATO und F1” zusammenfasst; es ist der öffentlich sichtbarste Auftritt der Familie.
Philosophie und Prinzipien
Das README verdichtet die Philosophie auf mehrere verifizierbare Ideen:
- Stets aktuelles Wissen: Der Kernwert ist, dass Dokumente bei jeder Hinzufügung, Löschung oder Änderung an der Quelle in Echtzeit neu indexiert werden. Es gibt keinen separaten ETL-Schritt und kein „nächtliches Batch”; der Index spiegelt den aktuellen Zustand der Quelle.
- Keine Zusatzinfrastruktur: Das README drückt dies wörtlich aus, indem es den üblichen Stack durchstreicht: „
Vector Database (z. B. Pinecone/Weaviate/Qdrant) + Cache (z. B. Redis) + API Framework (z. B. Fast API)”. Vektorindex, Hybridindex und Cache sind in die Bibliothek integriert (standardmäßig usearch für den KNN-Index und Tantivy für die hybride Volltextsuche). - „Ein-Zeilen”-Vorlagen: Die READMEs behaupten, das Ändern eines Pipeline-Schritts sei „eine Ein-Zeilen-Änderung” und die Vorlagen unterschieden sich nur in ihrer
app.yaml. - Erklärte Skalierung: Das README erklärt, die Vorlagen skalierten „auf Millionen von Dokumentseiten”.
Das Prinzip der Inkrementalität zieht sich durch alles: Jede Änderung an den Quelldateien fließt sofort durch Parsing, Embedding, Index und LLM-Antworten.
Wie es funktioniert
Jede Vorlage läuft als Docker-Container, der eine HTTP-API bereitstellt (einige enthalten eine optionale Streamlit-UI). Alles beruht auf dem Pathway Live Data Framework, einer Python-Bibliothek mit integrierter Rust-Engine, die Quellen synchronisiert und Anfragen bedient.
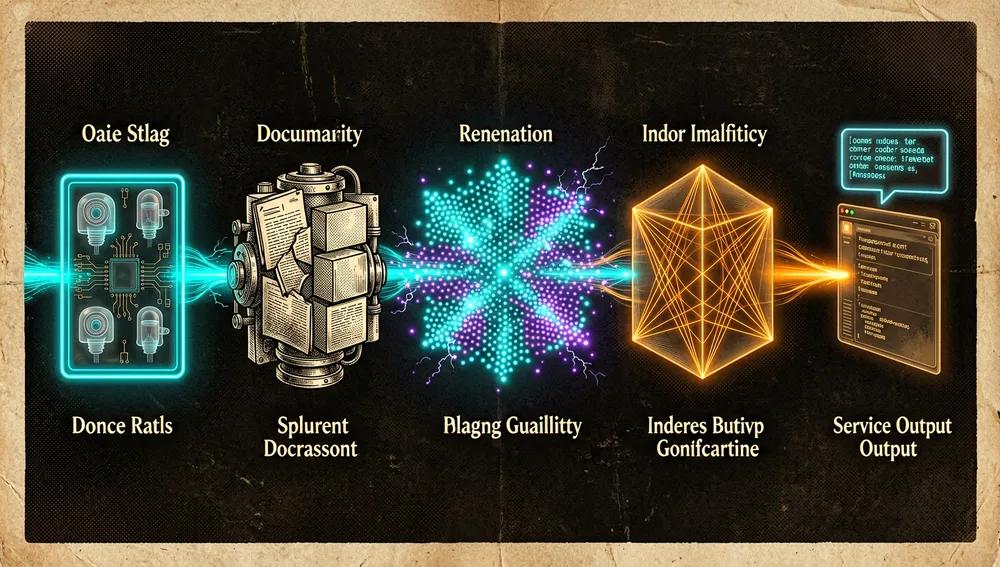
Die für die Standardvorlage (question_answering_rag) dokumentierte Pipeline hat fünf Stufen:
- Datenaufnahme: Quellen werden in
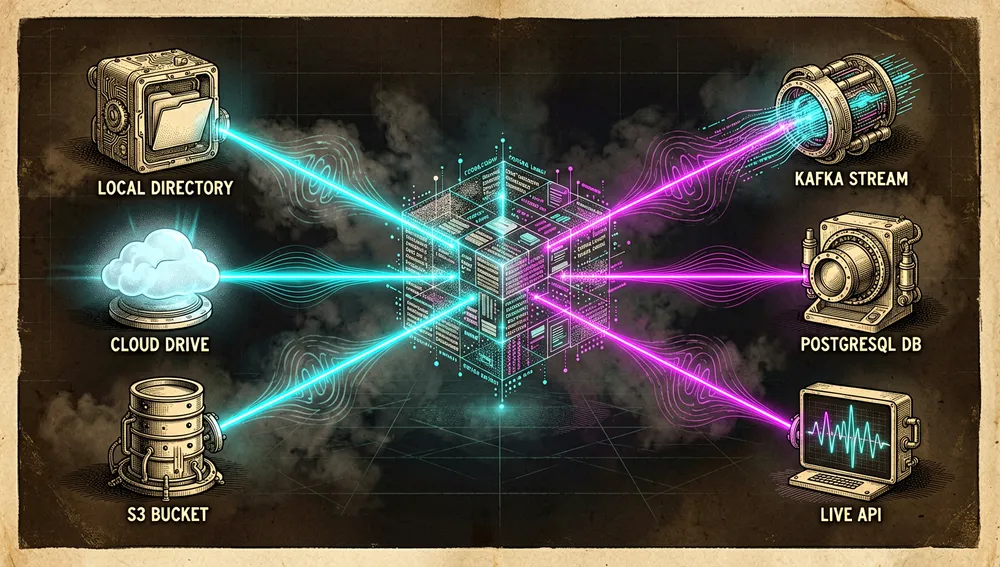
app.yamldefiniert (lokale Verzeichnisse, Google Drive, SharePoint, S3, Kafka, PostgreSQL, APIs). Der Code verkettet diese Quellen in konfigurierbaren Intervallen und indexiert in Echtzeit neu. - Parsing und Chunking: mit Docling (über
DoclingParser) undTokenCountSplitter. - Embedding: standardmäßig
OpenAIEmbedder; austauschbar gegen einen anderen Embedder. - Indexierung:
USearchKnnFactoryfür den Vektorindex; optional ein Hybridindex, derUSearchKNNmitTantivyBM25überHybridIndexkombiniert. - Bereitstellung:
SummaryQuestionAnswererbearbeitet Fragen und Zusammenfassungen,QASummaryRestServerstellt die Endpunkte bereit.
Standard-Endpunkte der Standardvorlage:
| Kategorie | Endpunkt | Verwendung |
|---|---|---|
| Dokumentindexierung | /v1/retrieve | Ähnlichkeitssuche |
/v1/statistics | Grundlegende Indexstatistiken | |
/v2/list_documents | Metadaten aller verarbeiteten Dateien | |
| LLM / RAG | /v2/answer | Dokumente befragen oder mit dem LLM sprechen |
/v2/summarize | Eine Liste von Texten zusammenfassen |
Die zehn Vorlagen des Repositorys (verifiziert in templates/):
| Vorlage | Beschreibung (laut README) |
|---|---|
question_answering_rag | Grundlegendes End-to-End-RAG: beantwortet Fragen zu PDF/DOCX aus einer Live-Quelle |
document_indexing | Live-Indexierung als Vektorspeicher / Retriever (Backend für LangChain oder LlamaIndex) |
multimodal_rag | Multimodales RAG mit GPT-4o; extrahiert Tabellen und Diagramme aus Finanzdokumenten |
unstructured_to_sql_on_the_fly | Wandelt unstrukturierte Finanzdaten in SQL um + lädt sie in PostgreSQL |
adaptive_rag | RAG mit Adaptive RAG, um die Token-Kosten bis zu 4× zu senken bei gleichbleibender Genauigkeit |
private_rag | Vollständig privates/lokales RAG mit Mistral und Ollama |
slides_ai_search | Multimodale Indexierung von Folien (PowerPoint und PDF) mit Live-Index |
video_rag_twelvelabs | Video-RAG mit TwelveLabs |
document_store_mcp_server | Stellt die Live-Indexierung als MCP-Server bereit (drei Werkzeuge, JMESPath-Filterung) |
drive_alert | RAG über Google Drive mit Echtzeit-Alerts (Slack), wenn sich Antworten ändern |
Das Ökosystem
Wichtigstes Schwester-Repository (die Engine). pathwaycom/llm-app ist der Vorlagenkatalog für pathwaycom/pathway, das Basis-Framework mit der Bibliothek und der Rust-Engine: „Python ETL framework for stream processing, real-time analytics, LLM pipelines, and RAG”; 62.344 Sterne, 1.686 Forks, erstellt am 27. November 2022, benutzerdefinierte Lizenz (von der API als NOASSERTION markiert), letztes Release v0.32.1 (1. August 2026), als pathway-Paket auf PyPI verteilt.
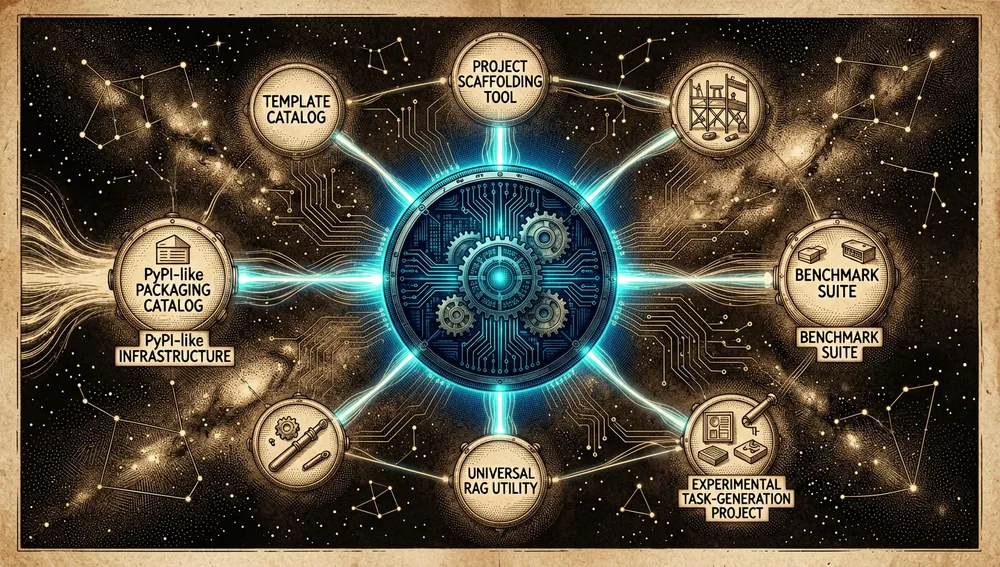
Weitere Repositorys der Organisation pathwaycom (Sternezahlen laut GitHub-API, absteigend): pathwaycom/arc-task-gen — 10.565 Sterne — „Generates original ARC-AGI-1-style tasks”; pathwaycom/bdh — 3.544 Sterne — „BDH (Dragon Hatchling) – Architecture and Code”; pathwaycom/pathway-benchmarks — 302 Sterne; pathwaycom/cookiecutter-pathway — 277 Sterne; pathwaycom/serviette — 4 Sterne — „Universal RAG tool”.
Externe Bibliotheken, die die Architektur einbindet: usearch (unum-cloud/usearch) für den standardmäßigen KNN-Index, Tantivy (quickwit-oss/tantivy) für den Hybridindex, und Docling (docling.ai) für das Dokumenten-Parsing. Dokumentierte Integrationen: LangChain und LlamaIndex (die Vorlage document_indexing kann als Retrieval-Backend für beide dienen), TwelveLabs (Video-RAG), das Model Context Protocol (MCP), Slack (Alerts in drive_alert) und die LLM-Anbieter OpenAI, Mistral und Ollama.
Offizieller und halboffizieller Status
llm-app ist ein Pathway-Produkt aus erster Hand: Das README endet mit einem Abschnitt „Supported and maintained by”, der Pathway explizit kreditiert, und das Repository ist der offizielle Vorlagenkanal (pathway.com/developers/templates/). Es gibt keine „Marktplatz-Akzeptanz” durch Dritte; sein Status ist der eines offiziellen Referenz-Repositorys des Unternehmens für den Bau von RAG-Apps auf dem eigenen Framework.
In der Praxis: Es ist die Sammlung von Referenzimplementierungen, die Pathway pflegt und unterstützt (Bugs werden im Tracker des Basis-Frameworks gemeldet, nicht bei llm-app); das zugrunde liegende Framework wird als offizielles pathway-Paket auf PyPI vertrieben; der SharePoint-Connector ist hinter einem Scale- oder Enterprise-Lizenzschlüssel gesperrt (Pathway bietet einen kostenlosen Scale-Schlüssel an); und das Basis-Framework erscheint auf Trendshift als Trend-Repository.
Schnellstart-Anleitung
Installation und erster Start
# 1. Repository klonen
git clone https://github.com/pathwaycom/llm-app.git

# 2. In die Vorlage wechseln
cd templates/question_answering_rag

# 3. Abhängigkeiten installieren (nur für lokale Ausführung, nicht Windows)
pip install -r requirements.txt

# 4. OpenAI-Schlüssel in .env setzen  ->  OPENAI_API_KEY=sk-...

# 5. Ausführen
python app.py
Oder mit Docker (einziger dokumentierter Weg für Windows):
docker compose build
docker compose up
Beim ersten Start sieht man in den Logs das Parsing und Embedding der Beispieldokumente. Sobald 0 entries (x minibatch(es)) have been... erscheint und keine Updates mehr eintreffen, ist die App bereit:
curl -X POST http://localhost:8000/v1/statistics \
  -H 'accept: */*' -H 'Content-Type: application/json'
Gängige Workflows
- Indexierte Dokumente auflisten:
POST /v2/list_documents→ Metadaten aller verarbeiteten Dateien. - Ähnlichkeitssuche:
POST /v1/retrieve -d '{"query": "deine Frage", "k": 6}'→ ähnlichste Chunks (unterstütztmetadata_filtervia JMESPath undfilepath_globpattern). - Mit RAG fragen:
POST /v2/answerundPOST /v2/summarize. - Modell wechseln: in
app.yamldas Feldmodelim$llm-Block bearbeiten (Standardgpt-4.1-mini; Beispiele zeigengpt-5,gpt-4.1,gpt-4ooderLiteLLMChat, das auf lokales Ollama zeigt).
Wesentliche Konfiguration
app.yaml: definiert Datenquellen, LLM, Embedder und Index; die einzige Datei, die sich zwischen Vorlagen unterscheidet..env:OPENAI_API_KEYerforderlich (und fürdrive_alertslack_alert_channel_idundslack_alert_token).$sourcesinapp.yaml: lokal, Google Drive (Standard-refresh_interval30 s) oder SharePoint (erfordert einen Lizenzschlüssel).host/port: Standard0.0.0.0/8000.- Cache / Persistenz:
persistence_mode,persistence_backend(z. B.Backend.filesystem).
Häufige Fallstricke und Lösungen
- Windows unterstützt keine lokale Ausführung: Das README empfiehlt Docker.
- Abfrage vor Abschluss der initialen Indexierung: auf die Meldung
0 entries (x minibatch(es)) have been...warten. - SharePoint erfordert eine Lizenz: ohne Scale-/Enterprise-Schlüssel funktioniert dieser Connector nicht.
- Google Drive erfordert ein Service-Konto: benötigt
object_idund gültige Anmeldedaten. - LLM-basierte Alert-Deduplizierung: Im Thread 38304483 schlug Nutzer
pstormvor, die Embedding-Ähnlichkeit zu vergleichen, statt LLM-Aufrufe für die Erkennung von Änderungen zu verwenden;janchorowskiantwortete, das Kriterium sei leicht austauschbar und der LLM-Weg sei schneller für den Einstieg, aber mit der Zeit könne ein embeddingbasiertes Kriterium trainiert werden.
Integrationen und Migration
- LlamaIndex-/LangChain-Retrieval-Backend: Die Vorlage
document_indexingdient als Vektorspeicher / Retriever für jedes Frontend oder jede LlamaIndex-/LangChain-App. - MCP:
document_store_mcp_serverstellt die Live-Indexierung mit drei Werkzeugen bereit (retrieve_query,statistics_query,inputs_query). - Slack:
drive_alertsendet Benachrichtigungen, wenn sich eine Antwort ändert. - Cloud-Deployment: Deployment-Anleitungen für GCP, AWS Fargate, Azure (ACI) und Render.
- Austausch von Komponenten: Die Migration von einem Vektorindex zu einem Hybridindex oder von OpenAI zu lokalem Ollama/Mistral ist eine YAML-Änderung, ohne
app.pyanzufassen.
Aktuelle Kennzahlen
Messung: 4. September 2026, GitHub-API.
| Kennzahl | Wert |
|---|---|
| Sterne | 58.937 |
| Forks | 1.478 |
| Abonnenten | 94 |
| Commits | 253 |
| Offene Issues laut API | 8 |
| Hauptsprache | Jupyter Notebook (409.401 Bytes); sekundär: Python (68.370), Dockerfile (3.888) |
| Lizenz | MIT |
| Erstellt | 19. Juli 2023 |
| Letzter Push | 5. Juli 2026 |
| Neuestes Release | Keines: das Repository nutzt keine Releases oder versionierten Tags |
Top-Contributor waren berkecanrizai (48), szymondudycz (45), pw-ppodhajski (33), dxtrous (19), olruas (14), Boburmirzo (9), janchorowski (9) und embe-pw (9). Der Wert von 253 Commits stammt aus dem Paginierungs-Header des Commits-Endpunkts. open_issues_count kann offene Pull Requests einschließen. watchers_count spiegelt die Sternezahl wider, daher wird subscribers_count separat als echte Abonnenten angegeben.
Community-Resonanz
Die gesammelten Belege stammen aus mehreren Hacker-News-Threads, alle mit kleinem bis moderatem Publikum, plus einem Thread des Basis-Frameworks, der eine bemerkenswerte Zahl erreichte:
Anerkennung:
- Im Thread des Basis-Frameworks 40669434 (73 Pkt., 19 Kommentare) schrieb
articsputnik, es sei „beeindruckend, ein Python-Tool für ETL- und RAG-Aufgaben mit derart soliden Features zu sehen” und der Fokus auf Sicherheit und Performance, „besonders bei self-hosted RAG-Pipelines, ist fantastisch”. pipboyguylieferte im selben Thread einen realen Anwendungsfall: „I’ve built DE and AI solutions based on Pathway for multiple clients. It’s robust and fast.”devnull777: „Die Beispiele auf eurer Seite sehen einfach nachvollziehbar aus. Übrigens, was für eine schöne und klare Website!”- In 36894142 (11 Pkt., 8 Kommentare) zeigte sich
Arimbranfangs interessiert, undanupsurendranschloss den Austausch mit der Bemerkung, er verstehe die Unterscheidung Index/Datenbank nach der Antwort des Teams „viel besser”.
Konkrete Kritik und Skepsis:
- In 40669434 reagierte
snowpidskeptisch auf das „NATO”-Label: „Good old ‘Enterprise’ NATO! Always good for a surprise”, undsuziemanulantwortete scherzhaft, „manche sagen, es sei nicht Fortune 100, sondern Fortune 1”. Das Team dementierte die Behauptung der Überschrift nicht. threecheesefragte im selben Thread nach dem RAM des „Community”-Plans (8 GB) und merkte an, die Rust-Engine werde „shipped as compiled executable, mit einer Lizenzprüfung” ausgeliefert;dxtrous(Pathway) antwortete, der Hauptfaktor des RAM-Verbrauchs sei die Größe der eingespeisten Daten.- In 42318221 (8 Pkt., 2 Kommentare) bat
Arimbrdarum, „alle unterstützten Felder und Werte an einem Ort zu sehen”;janchorowskiantwortete, man werde das tun. - In 38304483 (8 Pkt., 5 Kommentare) stellte
pstormden Deduplizierungsansatz infrage, undbobur_umurzokoverweiterte den Anwendungsbereich mit Vorschlägen für Betrugserkennung, Kundensupport, medizinische Diagnostik und vorausschauende Wartung.
Die Bilanz: technische Begeisterung und reale Anwendungsfälle, mit meist bescheidenem Publikum bei den Vorlagen, aber ein Thread des Basis-Frameworks mit 73 Punkten und 19 Kommentaren, der begründete Skepsis gegenüber der Unternehmensschlagzeile und dem Hosting-/Lizenzmodell einbringt.
Vergleich mit ähnlichen Projekten
| Projekt | Verifizierbare Überschneidung | Verifizierbarer Unterschied |
|---|---|---|
| Klassischer RAG-Stack: Pinecone / Weaviate / Qdrant / pgvector + Redis + FastAPI | Alle lösen „RAG über Unternehmensdokumente” mit Vektorspeicher + Cache + API. | Das README erklärt, dass diese Komponenten nicht separat zusammengebaut werden müssen: Vektorindex, Hybridindex und Cache sind in die Bibliothek integriert. |
| LlamaIndex / LangChain | Beide sind Dokumenten-Retrieval-Frameworks für LLMs. | llm-app behandelt sie als Clients seines Index und ergänzt die Echtzeitsynchronisation der Quellen. |
pathwaycom/pathway (Schwester-Repository) | Gleiches zugrunde liegendes Framework; llm-app enthält nur Vorlagen darauf. | pathway ist die Bibliothek/Engine (Python + Rust, PyPI); llm-app ist der „einsatzbereite” App-Katalog. |
| TwelveLabs (Video-RAG) | Bietet Video-RAG. | llm-app konsumiert TwelveLabs innerhalb seiner Vorlage video_rag_twelvelabs; es konkurriert nicht, sondern integriert. |
Der nützlichste Vergleich: llm-app sticht hervor, wenn die Anforderung RAG ist, das in Echtzeit mit Unternehmensquellen synchron bleibt, ohne separate Vektor-/Cache-/API-Infrastruktur aufzubauen.
Wie man beiträgt
- Akzeptiert Beiträge zu Dokumentation, Funktionen, Fixes, Code-Bereinigung, Tests und Reviews.
- Der empfohlene Weg für größere Beiträge ist, dies vorab im Discord-Server von Pathway (Kanal #get-help) zu melden.
- Bugs und Feedback werden im Tracker des Basis-Frameworks gemeldet (
pathwaycom/pathway/issues), nicht beillm-app. - Da jede Vorlage eine einzige
app.yamlhat, besteht der praktische Weg, eine Variation beizutragen, darin, von einer bestehenden Vorlage auszugehen und deren YAML anzupassen.
Es wurde weder eine CONTRIBUTING.md noch eine spezifische PR-Vorlage im Repository gefunden.
Anwendungsfälle und wem dieses Repository helfen kann
- Teams, die RAG über lebendige Unternehmensdokumente aufbauen (SharePoint, Google Drive, S3, Kafka, PostgreSQL, APIs):
question_answering_ragplus der passende Connector liefert einen sich selbst aktualisierenden Index.document_indexingnutzt diesen Index als Backend für eine bestehende LlamaIndex-/LangChain-App. - Finanzabteilungen / Analysten:
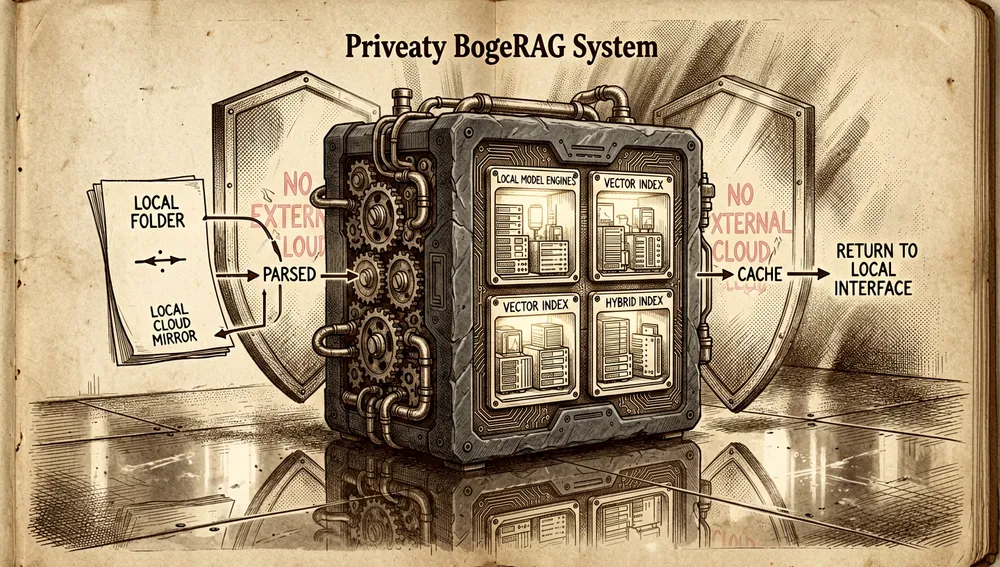
multimodal_ragextrahiert Tabellen und Diagramme aus Finanzdokumenten;unstructured_to_sql_on_the_flystrukturiert PDF-Berichte in PostgreSQL. - Teams mit Datenschutz-/Datenresidenz-Anforderungen:
private_rag(Mistral + Ollama) ermöglicht eine vollständig lokale Pipeline. - Wer Token-Kosten senken möchte:
adaptive_ragbeansprucht eine Reduktion um bis zu 4× bei gleichbleibender Genauigkeit. - LLM-Agenten-/MCP-Integratoren:
document_store_mcp_serverstellt die Live-Indexierung als MCP-Server bereit. - Teams, die Änderungen an der Wissensbasis überwachen:
drive_alertsendet Slack-Alerts nach einer Dokumentänderung. - Content-Teams / Suche über Folien und Video:
slides_ai_searchundvideo_rag_twelvelabs.
Ressourcen
- Repository: https://github.com/pathwaycom/llm-app
- Basis-Framework (Engine): https://github.com/pathwaycom/pathway
- Dokumentation / offizielle Website: https://pathway.com/developers/templates/
- YAML-Konfigurationsanleitung: https://pathway.com/developers/templates/configure-yaml
- Vorlagen (Code): https://github.com/pathwaycom/llm-app/tree/main/templates
- Paketregister: PyPI
pathway(neueste 0.32.1): https://pypi.org/project/pathway/ - Trendshift: https://trendshift.io/repositories/4400
- Community / Discord: https://discord.gg/pathway
- Relevante Hacker-News-Threads: https://news.ycombinator.com/item?id=40669434 , https://news.ycombinator.com/item?id=36894142 , https://news.ycombinator.com/item?id=38304483 , https://news.ycombinator.com/item?id=40987194 , https://news.ycombinator.com/item?id=42318221
Methodischer Hinweis: Dieser Artikel stützt sich auf das README von pathwaycom/llm-app, die Vorlagen-READMEs, die GitHub-API, Hacker-News-Threads und PyPI, konsultiert am 4. September 2026. Stern- und Versionszahlen ändern sich mit der Zeit.
Kommentare