

llm-app: plantillas RAG listas para desplegar sobre Pathway
pathwaycom/llm-app · 58.898★ · 1.500 forks
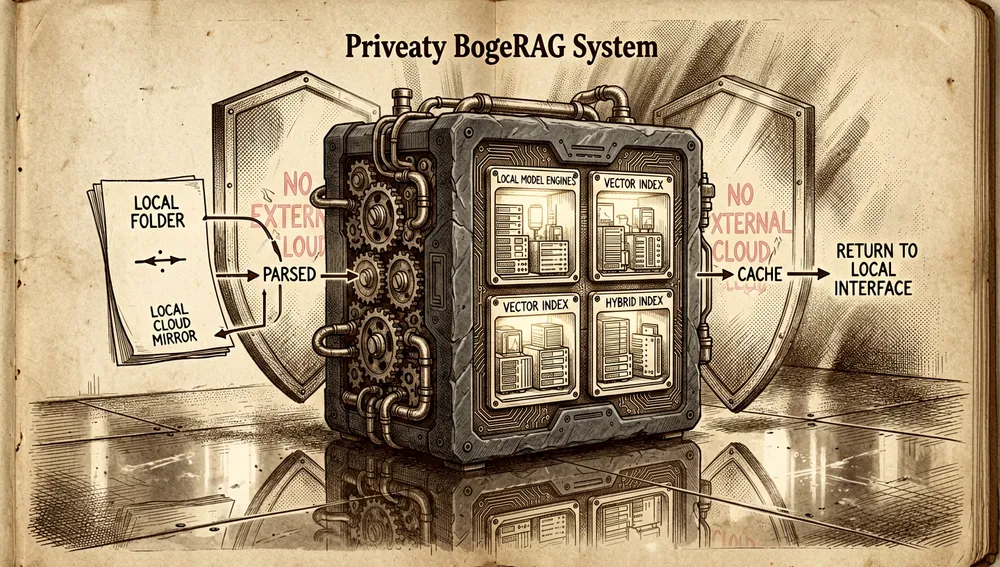
llm-app es la colección de plantillas oficiales de aplicaciones de IA sobre el Pathway Live Data Framework (pathwaycom/pathway, el motor hermano que contiene la librería y el motor en Rust): RAG, búsqueda de documentos y video, e índices en tiempo real que se mantienen siempre sincronizados con las fuentes de datos. Cada plantilla es un contenedor Docker listo para desplegar que expone una API HTTP e incorpora el índice de vectores, el índice híbrido y la caché dentro de la propia librería, sin montar una base de datos vectorial, un caché ni un framework de API por separado.
Origen
El repositorio fue creado el 19 de julio de 2023 por la organización pathwaycom (la empresa Pathway, pathway.com), ocho meses después de que existiera el marco base pathwaycom/pathway (creado el 27 de noviembre de 2022). Ocho días después de su creación, el 27 de julio de 2023, Pathway presentó la primera versión en Hacker News: «Show HN: LLM App – build a realtime LLM app in 30 lines, with no vector database» (hilo 36894142), con 11 puntos y 8 comentarios.
El hilo inaugural fija la narrativa desde el título: una aplicación LLM en tiempo real en ~30 líneas sin base de datos vectorial. En él, el usuario Arimbr preguntó qué era exactamente el paquete Pathway, y janchorowski (Pathway) respondió que es un marco de procesamiento de datos que unifica el procesamiento stream y batch de grandes conjuntos, dejando al desarrollador centrarse en la lógica sin rastrear manualmente los cambios de datos.
El repositorio ha evolucionado como catálogo: la presentación original era un solo ejemplo «30 líneas»; hoy (2026) agrupa diez plantillas. Las siguientes apariciones en Hacker News siguen el mismo patrón de «Show HN» por plantilla: 38304483 (2023-11-17, alertas en RAG en tiempo real, 8 pts / 5 com), 40987194 (2024-07-17, RAG privado con Mistral y Ollama, 5 pts / 0 com) y 42318221 (2024-12-04, plantillas YAML, 8 pts / 2 com). En el hilo del marco base —40669434 «Show HN: Pathway – Build Mission Critical ETL and RAG in Python (NATO, F1 Used)» (73 pts, 19 comentarios, 2024-06-13)— el propio equipo defiende que el producto está en uso en clientes que el titular resume como «NATO y F1»; es la aparición pública más visible de la familia.
Filosofía y principios
El README condensa la filosofía en varias ideas verificables:
- Conocimiento siempre al día: el valor central es que los documentos se re-indexan en tiempo real ante cualquier adición, eliminación o cambio en la fuente. No hay un paso ETL por separado ni un «batch nocturno»; el índice refleja el estado actual de la fuente.
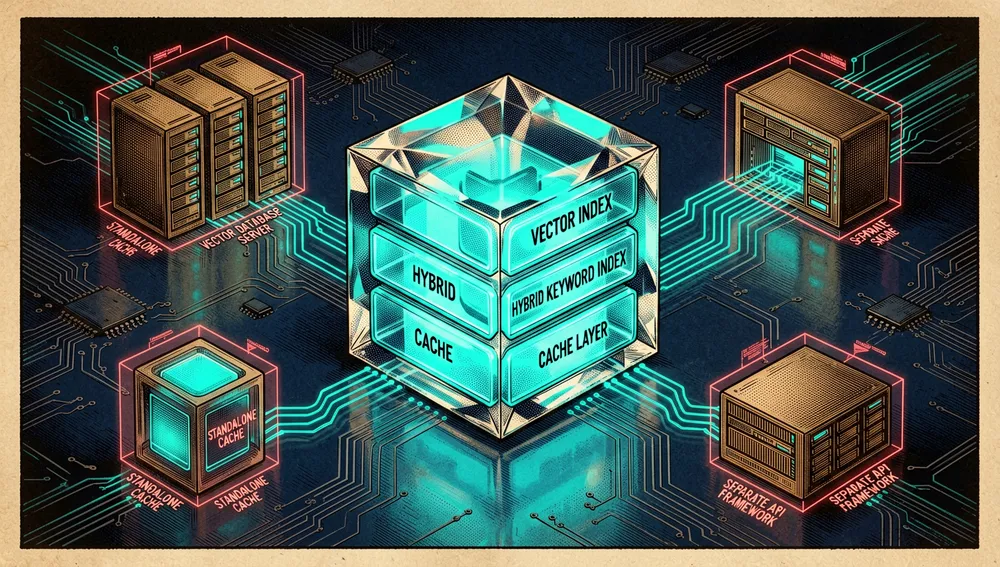
- Sin infraestructura auxiliar: el README lo expresa textualmente tachando el stack habitual: «
Vector Database (p. ej. Pinecone/Weaviate/Qdrant) + Cache (p. ej. Redis) + API Framework (p. ej. Fast API)». El índice de vectores, el índice híbrido y la caché están integrados en la librería (por defecto usearch para el índice KNN y Tantivy para la búsqueda de texto completo híbrida). - Plantillas «una línea»: los README afirman que cambiar un paso del pipeline es «un cambio de una línea», y que las plantillas solo difieren en su archivo
app.yaml. - Escala declarada: el README declara que las plantillas escalan «hasta millones de páginas de documentos».
El principio de incrementalidad es transversal: cualquier cambio en los archivos de origen fluye de inmediato a través del parseo, la incrustación, el índice y las respuestas del LLM.
Cómo funciona
Cada plantilla funciona como un contenedor Docker que expone una API HTTP (algunas incluyen una UI de Streamlit opcional). Todo depende del Pathway Live Data Framework, una librería de Python con un motor en Rust integrado que sincroniza fuentes y sirve peticiones.
El pipeline documentado en la plantilla por defecto (question_answering_rag) tiene cinco etapas:
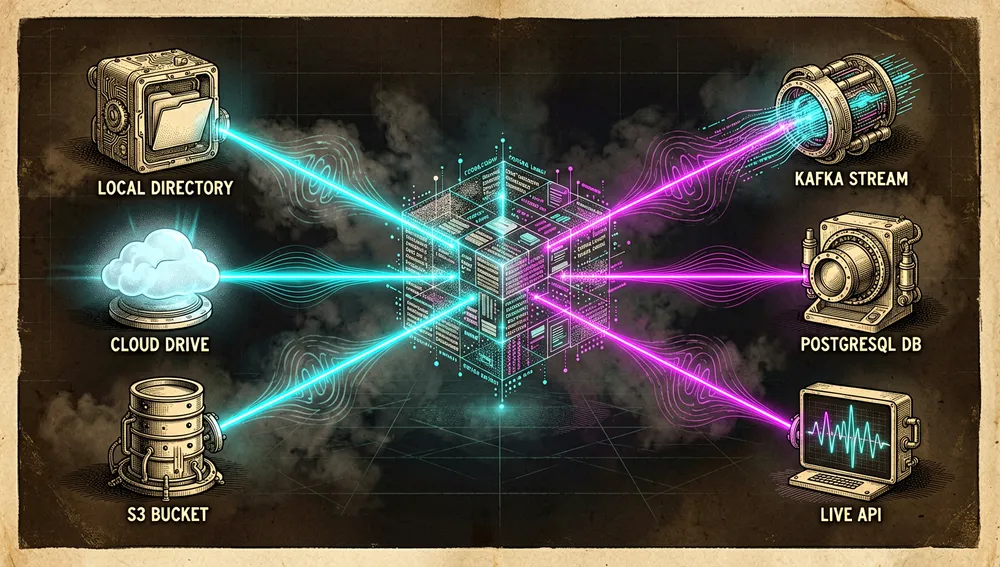
- Ingesta de datos: las fuentes se definen en
app.yaml(directorios locales, Google Drive, SharePoint, S3, Kafka, PostgreSQL, APIs). El código encadena estos orígenes a intervalos configurables y re-indexa en tiempo real. - Parseo y troceado: con Docling (vía
DoclingParser) yTokenCountSplitter. - Incrustación: por defecto
OpenAIEmbedder; sustituible por otro incrustador. - Indexado:
USearchKnnFactorypara el índice vectorial; opcionalmente un índice híbrido que combinaUSearchKNNconTantivyBM25medianteHybridIndex. - Servicio:
SummaryQuestionAnswerermaneja preguntas y resúmenes, yQASummaryRestServerexpone los endpoints.
Endpoints por defecto de la plantilla por defecto:
| Categoría | Endpoint | Uso |
|---|---|---|
| Indexado de documentos | /v1/retrieve | Búsqueda por similitud |
/v1/statistics | Estadísticas básicas del índice | |
/v2/list_documents | Metadatos de todos los archivos procesados | |
| LLM / RAG | /v2/answer | Preguntar a los documentos o hablar con el LLM |
/v2/summarize | Resumir una lista de textos |
Las diez plantillas del repositorio (verificado en templates/):
| Plantilla | Descripción (según su README) |
|---|---|
question_answering_rag | RAG end-to-end básico: responde sobre PDF/DOCX de una fuente en vivo |
document_indexing | Indexado en vivo que actúa como almacén vectorial / recuperador (backend para LangChain o LlamaIndex) |
multimodal_rag | RAG multimodal con GPT-4o; extrae tablas y gráficas de documentos financieros |
unstructured_to_sql_on_the_fly | Convierte datos financieros no estructurados en SQL + carga en PostgreSQL |
adaptive_rag | RAG con Adaptive RAG para reducir el coste en tokens hasta 4× manteniendo precisión |
private_rag | RAG totalmente privado/local con Mistral y Ollama |
slides_ai_search | Indexado multimodal de diapositivas (PowerPoint y PDF) con índice en vivo |
video_rag_twelvelabs | RAG sobre video con TwelveLabs |
document_store_mcp_server | Expone el indexado en vivo como servidor MCP (tres herramientas, filtrado por JMESPath) |
drive_alert | RAG sobre Google Drive con alertas en tiempo real (Slack) cuando las respuestas cambian |
El ecosistema
Repositorio hermano principal (el motor). pathwaycom/llm-app es el catálogo de plantillas de pathwaycom/pathway, el marco base que contiene la librería y el motor en Rust: «Python ETL framework for stream processing, real-time analytics, LLM pipelines, and RAG»; 62.344 estrellas, 1.686 bifurcaciones, creado el 27 de noviembre de 2022, licencia personalizada (marcada NOASSERTION por la API), última versión publicada v0.32.1 (1 de agosto de 2026), distribuido en PyPI como paquete pathway.
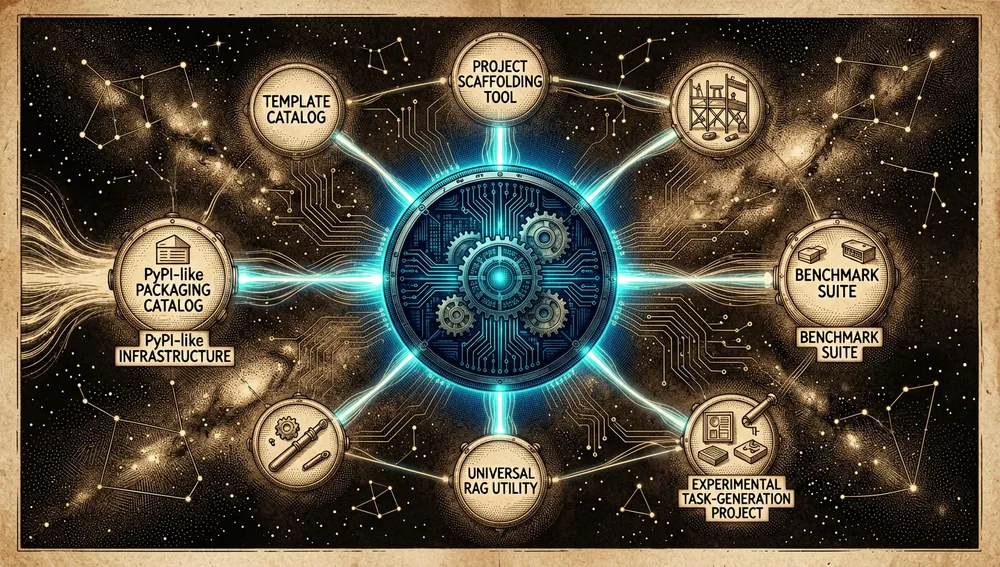
Otros repositorios de la organización pathwaycom (estrellas según la API de GitHub, de mayor a menor): pathwaycom/arc-task-gen — 10.565 estrellas — «Generates original ARC-AGI-1-style tasks»; pathwaycom/bdh — 3.544 estrellas — «BDH (Dragon Hatchling) – Architecture and Code»; pathwaycom/pathway-benchmarks — 302 estrellas; pathwaycom/cookiecutter-pathway — 277 estrellas; pathwaycom/serviette — 4 estrellas — «Universal RAG tool».
Bibliotecas externas que la arquitectura incorpora: usearch (unum-cloud/usearch) para el índice KNN por defecto, Tantivy (quickwit-oss/tantivy) para el índice híbrido, y Docling (docling.ai) para el parseo de documentos. Integraciones documentadas: LangChain y LlamaIndex (la plantilla document_indexing puede servir de backend de recuperación para ambas), TwelveLabs (RAG de video), el Model Context Protocol (MCP), Slack (alertas en drive_alert), y proveedores de LLM OpenAI, Mistral y Ollama.
Estado oficial / semioficial
llm-app es un producto de primera parte de Pathway: el README termina con la sección «Supported and maintained by» que acredita explícitamente a Pathway, y el repositorio es el canal oficial de plantillas (pathway.com/developers/templates/). No existe una «aceptación en un marketplace» de terceros; su estatus es el de repositorio oficial de referencia de la empresa para construir apps RAG sobre su propio marco.
En la práctica: es el conjunto de implementaciones de referencia que Pathway mantiene y respalda (los bugs se abren en el tracker del marco base, no en llm-app); el marco subyacente se distribuye como paquete oficial pathway en PyPI; el conector de SharePoint está gated tras una license key Scale o Enterprise (Pathway ofrece una clave Scale gratuita); y el marco base aparece en Trendshift como repositorio en tendencia.
Guía rápida de uso
Instalación y primer arranque
# 1. Clonar el repositorio
git clone https://github.com/pathwaycom/llm-app.git

# 2. Entrar a la plantilla
cd templates/question_answering_rag

# 3. Instalar dependencias (solo para ejecución local, no Windows)
pip install -r requirements.txt

# 4. Configurar la clave de OpenAI en .env  ->  OPENAI_API_KEY=sk-...

# 5. Ejecutar
python app.py
O bien con Docker (única vía documentada para Windows):
docker compose build
docker compose up
En el primer arranque verás en los logs el parseo y la incrustación de los documentos de ejemplo. Cuando aparezca 0 entries (x minibatch(es)) have been... y dejen de llegar actualizaciones, la app está lista:
curl -X POST http://localhost:8000/v1/statistics \
  -H 'accept: */*' -H 'Content-Type: application/json'
Flujos de trabajo habituales
- Listar documentos indexados:
POST /v2/list_documents→ metadatos de todos los archivos procesados. - Buscar por similitud:
POST /v1/retrieve -d '{"query": "tu pregunta", "k": 6}'→ chunks más parecidos (admitemetadata_filterpor JMESPath yfilepath_globpattern). - Preguntar con RAG:
POST /v2/answeryPOST /v2/summarize. - Cambiar el modelo: en
app.yaml, editar el campomodeldel bloque$llm(por defectogpt-4.1-mini; ejemplos congpt-5,gpt-4.1,gpt-4o, oLiteLLMChatapuntando a Ollama local).
Configuración esencial
app.yaml: define orígenes de datos, LLM, incrustador e índice; el único archivo que difiere entre plantillas..env:OPENAI_API_KEYobligatorio (y paradrive_alert,slack_alert_channel_idyslack_alert_token).$sourcesenapp.yaml: local, Google Drive (refresh_intervalpor defecto 30 s), o SharePoint (requiere clave de licencia).host/port: por defecto0.0.0.0/8000.- Cache / persistencia:
persistence_mode,persistence_backend(p. ej.Backend.filesystem).
Trampas frecuentes y soluciones
- Windows no soporta ejecución local: el README indica usar Docker.
- Consultar antes de que termine el indexado inicial: esperar al mensaje
0 entries (x minibatch(es)) have been.... - SharePoint requiere licencia: sin clave Scale/Enterprise ese conector no funciona.
- Google Drive exige cuenta de servicio: se necesita
object_idy credenciales válidas. - Deduplicación de alertas basada en LLM: en el hilo 38304483, el usuario
pstormpropuso comparar similitud de embebidos en lugar de gastar llamadas LLM para detectar cambios;janchorowskirespondió que el criterio es fácilmente intercambiable y que la vía LLM es más rápida para empezar, pero que con el tiempo se puede entrenar un criterio sobre embebidos.
Integraciones y migración
- Backend de recuperación de LlamaIndex / LangChain: la plantilla
document_indexingsirve como almacén vectorial / recuperador desde cualquier frontend o app LlamaIndex/LangChain. - MCP:
document_store_mcp_serverexpone el indexado en vivo con tres herramientas (retrieve_query,statistics_query,inputs_query). - Slack:
drive_alertenvía notificaciones cuando una respuesta cambia. - Deployment en la nube: guías de despliegue en GCP, AWS Fargate, Azure (ACI) y Render.
- Sustitución de componentes: migrar de un índice vectorial a uno híbrido, o de OpenAI a Ollama/Mistral local, es un cambio en el YAML sin tocar
app.py.
Métricas actuales
Medición: 4 de septiembre de 2026, API de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 58.937 |
| Bifurcaciones | 1.478 |
| Suscriptores | 94 |
| Commits | 253 |
| Incidencias abiertas indicadas por la API | 8 |
| Lenguaje principal | Jupyter Notebook (409.401 bytes); secundarios: Python (68.370), Dockerfile (3.888) |
| Licencia | MIT |
| Creación | 19 de julio de 2023 |
| Último empuje | 5 de julio de 2026 |
| Última publicación | Ninguna: no usa releases ni tags versionados |
Los principales contribuidores fueron berkecanrizai (48), szymondudycz (45), pw-ppodhajski (33), dxtrous (19), olruas (14), Boburmirzo (9), janchorowski (9) y embe-pw (9). El conteo de 253 commits se obtuvo de la cabecera de paginación del endpoint de commits. open_issues_count puede incluir solicitudes de cambios abiertas. watchers_count replica las estrellas, por lo que se informa por separado subscribers_count como suscriptores reales.
Recepción de la comunidad
La evidencia recuperada procede de varios hilos de Hacker News, todos con audiencia pequeña-moderada, más un hilo del marco base que sí alcanzó una cifra notable:
Reconocimiento:
- En el hilo del marco base 40669434 (73 pts, 19 comentarios),
articsputnikescribió que es «impresionante ver una herramienta de Python para tareas de ETL y RAG con features tan sólidas» y que centrarse en seguridad y rendimiento, «especialmente con pipelines de RAG self-hosted, es fantástico». pipboyguy, en el mismo hilo, aportó un caso de uso real: «I’ve built DE and AI solutions based on Pathway for multiple clients. It’s robust and fast.»devnull777: «Los ejemplos de tu sitio se ven fáciles de reproducir. Por cierto, ¡qué web tan bonita y clara!».- En 36894142 (11 pts, 8 comentarios),
Arimbrse mostró interesado yanupsurendrancerró el intercambio diciendo que «entiende mucho mejor» la distinción índice/base de datos tras la respuesta del equipo.
Crítica y escepticismo concreto:
- En 40669434,
snowpidreaccionó con escepticismo a la etiqueta «NATO»: «Good old “Enterprise” NATO! Always good for a surprise», ysuziemanulrespondió bromeando que «algunos dicen que no es Fortune 100 sino Fortune 1». El equipo no desmintió la afirmación del titular. threecheese, en el mismo hilo, preguntó por la RAM del plan «Community» (8 GB) y señaló que el motor Rust está «shipped as compiled executable, con comprobación de licencia»;dxtrous(Pathway) respondió que el factor principal del consumo de RAM es el tamaño de los datos alimentados.- En 42318221 (8 pts, 2 comentarios),
Arimbrpidió «ver en un solo lugar todos los campos y valores soportados»;janchorowskirespondió que lo harían. - En 38304483 (8 pts, 5 comentarios),
pstormcuestionó el enfoque de deduplicación, ybobur_umurzokovamplió el alcance proponiéndolo para detección de fraude, soporte al cliente, diagnóstico médico y mantenimiento predictivo.
El balance: entusiasmo técnico y casos de uso reales, con audiencia mayoritariamente modesta en las plantillas, pero un hilo del marco base con 73 puntos y 19 comentarios que introduce escepticismo razonado sobre el titular corporativo y el modelo de hosting/licencia.
Comparación con proyectos similares
| Proyecto | Coincidencia verificable | Diferencia verificable |
|---|---|---|
| Stack RAG clásico: Pinecone / Weaviate / Qdrant / pgvector + Redis + FastAPI | Todos resuelven «RAG sobre documentos corporativos» con base vectorial + caché + API. | El README declara que no requiere montar esos componentes por separado: índice vectorial, índice híbrido y caché van integrados en la librería. |
| LlamaIndex / LangChain | Ambos son frameworks de recuperación de documentos para LLM. | llm-app los trata como clientes de su índice, y aporta la sincronización en tiempo real de las fuentes. |
pathwaycom/pathway (repositorio hermano) | Mismo marco subyacente; llm-app solo contiene plantillas sobre él. | pathway es la librería/motor (Python + Rust, PyPI); llm-app es el catálogo «listo para desplegar» de apps. |
| TwelveLabs (RAG de video) | Ofrece RAG sobre video. | llm-app consume a TwelveLabs dentro de su plantilla video_rag_twelvelabs; no compite, lo integra. |
La comparación más útil: llm-app destaca cuando el requisito es RAG que se mantiene sincronizado en tiempo real con fuentes corporativas, sin montar infraestructura vectorial/caché/API por separado.
Cómo contribuir
- Acepta contribuciones de documentación, funcionalidades, correcciones, limpieza de código, pruebas y revisiones.
- La vía recomendada para contribuciones que requieren más trabajo es señalarlo en el servidor de Discord de Pathway (canal #get-help) antes de empezar.
- Los bugs y feedback se abren en el tracker del marco base (
pathwaycom/pathway/issues), no enllm-app. - Al ser plantillas con un único
app.yamlpor plantilla, la forma práctica de contribuir una variación es partir de una plantilla existente y ajustar su YAML.
No se encontró un CONTRIBUTING.md ni una plantilla de PR específica en el repositorio.
Casos de uso y a quién puede ayudar este repositorio
- Equipos que montan RAG sobre documentos corporativos vivos (SharePoint, Google Drive, S3, Kafka, PostgreSQL, APIs):
question_answering_rag+ el conector correspondiente da un índice que se actualiza solo.document_indexingreutiliza ese índice como backend de una app LlamaIndex/LangChain existente. - Departamentos financieros / analistas:
multimodal_ragextrae tablas y gráficas de documentos financieros;unstructured_to_sql_on_the_flyestructura informes PDF en PostgreSQL. - Equipos con restricciones de privacidad / residencia de datos:
private_rag(Mistral + Ollama) permite un pipeline totalmente local. - Quienes buscan reducir coste en tokens:
adaptive_ragdeclara una reducción hasta 4× manteniendo precisión. - Integradores de agentes LLM / MCP:
document_store_mcp_serverexpone el indexado en vivo como servidor MCP. - Equipos que monitorizan cambios en la base de conocimiento:
drive_alertenvía alertas a Slack tras una modificación de documento. - Contenutistas / búsqueda sobre presentaciones y video:
slides_ai_searchyvideo_rag_twelvelabs.
Recursos
- Repositorio: https://github.com/pathwaycom/llm-app
- Marco base (motor): https://github.com/pathwaycom/pathway
- Documentación / sitio oficial: https://pathway.com/developers/templates/
- Guía de configuración YAML: https://pathway.com/developers/templates/configure-yaml
- Plantillas (código): https://github.com/pathwaycom/llm-app/tree/main/templates
- Registros de paquetes: PyPI
pathway(última 0.32.1): https://pypi.org/project/pathway/ - Trendshift: https://trendshift.io/repositories/4400
- Comunidad / Discord: https://discord.gg/pathway
- Hilos de Hacker News relevantes: https://news.ycombinator.com/item?id=40669434 , https://news.ycombinator.com/item?id=36894142 , https://news.ycombinator.com/item?id=38304483 , https://news.ycombinator.com/item?id=40987194 , https://news.ycombinator.com/item?id=42318221
Nota: este artículo combina el README de pathwaycom/llm-app, los README de las plantillas, la API de GitHub, los hilos de Hacker News y PyPI, consultados el 4 de septiembre de 2026. Las cifras de estrellas y versiones cambian con el tiempo.
Comentarios