

vibe-coding-cn: der chinesische Vibe-Coding-Leitfaden, den die eigenen Issues des Kopierens bezichtigen
2025Emma/vibe-coding-cn · 22.991★ · 2.420 forks
2025Emma/vibe-coding-cn ist eine chinesischsprachige Wissensdatenbank mit dem Titel „Vibe Coding 指南” (Vibe-Coding-Leitfaden): ein Repository, das eine Methodik für KI-gepaartes Programmieren, Hunderte organisierter Prompts, eine Sammlung von Skills und ein kleines Prompt-Konvertierungstool bündelt. Es ist kein installierbares Produkt, kein Server und keine öffentliche Bibliothek: Sein Wert liegt im lesbaren Inhalt (Methodik, Prompts, Skills, Dokumentation) und in einem einzigen ausführbaren Skript zur Verwaltung der Prompt-Datenbank. Was dieses Repository definiert, ist nicht sein technischer Inhalt — der stammt von anderswo —, sondern seine Herkunft: Es ist eine Kopie der von tukuaiai (heute tradecatlabs) gepflegten chinesischen Version, und dieser Umstand erklärt sowohl seine über 22.000 Sterne als auch die offene Kritik, die es in seinen eigenen Issues erhält.
Ursprung
Der Inhalt dieses Repositorys entstand nicht hier, sondern geht auf einen englischsprachigen Leitfaden zurück:
EnzeD/vibe-coding— „Ultimate Guide to Vibe Coding V1.2.2”, erstellt von Nicolas Zullo (@NicolasZu) am 12. März 2025. Es ist das originale englischsprachige Werk (4.782 Sterne und 2.064 Forks, gemessen am 10. September 2026). Das README erklärt ausdrücklich Zullos Urheberschaft und das Erstellungsdatum.tradecatlabs/vibe-coding-cn(frühertukuaiai/vibe-coding-cn, ID 1102195393) — die Anpassung und Erweiterung ins Chinesische, erstellt am 23. November 2025 als Fork des ursprünglichen Leitfadens. Es zeigt 16.149 Sterne und 1.618 Forks; die Titelseite verlinkt zux.com/123olp, und das README schreibt das Projekt tukuaiai, Nicolas Zullo und 123olp zu.2025Emma/vibe-coding-cn(dieses Repository) — erstellt am 17. Dezember 2025 vom Konto2025Emma(Konto eröffnet am 23. Januar 2025, 103 Follower, 10 öffentliche Repositorys, ohne Namen oder Biografie). Es ist eine Kopie der Version vontukuaiai: Alle 130 Commits sind vollständig vontukuaiaisigniert, der erste davon „Initial commit: Synchronize local state with remote” (13. Dezember 2025). Das README verlinkt weiterhin Abzeichen, Issues und Contributor-Bilder zutukuaiai/vibe-coding-cnund wiederholt dasselbe Autoren-Trio (tukuaiai, Nicolas Zullo, 123olp).
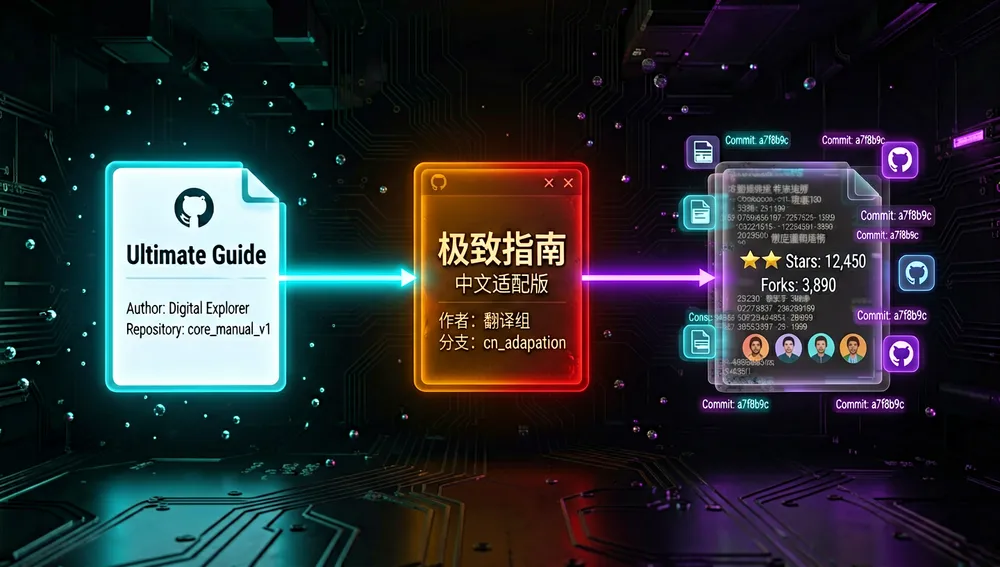
Das README selbst schreibt es am Fuß seines Einstiegsabschnitts: Dieser Installationsabschnitt sei „vom ursprünglichen Autor, ich habe ihn nicht geschrieben; ich habe ihn nur auf das aktualisiert, was ich für das beste Modell halte”. Der Leitfaden hat sich über Modellversionen hinweg weiterentwickelt: Das README dokumentiert den Übergang Grok 3 → Gemini 2.5 Pro → Claude / Codex. Kurz gesagt: Dieses Repository ist ein neu gehosteter Spiegel einer Übersetzung, nicht die Quelle der Methode.
Philosophie und Prinzipien
Das README fasst die Philosophie in einer zentralen Maxime und einem vierstufigen Rahmenwerk zusammen:
- Maxime: „规划就是一切” (Planung ist alles). Man darf die KI nicht autonom planen lassen, sonst wird der Code zu einem unhandhabbaren Durcheinander. Die operative Definition des Repos lautet: Vibe Coding = Planung nach Design + fester Kontext + KI-gepaarte Ausführung.
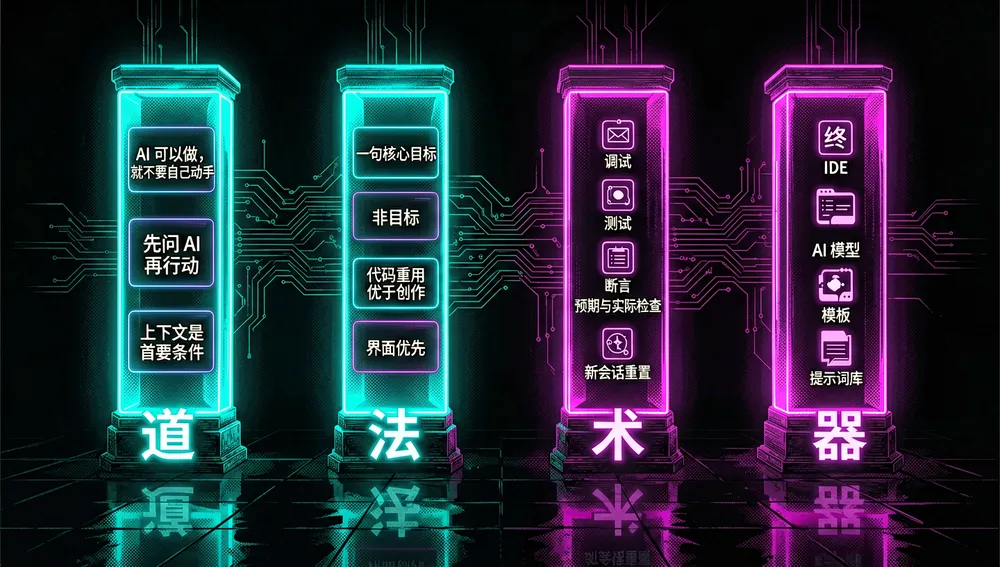
- Rahmenwerk 道法术器 (Dao–Fa–Shu–Qi), entlehnt aus der klassischen chinesischen Struktur:
- 道 (Weg) — Prinzipien: „wenn die KI es kann, mach es nicht von Hand”; „bei jedem Problem die KI fragen”; der Kontext ist das wichtigste Element (Müll rein, Müll raus); Struktur vor Code; Ockhams Rasiermesser; das Pareto-Prinzip (die wichtigen 20 %).
- 法 (Methode): ein Ein-Satz-Ziel + Nicht-Ziele; „wenn es kopiert werden kann, nicht schreiben” (bestehende Repos wiederverwenden); zuerst die offizielle Dokumentation lesen und der KI geben; nach Verantwortlichkeit aufteilen; Schnittstelle zuerst, Implementierung danach; jeweils nur ein Modul anfassen; die Dokumentation ist der Kontext.
- 术 (Technik): klarstellen, was geändert werden kann und was nicht; Debugging nur mit „erwartet vs. tatsächlich + minimale Reproduktion”; Tests können von der KI geschrieben werden, aber Assertions werden vom Menschen überprüft; eine neue Sitzung eröffnen, wenn der Code wächst.
- 器 (Werkzeuge): IDE/Terminal, KI-Modelle, Entwicklungswerkzeuge und Vorlagen.
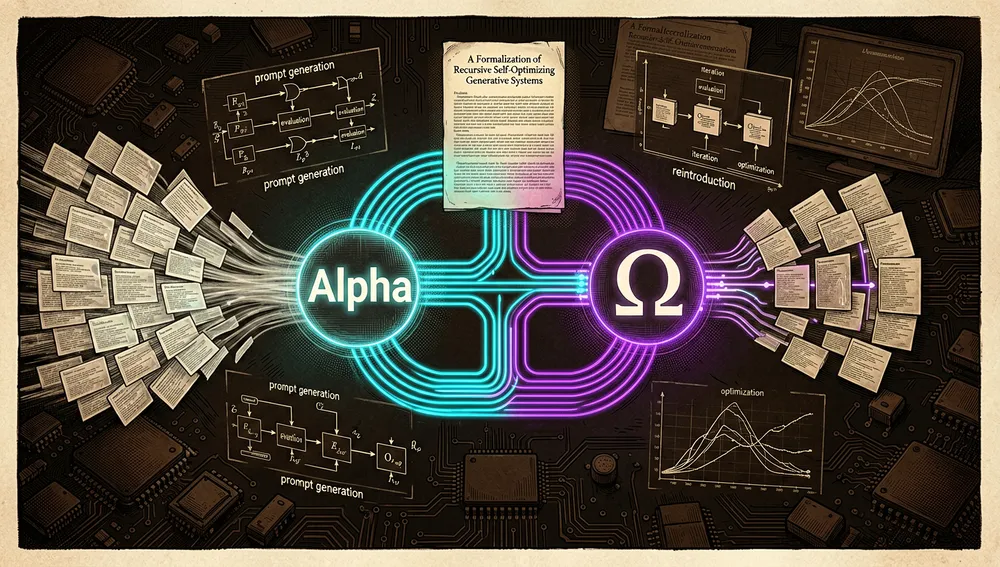
- Die α/Ω-Methodik (rekursive Selbstoptimierung): ein generativer „Mutter”-Prompt (α) und ein Optimierer (Ω) bilden eine rekursive Schleife: Ω optimiert α, α generiert die Ziel-Prompts, und das Ergebnis fließt für die nächste Iteration zurück. Das Repo verlinkt ein internes Dokument mit dem Titel „A Formalization of Recursive Self-Optimizing Generative Systems”.
- Modellhierarchie: Das README ordnet Modelle in drei Stufen ein und empfiehlt, für komplexe Aufgaben nur die oberste zu verwenden (in seiner Lesart:
codex-5.1-max-xhigh,claude-opus-4.5-xhigh,gpt-5.2-xhigh).
Das README warnt außerdem, dass „die folgenden Erfahrungen nicht universell anwendbar sind; sie sollten dialektisch je nach Kontext übernommen werden”.
Wie es funktioniert
Der dokumentierte Ablauf (ein Spiegel des ursprünglichen Leitfadens) ist ein geplanter, auditierbarer Zyklus:
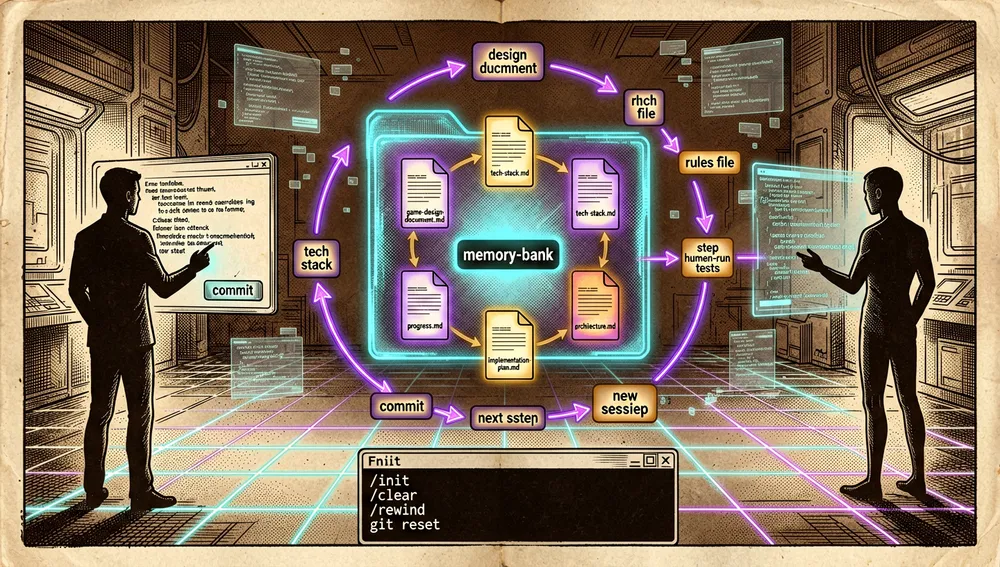
- Designdokument (GDD) oder PRD: die KI um ein
game-design-document.md(oder ein PRD bei einer Anwendung) in Markdown bitten; es überprüfen und bewusst einfach halten. - Tech-Stack + Regeln (
CLAUDE.md/AGENTS.md): um den „einfachsten, aber robustesten” Stack bitten undtech-stack.mdspeichern;/initin Claude Code oder Codex CLI verwenden, um die Regeln zu generieren; sie überprüfen und kritische Regeln als „Always” markieren (z. B. „immermemory-bank/architecture.mdund das Designdokument lesen, bevor Code geschrieben wird”). - Implementierungsplan: mit dem GDD und dem Stack einen Markdown-Plan aus kleinen, konkreten Schritten generieren; jeder Schritt enthält einen Verifikationstest; kein Code, nur Anweisungen; sich zuerst auf das Basisspiel konzentrieren.
- Memory Bank (
memory-bank): ein Projektordner mit fünf Dateien:game-design-document.md,tech-stack.md,implementation-plan.md,progress.md(leer, zum Vermerken erledigter Schritte) undarchitecture.md(leer, zum Vermerken der Funktion jeder Datei).
- Schrittweise programmieren: die gesamte
memory-banklesen, um Klärung bitten (die KI stellt meist 9–10 Fragen), Schritt 1 ausführen; der Mensch führt die Tests aus; nach Validierung Commit, einen neuen Chat öffnen (/clearoder/new) und mit Schritt 2 fortfahren; wiederholen, bis der Plan erschöpft ist. - Details hinzufügen: für jede wichtige Funktion ein
feature-implementation.mdmit kurzen Schritten und Tests erstellen. - Fehler beheben und Blockaden lösen:
/rewindin Claude Code (odergit resetin Codex); den Browser-Konsolenfehler einfügen (F12); bei schweren Blockaden das gesamte Repository mit RepoPrompt/uithub komprimieren und die KI um Hilfe bitten. - Tricks: Denkaufwand-Stufen
think < think hard < think harder < ultrathink;/compact, um den Kontext zu verkürzen; und, auf eigenes Risiko,--yolo/--dangerously-skip-permissions, um Bestätigungen zu deaktivieren.
Der eigentliche Inhalt des Repos ist organisiert unter i18n/zh/prompts/ (Unterordner system_prompts, coding_prompts, assistant_prompts, user_prompts), i18n/zh/skills/ (einschließlich einer claude-skills-Meta-Skill, die Skills generiert), i18n/zh/documents/ (Methodik, Vorlagen und Tutorials) und libs/ (mit dem Prompt-Tool und dem Lokalisierungstool).
Das Ökosystem
Das „Ökosystem” dieses Repositorys ist vor allem seine Abstammung und interne Werkzeuge, keine Plugin-Community drumherum:
EnzeD/vibe-coding(Nicolas Zullo) — das originale englische Werk; 4.782 Sterne, 2.064 Forks.tradecatlabs/vibe-coding-cn(frühertukuaiai/vibe-coding-cn) — die chinesische Version, von der dieses Repo kopiert; 16.149 Sterne, 1.618 Forks.2025Emma/vibe-coding-cn(dieses Repository) — 22.972 Sterne, 2.416 Forks.- Bemerkenswerte Forks dieses Repos:
MaoTouHU/vibecodingcn(303 Sterne, der sichtbarste); außerdem Dutzende von Forks mit 1 Stern (z. B.Miranda-2000/vibe-coding-cn,zhanggan0607-blip/vibe-coding-cn,viasyllable/vibe-coding-cn, unter anderen). - Interne Werkzeuge des Repos (dasselbe Projekt):
libs/external/prompts-library/— ein Prompt-Konverter zwischen Excel (.xlsx) und Markdown; undlibs/external/l10n-tool/(in der Commit-Historie erwähnt) — Übersetzungskarten zwischen Sprachen. - Lokalisierung: das Repo unterhält 27 Sprachverzeichnisse unter
i18n/(zh, en, ja, ko, es, fr, de, ru, ar, bn, fa, he, hi, id, it, ms, nl, pl, pt, sw, ta, th, tr, uk, ur, vi, ha).
- Externe Repos und Werkzeuge, die das README verlinkt:
x1xhlol/system-prompts-and-models-of-ai-tools(eine Bibliothek von System-Prompts anderer Produkte) undyusufkaraaslan/Skill_Seekers(ein Skill-Generator); auch Produkte wie Superwhisper, BrowserTools, RepoPrompt, uithub und Zread. (Für diese beiden verlinkten Repos wurden in dieser Recherche keine Sternezahlen gemessen.) - Online-Prompt-Datenbank: eine Google-Sheets-Tabelle mit Hunderten kopierbereiter Prompts (im README verlinkt).
Offizieller und halboffizieller Status
Keiner. Dieses Repository ist in keinen offiziellen Marktplatz aufgenommen worden, hat keine Anbieter-Unterstützung und ist kein De-facto-Standard: Es ist eine Community-Wissensdatenbank unter MIT-Lizenz, ohne Releases, ohne Blog, ohne Paketregister-Kanal und mit leerer GitHub-Beschreibung. Die „kanonische” Referenz der Methode ist tatsächlich Nicolas Zullos originaler englischer Leitfaden (EnzeD/vibe-coding) und dessen chinesische Adaption durch tukuaiai/tradecatlabs; die Kopie von 2025Emma hat keinen eigenen offiziellen Status, und ihre eigene Dokumentation verweist weiterhin auf die Issues und Contributor von tukuaiai.
Schnellstart-Anleitung
Installation und erster Start
- Es ist ein „zuerst lesen”-Repo. Es gibt kein
pip installund keine Binary zu installieren: Man klont es oder liest es online. Das Online-Lesen ist verfügbar unter https://zread.ai/tukuaiai/vibe-coding-cn/1-overview (KI-unterstütztes Lesen des Repos); die Quelle liegt unteri18n/zh/. - Um die Methode anzuwenden, muss einer der beiden vom Ablauf empfohlenen Agenten installiert sein: Claude Code (
npm i -g @anthropic-ai/claude-code) oder Codex CLI (npm i -g @openai/codex) — beide Befehle stammen aus dem originalen englischen Leitfaden, den dieses Repo repliziert. Der Ablauf funktioniert in den VSCode-Erweiterungen genauso wie im Terminal. - Die einzige ausführbare Komponente ist der Prompt-Konverter. Im Repository:
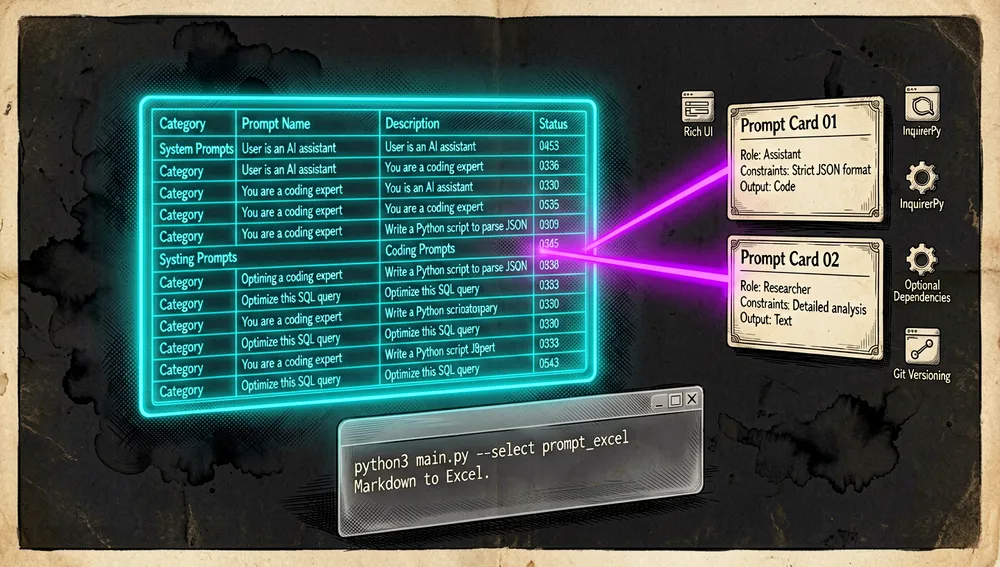
Voraussetzungen: Python 3;cd libs/external/prompts-library python3 main.py # interaktiver Modus: Quelle wählen python3 main.py --select "prompt_excel/<datei>.xlsx" # Excel → Markdown python3 main.py --select "prompt_docs/<verzeichnis>" # Markdown → ExcelrichundInquirerPysind optional (fallen auf eine Textoberfläche zurück, wenn nicht vorhanden).
Gängige Workflows
- Ein Projekt starten: die KI um ein
game-design-document.md(oderPRD.mdfür Apps) bitten → umtech-stack.mdbitten →/init, umCLAUDE.md/AGENTS.mdzu generieren → Implementierungsplan → den Ordnermemory-bankmit den fünf Dateien erstellen. Alles bleibt als in Git versioniertes Markdown erhalten. - Einen Schritt ausführen: „lies die gesamte
memory-bank, mach Schritt N; ich führe die Tests aus; beginne nicht mit Schritt N+1, bis ich validiert habe”; nach Validierung Commit und/clear; das Ergebnis wird inprogress.mdvermerkt, Architektur-Neuerungen inarchitecture.md. - Die Prompt-Datenbank verwalten:
python3 main.py --select …verwenden, um die Sammlung zwischen Excel und Markdown zu konvertieren (z. B. um ein in einer Tabelle gepflegtes Korpus in Git zu versionieren). - Debuggen: wenn ein Prompt das Projekt bricht,
/rewindin Claude Code odergit resetin Codex; den Konsolenfehler (F12) kopieren und einfügen; bei BlockadenRepoPrompt/uithub, um das Repo zu komprimieren und um Hilfe zu bitten.
Wesentliche Konfiguration
memory-bank/— die fünf Dateien, die den langlebigen Kontext verankern (Design, Stack, Plan, Fortschritt, Architektur); das zentrale Element der Methode.CLAUDE.md/AGENTS.md— die Regeln, die der Agent lesen muss; kritische werden als „Always” markiert.i18n/zh/prompts/system_prompts/— System-Prompts, die das Verhalten des Agenten einschränken.i18n/zh/prompts/coding_prompts/— Prompts der Arbeitskette (Anforderungen, Plan, Ausführung).libs/external/prompts-library/scripts/config.yaml— Konfiguration des Konverters (Quell-/Zielordner und Formatzuordnung).
Häufige Fallstricke und Lösungen
- Verwirrende Herkunft: Alle Commits sind von
tukuaiaisigniert, obwohl das Repo unter2025Emmalebt, und das README verlinkt Issues/Abzeichen zutukuaiai. → Vor dem Zitieren oder Verlassen auf das Repo prüfen, welches die kanonische Quelle ist (EnzeD/vibe-codingundtradecatlabs/vibe-coding-cn). - Veralteter Inhalt: Issue #4 weist darauf hin, dass aktuelle Tools fehlen (Claude Code, Codex, Antigravity). → Die empfohlene Modellversion vor dem Kopieren mit dem aktuellen Stand abgleichen.
- Ein als allgemeiner Leitfaden getarntes Spiele-Tutorial: Der ursprüngliche Ablauf ist spielorientiert (GDD); für Anwendungen muss das GDD durch ein PRD ersetzt werden (das klärt die FAQ des README selbst).
- Vermischte Stimmen: Das README kombiniert den Text des ursprünglichen Autors mit Ergänzungen des Übersetzers (das Repo selbst räumt das ein). → Nicht annehmen, dass der gesamte Inhalt vom selben Autor stammt.
- Spam in den Issues: Issue #4 enthält einen Kommentar, der einen Cursor-Lizenzdienst bewirbt. → Das Issue-Register nicht als verlässliche technische Quelle behandeln.
- Keine Beschreibung oder Releases: Die GitHub-Beschreibung ist leer, und es gibt keine Tags; das einzige Statussignal ist die Commit-Historie.
Integrationen und Migration
- Agenten: Die Methode integriert sich mit Claude Code und Codex CLI (CLI und VSCode-Erweiterungen); das README nennt außerdem Cursor, Gemini CLI, Kiro, Antigravity, Copilot, Qwen, GLM und Kimi K2 als Modell-/Dienstalternativen.
- MCP: Das README dokumentiert die Konfiguration von Augment MCP (
auggie-mcp), der Kontext-Engine von Augment, im Tutorial-Ordner. - Migration von der ursprünglichen englischen Version (
EnzeD/vibe-coding): Da dieses Repo deren Übersetzung/Erweiterung ist, bedeutet „zu ihm migrieren” einfach,i18n/zh/zu lesen; um zur kanonischen Version zurückzukehren,i18n/en/lesen oderEnzeD/vibe-codingdirekt klonen. - Angrenzende Werkzeuge: Zread (Repo-Lesen), NotebookLM (Materialzusammenfassung), RepoPrompt/uithub (ein Repo in eine einzige Datei komprimieren, um die KI um Hilfe zu bitten).
Aktuelle Kennzahlen
Messung: 10. September 2026, GitHub-API.
| Kennzahl | Wert |
|---|---|
| Sterne | 22.972 |
| Forks | 2.416 |
| Abonnenten (echte Watcher) | 104 |
| Commits | 130 |
| Offene Issues laut API | 8 |
| Hauptsprache | Python (34.941), Shell (28.256), Makefile (842) |
| Lizenz | MIT |
| Standard-Branch | main |
| Erstellt | 17. Dezember 2025 |
| Letzter Push | 17. Dezember 2025 |
| Letzte Metadaten-Aktualisierung | 10. September 2026 |
| Neuestes Release | Keines (keine Tags/Releases) |
Vorbehalte: Das API-Feld watchers_count spiegelt die Sternezahl wider, daher wird subscribers_count (104) separat als die echten Watcher angegeben. Der Wert von 130 Commits stammt aus dem link-Paginierungs-Header der API (letzte Seite). Die API stellt open_issues_count (8) bereit, das offene Pull Requests einschließen kann und kein reiner Issue-Zähler ist; die erste Seite der Issue-Liste zeigt 10 Elemente zwischen Issues und PRs. Das Feld author der Commits-API signiert alle 130 Commits auf main als tukuaiai und keinen als 2025Emma; der Contributor-Endpunkt (ohne Anonymisierung) schreibt tukuaiai 34 Beiträge zu.
Community-Resonanz
Die dokumentierte Resonanz ist überwiegend kritisch und erscheint ausdrücklich im eigenen Issue-Register des Repositorys:
- Issue #8 „哗众取宠,污染数据” (geschlossen): little-KaoKao behauptet, „das Projekt plagiiert, ist chaotisch, nutzt inländische Social-Media-Trendthemen für Traffic aus, häuft nutzlose Sterne an und verschmutzt das Open-Source-Ökosystem”. Ein anderer Nutzer, potato-vita, bittet ihn, seine Meinung ohne Rückgriff auf KI darzulegen.
- Issue #5 „直接copy?” (direkte Kopie?) (offen): whx156580 fragt „was ist denn nun das Original?”; zivonx schreibt „diese Kopie hat sogar noch mehr Sterne 😂”; Felyx-Fu antwortet „???”
- Issue #2 „建议加一下原作者的链接” (Vorschlag: Link zum ursprünglichen Autor hinzufügen) (offen): bgzo erzählt, „heute war ich total verwirrt, ich dachte, der Autor hätte ein erzwungenes Revert gemacht, und es stellt sich heraus, es sind zwei verschiedene Personen… und diese hat sogar noch mehr Sterne, unglaublich 😂”; LynPtl fügt hinzu „deshalb ist dieses Repo so schmerzhaft zu lesen, ich habe lange gebraucht, um den Thread zu verstehen, und das README ist ein Durcheinander”; dkpress schlussfolgert „deshalb sieht es so seltsam aus, es stiehlt tatsächlich von anderen, widerlich”.
- Issue #4 „Es gibt weitere neue Tools, wie Claude Code, Codex, Antigravity usw.” (offen): eine Beschwerde, dass der Inhalt veraltet ist; der Thread enthält außerdem einen Spam-Kommentar, der einen Cursor-Lizenzdienst bewirbt.
- Issue #7 (offen): „füge eine Beschreibung hinzu, um die Auffindbarkeit zu verbessern” — ein Zeichen dafür, dass dem Repo eine Beschreibung fehlt.
Als breiterer Kontext (nicht diesem Repo zuzuschreiben): Das Konzept „Vibe Coding” erzeugte große Hacker-News-Threads (z. B. Simon Willison, „Vibe coding and agentic engineering are getting closer than I’d like”, 787 Punkte / 885 Kommentare, Item 48037128; und „The cult of vibe coding is dogfooding run amok”, 616 Punkte / 512 Kommentare, Item 47664912). Keiner dieser Threads bezieht sich auf dieses Repository, daher wird daraus keine Resonanz für 2025Emma/vibe-coding-cn abgeleitet.
Es wurde weder ein Product-Hunt-Launch noch eine Anbieter-Befürwortung noch ein verifizierbarer Reddit-Thread festgestellt (die Reddit-API lieferte während dieser Recherche eine 403-Blockade, daher wird dessen völlige Abwesenheit nicht behauptet, sondern nur, dass kein konkreter Thread bestätigt werden konnte).
Vergleich mit ähnlichen Projekten
| Projekt | Verifizierbare Überschneidung | Verifizierbarer Unterschied |
|---|---|---|
EnzeD/vibe-coding (Original, Nicolas Zullo) | Gleiche Planungsmethodik (GDD/PRD → Stack → Plan → memory-bank → getestete Schritte). | Es ist die originale englischsprachige Quelle (4.782 Sterne); die chinesische Version kopiert und erweitert diesen Inhalt. |
tradecatlabs/vibe-coding-cn (früher tukuaiai/vibe-coding-cn) | Es ist die chinesische Version, die dieses Repo repliziert; gleiche Credits (tukuaiai, Nicolas Zullo, 123olp). | 16.149 Sterne; es ist die „andere” Version, die die Issues dieses Repos als kanonisch kennzeichnen. |
x1xhlol/system-prompts-and-models-of-ai-tools | Vom README als Bibliothek von System-Prompts referenziert. | Sammelt Prompts anderer KI-Produkte; ist keine Workflow-Methodik. |
yusufkaraaslan/Skill_Seekers | Vom README als Skill-Generator referenziert. | Ein Werkzeug zum Generieren von Skills; dieses Repo speichert bereits geschriebene Skills. |
obra/superpowers (angrenzend, kein direkter Konkurrent) | Beide erzwingen einen disziplinierten Prozess auf einen Code-Agenten. | Superpowers ist ein installierbares Plugin mit ausführbaren Skills und Hooks; dieses Repo ist eine Wissensdatenbank aus Prompts und Text. |
Der nützlichste Vergleich erfolgt nach Herkunftslegitimität: Für die kanonische Methode sind EnzeD/vibe-coding und tradecatlabs/vibe-coding-cn besser dokumentiert; der Wert von 2025Emma/vibe-coding-cn liegt darin, ein Spiegel mit mehr Sprachen und einem Prompt-Korpus zu sein, nicht die Quelle.
Wie man beiträgt
CONTRIBUTING.md dokumentiert einen einfachen Ablauf (und verlinkt erneut zum Issue-Tracker von tukuaiai, nicht zu dem von 2025Emma):
- Fehler oder Vorschläge melden über Issues, mit detaillierter Problembeschreibung.
- Änderungsvorschlag (PR): (1) das Repo forken; (2)
git checkout -b feature/YourAmazingFeature; (3) die Änderungen vornehmen; (4)git commit -m 'feat: Add some AmazingFeature'; (5)git push origin feature/YourAmazingFeature; (6) einen Pull Request öffnen. - Es gibt einen
CODE_OF_CONDUCT.md, der vor dem Beitragen gelesen werden soll.
Es wurde weder eine PR-Vorlage noch ein Test-/Evaluierungsgeschirr für den Inhalt beobachtet (es ist ein Dokumentations-Repository); der einzige echte Code (prompts-library) hat ein Makefile und requirements.txt. Da die Beitragsdokumentation zu tukuaiai verweist, sollte ein Contributor klären, an welches Repository sich sein PR richtet.
Anwendungsfälle und wem dieses Repository helfen kann
- Spanisch- oder chinesischsprachige Entwickler, die einen planungsorientierten KI-gepaarten Programmierablauf suchen, mit einer großen kuratierten Prompt-Bibliothek (
system/coding/assistant/user) und demmemory-bank-Muster, um den Kontext über lange Sitzungen hinweg stabil zu halten. - Wer lieber getestete Prompts kopiert, statt sie zu schreiben: Das Korpus von
i18n/zh/prompts/und die Online-Google-Tabelle bieten Hunderte einsatzbereite Prompts zum Einfügen in Claude Code oder Codex CLI. - Teams, die eine lokale, forkbare, MIT-lizenzierte Referenz für Claude-Code-/Codex-CLI-Workflows wollen (das README dokumentiert beide plus Alternativen wie Cursor und Gemini CLI), die geklont und ohne Kontoabhängigkeit angepasst werden kann.
- Studenten und Forscher der „Vibe Coding”-Methodik, die ein konkretes, dokumentiertes Beispiel des 道法术器-Rahmenwerks und der α/Ω-Meta-Methodik suchen, mit einem Architekturdiagramm und einer Observability-Kennzahlentabelle (Prompt-Trefferquote, Durchlaufzeit, Review-Kapazität).
- Betreuer eines Prompt-Korpus in Excel, die es zur Git-Versionierung in Markdown umwandeln müssen (oder umgekehrt): das Werkzeug
prompts-library(main.py) deckt genau diese Konvertierung ab, interaktiv oder mit dem--select-Flag zur Automatisierung. - Hinweis zur richtigen Quellenwahl: Für die kanonische Version der Methode sind Zullos ursprünglicher Leitfaden (
EnzeD/vibe-coding) und die chinesische Version vontukuaiai/tradecatlabsbesser dokumentiert; der spezifische Wert dieses Repos liegt als Spiegel mit mehr Sprachen und einem Prompt-Korpus, nicht als Ursprung.
Ressourcen
- Repository: https://github.com/2025Emma/vibe-coding-cn
- Dokumentation: das Haupt-README (https://github.com/2025Emma/vibe-coding-cn) und der Ordner
i18n/zh/documents/ - Originalversion (Englisch): https://github.com/EnzeD/vibe-coding
- Ursprüngliche chinesische Version: https://github.com/tradecatlabs/vibe-coding-cn (früher
tukuaiai/vibe-coding-cn) - Offizielle Skills (aus dem Repo): https://github.com/2025Emma/vibe-coding-cn/tree/main/i18n/zh/skills (einschließlich der
claude-skills-Meta-Skill) - Online-Prompt-Datenbank (Google Sheets): https://docs.google.com/spreadsheets/d/1ngoQOhJqdguwNAilCl1joNwTje7FWWN9WiI2bo5VhpU/
- KI-unterstütztes Lesen des Repos (Zread): https://zread.ai/tukuaiai/vibe-coding-cn/1-overview
- Community / Telegram: https://t.me/glue_coding (Gruppe) und https://t.me/tradecat_ai_channel (Kanal)
- Ursprünglicher Autor: https://x.com/NicolasZu
- Community-Reviews / Issues (u. a. #2, #4, #5, #8): https://github.com/2025Emma/vibe-coding-cn/issues
- Kontext des „Vibe Coding”-Konzepts auf HN (beziehen sich nicht auf dieses Repo): https://news.ycombinator.com/item?id=48037128 , https://news.ycombinator.com/item?id=47664912
- Paketregister: N/A (kein Publishing auf npm/PyPI/crates.io; nur ein lokales Skript
prompts-library) - Offizieller Blog oder Changelog: N/A (keine Releases oder Blog gefunden)
Methodischer Hinweis: Dieser Artikel stützt sich auf das README und die CONTRIBUTING.md des Repositorys, die GitHub-API (Repo, Commits, Contributor, Issues und Forks), die Hacker-News-/Algolia-API und Issue-Antworten, konsultiert am 10. September 2026. Zahlen ändern sich mit der Zeit; die Herkunft des Inhalts (Original → chinesische Version → diese Kopie) wird anhand der in dieser Recherche abgerufenen Repos und Commits verifiziert.
Kommentare