

autoresearch: un laboratorio nocturno para que un agente itere sobre un modelo
karpathy/autoresearch · 96.768★ · 13.524 forks
Todo lo que hay que saber sobre karpathy/autoresearch: un experimento mínimo de entrenamiento de modelos de lenguaje en el que un agente modifica un único archivo, mide el resultado y conserva o revierte cada intento.
Qué es autoresearch
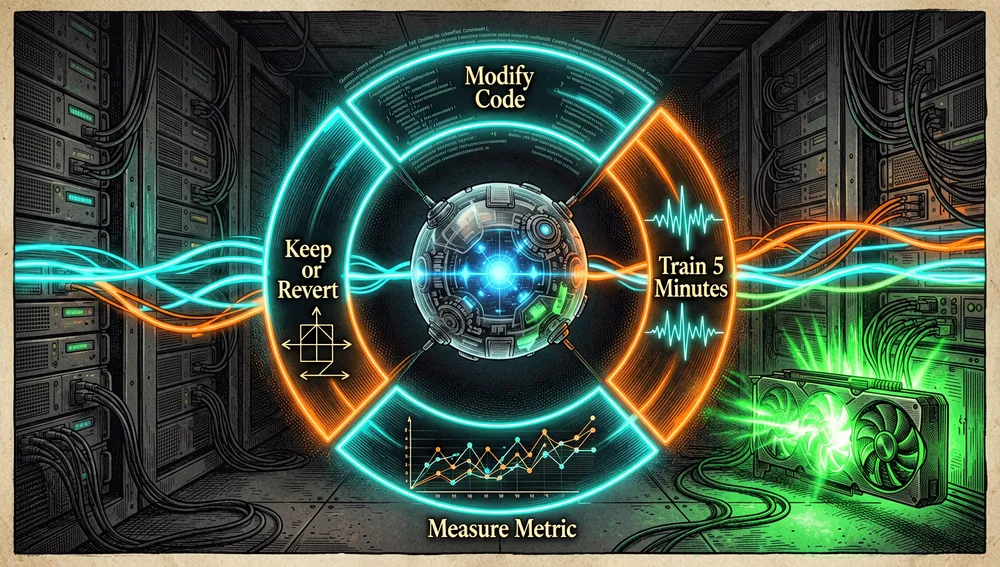
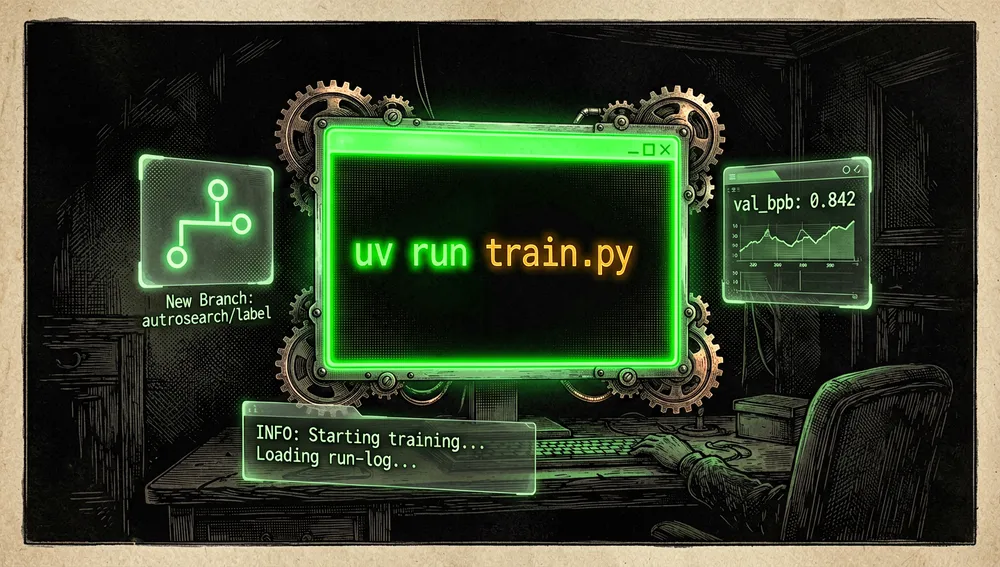
autoresearch es un repositorio de Andrej Karpathy para dejar que un agente de IA ejecute experimentos de entrenamiento de un modelo de lenguaje durante horas. La descripción oficial lo resume como investigación automática sobre el entrenamiento de nanochat en una sola GPU; el README concreta el ciclo: modificar código, entrenar cinco minutos, medir, conservar o descartar y repetir.
No intenta ser un sistema general de AutoML ni un producto de laboratorio distribuido. Es una reducción deliberada del problema a un entorno pequeño y medible: una GPU NVIDIA, un modelo GPT, una métrica (val_bpb, bits por byte de validación; cuanto menor, mejor) y una superficie de modificación controlada.
El origen: una ficción de enjambres y un prototipo mínimo
GitHub registra la creación de karpathy/autoresearch el 6 de marzo de 2026. Su autor es Andrej Karpathy (karpathy), cuya cuenta de GitHub se presenta como una persona interesada en entrenar redes neuronales profundas con grandes conjuntos de datos y ubica su perfil en Stanford. El README está fechado de forma narrativa en marzo de 2026: abre imaginando un futuro de enjambres autónomos de agentes que modifican código más allá de la comprensión humana y presenta este repositorio como el comienzo de esa historia.
La propuesta nace como una simplificación de karpathy/nanochat: el README dice explícitamente que el código de entrenamiento es una versión reducida de ese repositorio. La tensión que intenta resolver no es una carencia de un agente concreto, sino el coste de hacer investigación iterativa manualmente: el humano deja de editar archivos Python en cada ronda y, en su lugar, diseña program.md, el documento que da contexto e instrucciones operativas al agente.
El primer envío de Hacker News, 47291123, enlazó el repositorio y obtuvo 208 puntos y 20 comentarios. Allí ya apareció la discusión que acompañaría al lanzamiento: si esto representa investigación guiada por agentes o una forma de ajuste de hiperparámetros envuelta en un bucle de lenguaje natural.
Filosofía y principios
El diseño documentado se apoya en principios muy concretos:
- Una única variable de éxito.
val_bpbes la fuente de verdad y se compara bajo un presupuesto fijo de cinco minutos; el README sostiene que no depende del tamaño del vocabulario y facilita comparar cambios arquitectónicos. - Cambios con alcance estrecho. El agente solo modifica
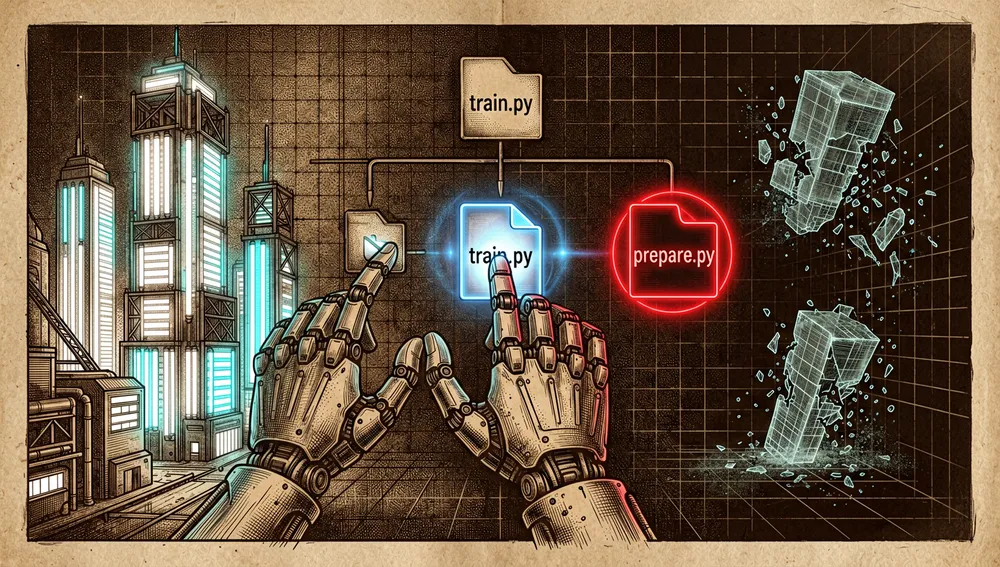
train.py;prepare.py, que contiene preparación, carga de datos, evaluación y constantes, no se toca. - Comparabilidad en la misma máquina, no entre máquinas. Cada ejecución consume el mismo tiempo de entrenamiento, pero los resultados quedan optimizados para la plataforma concreta y no son comparables directamente con los de otra GPU.
- Conservar evidencia, revertir el resto. Cada intento se registra con una confirmación de Git y en
results.tsv; un resultado peor o igual devuelve la rama al estado previo. - Simplicidad como criterio adicional.
program.mdpide ponderar la complejidad: una mejora pequeña que añade código frágil puede no merecer conservarse, mientras que simplificar sin empeorar la métrica sí cuenta como avance.
Esto convierte el repositorio en un ejemplo de optimización empírica acotada, no en una demostración de que el agente produzca conocimiento científico generalizable por sí solo.
Cómo funciona
El flujo principal tiene tres piezas:
| Archivo | Papel documentado |
|---|---|
prepare.py | Descarga datos, entrena el tokenizador BPE, proporciona carga de datos y evaluación; es de solo lectura para el agente. |
train.py | Contiene modelo GPT, optimizador Muon + AdamW y bucle de entrenamiento; es el único archivo que el agente puede modificar. |
program.md | Instrucciones para el agente; es el archivo que modifica el humano para definir la organización de investigación. |
El inicio manual documentado es uv sync, uv run prepare.py y uv run train.py. Requiere Python 3.10 o superior, uv y una GPU NVIDIA; el README declara pruebas en H100. Después se puede iniciar Claude, Codex u otro agente en el repositorio, sin permisos, y pedirle que lea program.md y prepare un experimento.
program.md prescribe un protocolo preciso: crear una rama autoresearch/<etiqueta>, comprobar la caché, inicializar results.tsv, ejecutar primero la línea base y después repetir editar → confirmar → uv run train.py > run.log 2>&1 → extraer val_bpb y VRAM → registrar → conservar o revertir. Una ejecución que supere diez minutos se trata como fallo. Si un cambio falla por falta de memoria o error de código, se anota como crash; el documento pide continuar de forma autónoma hasta que una persona lo interrumpa.
El train.py recuperado confirma la implementación de un GPT en PyTorch para una única GPU, con atención Flash Attention 3 y selección de un repositorio de kernels según la capacidad CUDA. No es una afirmación de portabilidad: el README declara que, en su forma principal, el código requiere una GPU NVIDIA y prefiere no ampliar el núcleo con soporte para CPU o MPS.
Estado oficial y semioficial
No se recuperó evidencia de que autoresearch haya sido aceptado en un mercado oficial de un proveedor ni de una certificación o respaldo formal de Anthropic, OpenAI, NVIDIA u otra empresa. El README sí nombra Claude y Codex como posibles agentes que pueden ejecutar el protocolo, pero eso describe compatibilidad de uso, no una integración oficial.
Su condición práctica es la de referencia de facto para un patrón: la búsqueda de GitHub recuperó numerosas extensiones que se describen explícitamente como inspiradas por Karpathy y el repositorio documenta puertos notables. Esa difusión no equivale a estandarización formal ni valida la calidad de los resultados generados por cada derivado.
El ecosistema
Repositorios relacionados del autor
karpathy/nanochates el repositorio padre técnico según el README;autoresearchsimplifica su entrenamiento. La API de GitHub lo mostraba con 56.896 estrellas y 7.876 bifurcaciones.karpathy/nanoGPT, descrito por su autor como un repositorio simple y rápido para entrenar o ajustar GPT de tamaño medio, tenía 61.807 estrellas y 10.638 bifurcaciones.karpathy/llm.c, entrenamiento de modelos de lenguaje en C/CUDA, tenía 30.711 estrellas y 3.716 bifurcaciones.
Son proyectos del mismo autor, no componentes requeridos para ejecutar autoresearch; la dependencia narrativa y técnica que el README confirma directamente es con nanochat.
Puertos, bifurcaciones y extensiones comunitarias
El README oficial destaca cuatro puertos: miolini/autoresearch-macos para macOS (2.349 estrellas, 336 bifurcaciones); trevin-creator/autoresearch-mlx, un puerto para Apple Silicon/MLX hallado en la búsqueda (1.775, 359); jsegov/autoresearch-win-rtx para Windows (703, 143); y andyluo7/autoresearch para AMD (68, 17).
La consulta de bifurcaciones también recuperó:
sanbuphy/autoresearch-cn, adaptación en chino para entrenar y ajustar un modelo de lenguaje con un agente en una GPU (190 estrellas, 18 bifurcaciones).mishig25/hf-autoresearch, bifurcación para infraestructura de Hugging Face (177, 17).eli-labz/ResearchSwarm, que se describe como enjambre autónomo para aproximadamente cien experimentos nocturnos y como bifurcación dekarpathy/autoresearch(359, 1).ncdrone/autoresearch-ANE, variante para Neural Engine de Apple (57, sin bifurcaciones en la respuesta recuperada).
La búsqueda global de GitHub muestra además herramientas que extienden el patrón en lugar de ser bifurcaciones del código base: davebcn87/pi-autoresearch (7.307 estrellas, 431 bifurcaciones) como extensión del bucle para Pi; uditgoenka/autoresearch (5.664, 429) como habilidad para Claude Code; leo-lilinxiao/codex-autoresearch (2.045, 117) como habilidad para Codex; RightNow-AI/autokernel (1.496, 155) para optimizar kernels Triton; y evo-hq/evo (1.358, 102) para convertir una base de código en un bucle de medida y búsqueda con subagentes. Sus descripciones proceden de la búsqueda de GitHub; no se infiere compatibilidad, patrocinio ni calidad más allá de lo que ellas declaran.
La expansión también ha producido catálogos, como webfuse-com/awesome-autoresearch (2.345, 176) y WecoAI/awesome-autoresearch (1.027, 75), lo que sirve como señal de ecosistema, no como una fuente oficial del proyecto.
Números del repo
Medición: 3 de agosto de 2026, API de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 92.838 |
| Bifurcaciones | 13.218 |
| Suscriptores reales | 721 |
| Commits | 36 |
| Incidencias abiertas indicadas por la API | 196 |
| Lenguaje principal | Python |
| Licencia | No indicada por la API |
| Creación | 6 de marzo de 2026 |
| Último envío de código | 26 de marzo de 2026 |
| Última actualización de metadatos | 3 de agosto de 2026 |
| Publicaciones de GitHub | Ninguna recuperada |
Los contribuidores principales que devolvió la API son karpathy con 28 contribuciones, seguido por nishantpurohit04, dipeshbabu, hughdbrown, marcinbogdanski, dumko2001, haosenwang1018, indianspeedster y kaizen-38, con una contribución cada uno en la lista recuperada. El total de 36 commits se obtuvo del enlace de última página de la paginación de la API.
Hay dos cautelas: watchers_count en la respuesta general replica el número de estrellas, por lo que se informa subscribers_count como el número de suscriptores reales. Además, open_issues_count puede incluir solicitudes de cambios abiertas, por lo que 196 no es necesariamente un conteo exclusivo de incidencias. Aunque updated_at coincide con la fecha de esta medición, el último envío de código que devuelve la API es del 26 de marzo de 2026; una actualización de metadatos no prueba actividad posterior en el código.
Cómo contribuir
No se recuperó un archivo de contribución ni una guía humana de ramas, pruebas o plantilla de solicitud de cambios. La API permite bifurcar el repositorio y admite solicitudes de cambios, y el README invita a crear bifurcaciones o discusiones para otras plataformas; eso describe una vía abierta, no un proceso de mantenimiento garantizado.
Para contribuir al experimento tal como está diseñado, program.md sí define el procedimiento del agente: rama nueva, edición exclusiva de train.py, confirmación de cada intento, registro no versionado en results.tsv y reversión de resultados no mejores. Quien proponga cambios al repositorio debe revisar por separado las discusiones y solicitudes de cambios actuales, ya que no se recuperó una política oficial de aceptación.
Cómo lo recibió la comunidad
La recepción recuperada combina curiosidad técnica, reutilización y críticas metodológicas concretas:
- En el hilo inicial 47291123, enviado por simonpure (208 puntos, 20 comentarios), mikert89 valoró los entornos donde un modelo aprende por prueba y error con verificación objetiva. En cambio, abeppu preguntó si las aparentes mejoras eran en realidad cambios de hiperparámetros y pidió compararlo con BayesOpt a igual número de ensayos de cinco minutos. gmerc objetó que confundir búsqueda de fuerza bruta con investigación convierte la métrica en un posible caso de la ley de Goodhart. elikoga señaló el riesgo de que el mejor
bpba cinco minutos favorezca modelos demasiado pequeños para ciertos comportamientos emergentes.
- El análisis de escalado de SkyPilot fue discutido en 47442435, enviado por hopechong (237 puntos, 17 comentarios recuperados; la búsqueda de historias informaba 94 comentarios). zhwu destacó que el agente, sin recibir esa instrucción, usó H100 para filtrar ideas y H200 para validar candidatas. La objeción de augment_me fue que la comparación privilegiaba tiempo de pared: a igualdad de horas de GPU, la ejecución secuencial parecía aproximadamente dos veces más eficiente. herf cuestionó que seleccionar por progreso temprano en cinco minutos pueda perjudicar el resultado asintótico. Estas son opiniones de los participantes, no resultados de una evaluación independiente.
- La difusión práctica también es visible en 47343935: austinbaggio presentó Autoresearch@home y recibió 79 puntos y 19 comentarios. Es evidencia de derivación posterior, no una prueba de que el repositorio base supere a otros optimizadores.
autoresearch frente a otras propuestas
| Propuesta | Coincidencia verificable | Diferencia verificable |
|---|---|---|
karpathy/nanochat | Ambos pertenecen a Karpathy y el README confirma que autoresearch simplifica su entrenamiento. | nanochat es el proyecto de entrenamiento padre; autoresearch añade el protocolo de agente, el archivo de instrucciones y la regla conservar/revertir. |
davebcn87/pi-autoresearch | La búsqueda lo describe como una extensión autónoma del bucle de experimentos. | Está orientado a Pi; no es el entorno de entrenamiento de una sola GPU que documenta el repositorio original. |
RightNow-AI/autokernel | La búsqueda lo describe como aplicación del patrón a iteraciones automáticas con un objetivo medible. | Optimiza kernels Triton de modelos PyTorch, mientras el original modifica el modelo y bucle de entrenamiento GPT. |
evo-hq/evo | Ambos usan cambios, una medida y repetición para mejorar código. | Evo declara instrumentación de la base de código y búsqueda en árbol con subagentes; autoresearch fija un único agente, un archivo editable y una trayectoria lineal de conservar o revertir. |
La comparación central no es entre asistentes conversacionales, sino entre mecanismos de búsqueda. autoresearch aporta restricciones explícitas para que una exploración de lenguaje natural sea auditable en una métrica local; no demuestra por sí mismo que sea más eficiente que BayesOpt, búsqueda aleatoria u otros métodos de optimización. Esa comparación fue precisamente una crítica explícita de la comunidad.
Casos de uso y a quién puede ayudar este repositorio
- Investigadores y personas de ingeniería de modelos con una GPU NVIDIA pueden convertir una noche de cómputo en una secuencia de pruebas sobre arquitectura, optimizador, tamaño de lote o hiperparámetros, siempre que acepten como objetivo local
val_bpbbajo cinco minutos. - Equipos que quieren prototipar un arnés de agente verificable pueden estudiar la división entre
program.md, la superficie editabletrain.py, la evaluación bloqueada enprepare.pyy el registroresults.tsv. Es una plantilla concreta para evitar que el agente cambie a la vez el experimento y el medidor. - Usuarios de macOS, Windows, AMD o Apple Silicon pueden partir de los puertos que el README o la búsqueda de bifurcaciones identifican, pero deben tratar sus métricas como específicas de su máquina y revisar el código del derivado antes de adoptarlo.
- Quienes optimizan otros dominios cuantificables pueden tomar el patrón conservar/revertir como inspiración, como hacen las extensiones para Codex, kernels o bases de código. Necesitan definir antes una métrica resistente a manipulación y comprobaciones independientes: la crítica comunitaria muestra que un único marcador temprano puede incentivar mejoras estrechas o engañosas.
Recursos
- Repositorio: https://github.com/karpathy/autoresearch
- Documentación e instalación: https://github.com/karpathy/autoresearch#quick-start
- Skills oficiales: no se recuperó un catálogo separado;
program.mdes la instrucción oficial para el agente: https://github.com/karpathy/autoresearch/blob/master/program.md - Proyecto técnico de origen: https://github.com/karpathy/nanochat
- Reviews y conversaciones: https://news.ycombinator.com/item?id=47291123, https://news.ycombinator.com/item?id=47442435
- Comunidad y bifurcaciones: https://github.com/karpathy/autoresearch/network/members
Nota: este artículo combina el README, program.md y código fuente recuperados de karpathy/autoresearch, la API de GitHub, las búsquedas de repositorios y Hacker News consultados el 3 de agosto de 2026. Las cifras cambian con el tiempo.
Comentarios