

autoresearch: ein nächtliches Labor, in dem ein Agent an einem Modell iteriert
karpathy/autoresearch · 96.768★ · 13.524 forks
Alles Wissenswerte über karpathy/autoresearch: ein minimales Experiment zum Trainieren von Sprachmodellen, bei dem ein Agent eine einzige Datei ändert, das Ergebnis misst und jeden Versuch behält oder verwirft.
Was autoresearch ist
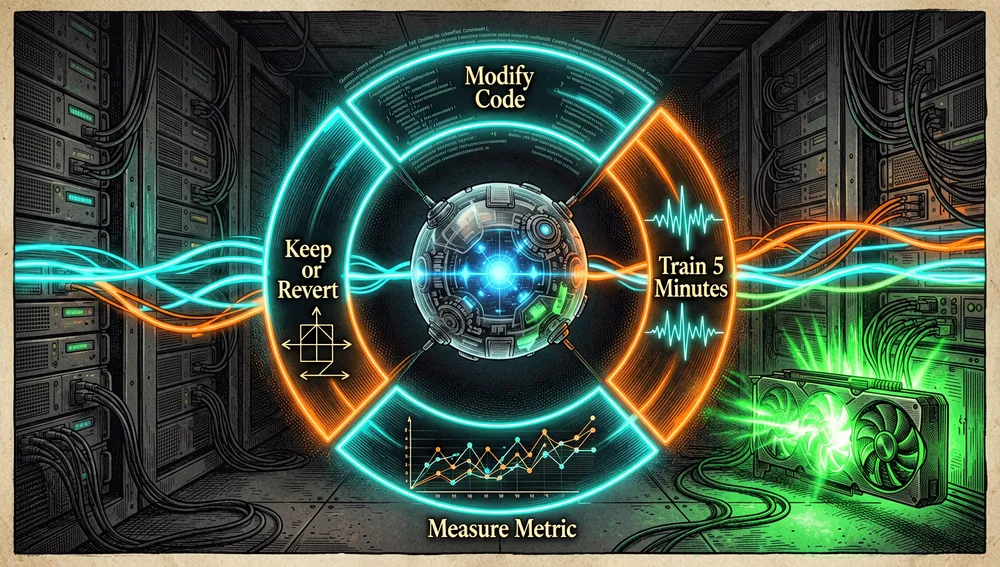
autoresearch ist ein Repository von Andrej Karpathy, das einem KI-Agenten erlaubt, stundenlang Trainingsexperimente für ein Sprachmodell durchzuführen. Die offizielle Beschreibung fasst es als automatisierte Forschung zum Training von nanochat auf einer einzelnen GPU zusammen; das README konkretisiert den Zyklus: Code ändern, fünf Minuten trainieren, messen, behalten oder verwerfen und wiederholen.
Es versucht weder, ein allgemeines AutoML-System noch ein verteiltes Laborprodukt zu sein. Es ist eine bewusste Reduktion des Problems auf eine kleine, messbare Umgebung: eine NVIDIA-GPU, ein GPT-Modell, eine Metrik (val_bpb, Validierungs-Bits pro Byte; je niedriger, desto besser) und eine kontrollierte Änderungsoberfläche.
Der Ursprung: eine Schwarm-Fiktion und ein minimaler Prototyp
GitHub verzeichnet die Erstellung von karpathy/autoresearch am 6. März 2026. Sein Autor ist Andrej Karpathy (karpathy), dessen GitHub-Konto ihn als jemanden beschreibt, der sich für das Training tiefer neuronaler Netze mit großen Datensätzen interessiert und sein Profil in Stanford verortet. Das README ist narrativ auf März 2026 datiert: Es beginnt mit der Vorstellung einer Zukunft autonomer Agentenschwärme, die Code jenseits menschlichen Verständnisses verändern, und präsentiert dieses Repository als den Anfang dieser Geschichte.
Das Projekt entsteht als Vereinfachung von karpathy/nanochat: Das README erklärt ausdrücklich, dass der Trainingscode eine reduzierte Version jenes Repositorys ist. Die Spannung, die es zu lösen versucht, ist kein Mangel eines konkreten Agenten, sondern die Kosten manueller iterativer Forschung: Der Mensch hört auf, in jeder Runde Python-Dateien zu bearbeiten, und entwirft stattdessen program.md, das Dokument, das dem Agenten Kontext und Betriebsanweisungen gibt.
Der erste Hacker-News-Beitrag, 47291123, verlinkte das Repository und erreichte 208 Punkte und 20 Kommentare. Dort zeigte sich bereits die Diskussion, die den Launch begleiten sollte: ob dies agentengesteuerte Forschung darstellt oder eine Form der Hyperparameter-Anpassung, verpackt in eine Schleife aus natürlicher Sprache.
Philosophie und Prinzipien
Das dokumentierte Design stützt sich auf sehr konkrete Prinzipien:
- Eine einzige Erfolgsvariable.
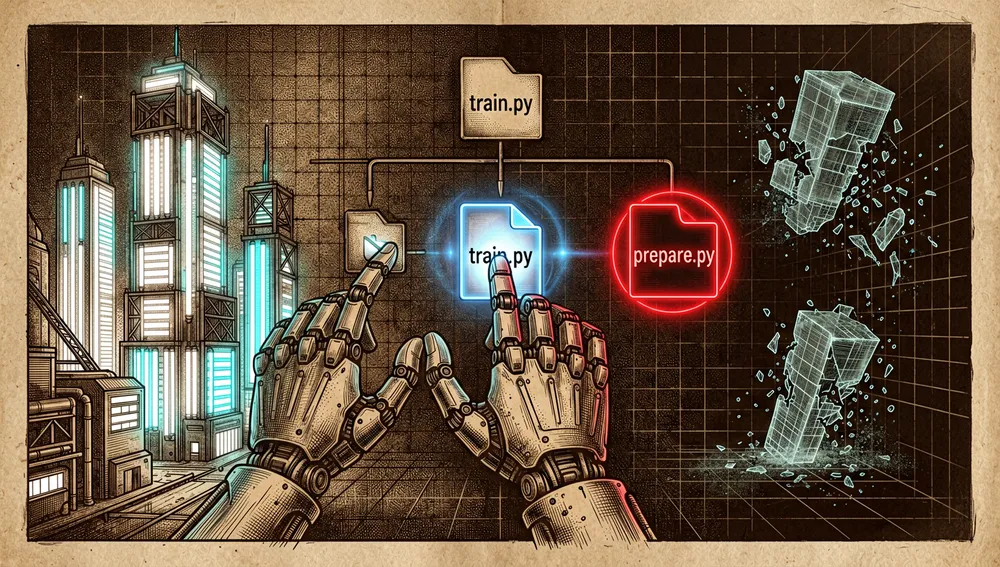
val_bpbist die maßgebliche Quelle der Wahrheit und wird unter einem festen Fünf-Minuten-Budget verglichen; das README argumentiert, dass sie nicht von der Vokabulargröße abhängt und den Vergleich architektonischer Änderungen erleichtert. - Änderungen mit engem Geltungsbereich. Der Agent ändert nur
train.py;prepare.py, das Vorbereitung, Datenladen, Evaluation und Konstanten enthält, bleibt unangetastet. - Vergleichbarkeit auf derselben Maschine, nicht zwischen Maschinen. Jeder Durchlauf verbraucht dieselbe Trainingszeit, aber die Ergebnisse sind für die jeweilige Plattform optimiert und nicht direkt mit denen einer anderen GPU vergleichbar.
- Belege bewahren, den Rest zurücksetzen. Jeder Versuch wird mit einem Git-Commit und in
results.tsvfestgehalten; ein schlechteres oder gleiches Ergebnis setzt den Branch auf den vorherigen Zustand zurück. - Einfachheit als zusätzliches Kriterium.
program.mdverlangt, die Komplexität abzuwägen: Eine kleine Verbesserung, die brüchigen Code hinzufügt, muss es nicht wert sein, behalten zu werden, während eine Vereinfachung ohne Verschlechterung der Metrik durchaus als Fortschritt zählt.
Das macht das Repository zu einem Beispiel für begrenzte empirische Optimierung, nicht zu einem Beweis dafür, dass der Agent von sich aus verallgemeinerbares wissenschaftliches Wissen erzeugt.
Wie es funktioniert
Der Hauptablauf besteht aus drei Teilen:
| Datei | Dokumentierte Rolle |
|---|---|
prepare.py | Lädt Daten herunter, trainiert den BPE-Tokenizer und stellt Datenladen sowie Evaluation bereit; für den Agenten nur lesbar. |
train.py | Enthält das GPT-Modell, den Muon + AdamW-Optimierer und die Trainingsschleife; die einzige Datei, die der Agent ändern darf. |
program.md | Anweisungen für den Agenten; die Datei, die der Mensch bearbeitet, um die Forschungsorganisation festzulegen. |
Der dokumentierte manuelle Start ist uv sync, uv run prepare.py und uv run train.py. Erforderlich sind Python 3.10 oder neuer, uv und eine NVIDIA-GPU; das README gibt Tests auf einer H100 an. Danach lässt sich Claude, Codex oder ein anderer Agent unberechtigt im Repository starten und bitten, program.md zu lesen und ein Experiment vorzubereiten.
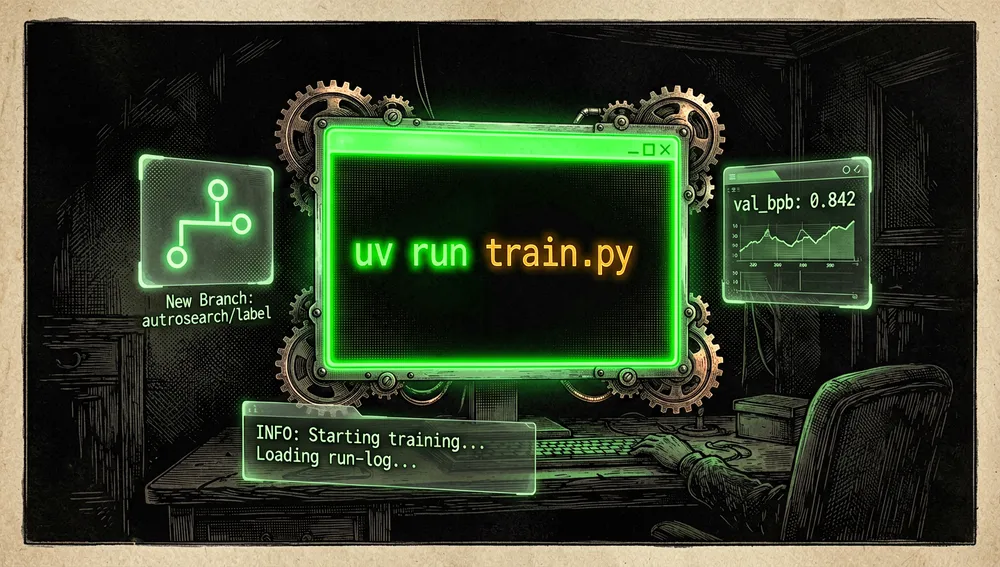
program.md schreibt ein genaues Protokoll vor: einen Branch autoresearch/<label> erstellen, den Cache prüfen, results.tsv initialisieren, zuerst die Baseline ausführen und danach wiederholen: bearbeiten → committen → uv run train.py > run.log 2>&1 → val_bpb und VRAM extrahieren → protokollieren → behalten oder zurücksetzen. Ein Durchlauf, der zehn Minuten überschreitet, gilt als Fehlschlag. Scheitert eine Änderung an fehlendem Speicher oder einem Codefehler, wird sie als crash vermerkt; das Dokument verlangt, autonom fortzufahren, bis eine Person eingreift.
Das abgerufene train.py bestätigt eine PyTorch-GPT-Implementierung für eine einzelne GPU, mit Flash Attention 3 und einer Kernel-Repository-Auswahl je nach CUDA-Fähigkeit. Das ist keine Portabilitätsaussage: Das README erklärt, dass der Code in seiner Hauptform eine NVIDIA-GPU voraussetzt und es vorzieht, den Kern nicht um CPU- oder MPS-Unterstützung zu erweitern.
Offizieller und halboffizieller Status
Es wurde kein Beleg dafür gefunden, dass autoresearch in einen offiziellen Anbietermarktplatz aufgenommen wurde oder eine formale Zertifizierung oder Unterstützung von Anthropic, OpenAI, NVIDIA oder einem anderen Unternehmen erhalten hat. Das README nennt zwar Claude und Codex als mögliche Agenten, die das Protokoll ausführen können, doch das beschreibt Nutzungskompatibilität, keine offizielle Integration.
Sein praktischer Status ist der einer De-facto-Referenz für ein Muster: Die GitHub-Suche förderte zahlreiche Erweiterungen zutage, die sich ausdrücklich als von Karpathy inspiriert beschreiben, und das Repository dokumentiert nennenswerte Ports. Diese Verbreitung entspricht keiner formalen Standardisierung und bestätigt nicht die Qualität der von jedem Derivat erzeugten Ergebnisse.
Das Ökosystem
Verwandte Repositories des Autors
karpathy/nanochatist laut README das technische Elternrepository;autoresearchvereinfacht dessen Training. Die GitHub-API zeigte es mit 56.896 Sternen und 7.876 Forks.karpathy/nanoGPT, von seinem Autor als einfaches, schnelles Repository zum Trainieren oder Feinabstimmen mittelgroßer GPT-Modelle beschrieben, hatte 61.807 Sterne und 10.638 Forks.karpathy/llm.c, Sprachmodelltraining in C/CUDA, hatte 30.711 Sterne und 3.716 Forks.
Das sind Projekte desselben Autors, keine für die Ausführung von autoresearch erforderlichen Komponenten; die narrative und technische Abhängigkeit, die das README direkt bestätigt, besteht mit nanochat.
Ports, Forks und Community-Erweiterungen
Das offizielle README hebt vier Ports hervor: miolini/autoresearch-macos für macOS (2.349 Sterne, 336 Forks); trevin-creator/autoresearch-mlx, ein in der Suche gefundener Port für Apple Silicon/MLX (1.775, 359); jsegov/autoresearch-win-rtx für Windows (703, 143); und andyluo7/autoresearch für AMD (68, 17).
Die Fork-Abfrage förderte außerdem zutage:
sanbuphy/autoresearch-cn, eine chinesischsprachige Anpassung zum Trainieren und Feinabstimmen eines Sprachmodells mit einem Agenten auf einer GPU (190 Sterne, 18 Forks).mishig25/hf-autoresearch, ein Fork für Hugging-Face-Infrastruktur (177, 17).eli-labz/ResearchSwarm, beschrieben als autonomer Schwarm für rund hundert nächtliche Experimente und als Fork vonkarpathy/autoresearch(359, 1).ncdrone/autoresearch-ANE, eine Variante für Apples Neural Engine (57, keine Forks in der abgerufenen Antwort).
Die globale GitHub-Suche zeigt außerdem Werkzeuge, die das Muster erweitern, statt den Basis-Code zu forken: davebcn87/pi-autoresearch (7.307 Sterne, 431 Forks) als Erweiterung der Schleife für Pi; uditgoenka/autoresearch (5.664, 429) als Skill für Claude Code; leo-lilinxiao/codex-autoresearch (2.045, 117) als Skill für Codex; RightNow-AI/autokernel (1.496, 155) zur Optimierung von Triton-Kerneln; und evo-hq/evo (1.358, 102), um eine Codebasis in eine Mess- und Suchschleife mit Subagenten zu verwandeln. Ihre Beschreibungen stammen aus der GitHub-Suche; es wird keine Kompatibilität, Förderung oder Qualität abgeleitet, die über das hinausgeht, was sie selbst angeben.
Die Ausbreitung hat außerdem Kataloge hervorgebracht, wie webfuse-com/awesome-autoresearch (2.345, 176) und WecoAI/awesome-autoresearch (1.027, 75), die als Ökosystemsignal dienen, nicht als offizielle Projektquelle.
Zahlen zum Repository
Messung: 3. August 2026, GitHub-API.
| Metrik | Wert |
|---|---|
| Sterne | 92.838 |
| Forks | 13.218 |
| Reale Abonnenten | 721 |
| Commits | 36 |
| Von der API angegebene offene Issues | 196 |
| Hauptsprache | Python |
| Lizenz | Von der API nicht angegeben |
| Erstellung | 6. März 2026 |
| Letzter Code-Push | 26. März 2026 |
| Letzte Metadaten-Aktualisierung | 3. August 2026 |
| GitHub-Veröffentlichungen | Keine abgerufen |
Die von der API zurückgegebenen Hauptbeitragenden sind karpathy mit 28 Beiträgen, gefolgt von nishantpurohit04, dipeshbabu, hughdbrown, marcinbogdanski, dumko2001, haosenwang1018, indianspeedster und kaizen-38, jeweils mit einem Beitrag in der abgerufenen Liste. Die Gesamtzahl von 36 Commits stammt aus dem letzten Seitenlink der API-Paginierung.
Zwei Vorbehalte gelten: watchers_count spiegelt in der allgemeinen Antwort die Sternezahl wider, weshalb hier subscribers_count als tatsächliche Abonnentenzahl angegeben wird. Zudem kann open_issues_count offene Pull Requests einschließen, sodass 196 nicht zwangsläufig ausschließlich Issues zählt. Obwohl updated_at mit dem Datum dieser Messung übereinstimmt, stammt der letzte von der API zurückgegebene Code-Push vom 26. März 2026; eine Metadaten-Aktualisierung belegt keine spätere Code-Aktivität.
Wie man beiträgt
Es wurde weder eine Beitragsdatei noch ein menschlicher Leitfaden zu Branches, Tests oder einer Pull-Request-Vorlage gefunden. Die API erlaubt das Forken des Repositorys und akzeptiert Pull Requests, und das README lädt dazu ein, Forks oder Diskussionen für andere Plattformen anzulegen; das beschreibt einen offenen Weg, keinen garantierten Pflegeprozess.
Um zum Experiment beizutragen, wie es konzipiert ist, definiert program.md sehr wohl das Vorgehen des Agenten: ein neuer Branch, ausschließliche Bearbeitung von train.py, ein Commit für jeden Versuch, ein nicht versioniertes Protokoll in results.tsv und das Zurücksetzen nicht besserer Ergebnisse. Wer Änderungen am Repository vorschlagen möchte, sollte separat die aktuellen Diskussionen und Pull Requests prüfen, da keine offizielle Annahmerichtlinie gefunden wurde.
Wie die Community reagierte
Die abgerufene Resonanz vereint technische Neugier, Wiederverwendung und konkrete methodische Kritik:
- Im ursprünglichen Thread 47291123, eingereicht von simonpure (208 Punkte, 20 Kommentare), lobte mikert89 Umgebungen, in denen ein Modell durch Versuch und Irrtum mit objektiver Verifikation lernt. abeppu hingegen fragte, ob die scheinbaren Verbesserungen in Wirklichkeit Änderungen von Hyperparametern seien, und forderte einen Vergleich mit BayesOpt bei derselben Anzahl von Fünf-Minuten-Versuchen. gmerc wandte ein, dass die Verwechslung von Brute-Force-Suche mit Forschung die Metrik zu einem möglichen Fall des Goodhart’schen Gesetzes mache. elikoga wies auf das Risiko hin, dass der beste
bpb-Wert nach fünf Minuten Modelle begünstigen könnte, die für bestimmte emergente Verhaltensweisen zu klein sind.
- SkyPilots Skalierungsanalyse wurde in 47442435 diskutiert, eingereicht von hopechong (237 Punkte, 17 abgerufene Kommentare; die Story-Suche meldete 94 Kommentare). zhwu hob hervor, dass der Agent, ohne dazu angewiesen worden zu sein, H100 zum Filtern von Ideen und H200 zur Validierung von Kandidaten nutzte. Der Einwand von augment_me war, dass der Vergleich die Gesamtzeit bevorzugte: Bei gleicher GPU-Stundenzahl erschien die sequenzielle Ausführung etwa doppelt so effizient. herf hinterfragte, ob eine Auswahl nach frühem Fortschritt binnen fünf Minuten das asymptotische Ergebnis beeinträchtigen könnte. Das sind Meinungen der Teilnehmenden, keine Ergebnisse einer unabhängigen Bewertung.
- Die praktische Verbreitung zeigt sich auch in 47343935: austinbaggio stellte Autoresearch@home vor und erhielt 79 Punkte und 19 Kommentare. Das ist ein Beleg für spätere Ableitungen, kein Beweis dafür, dass das Basis-Repository andere Optimierer übertrifft.
autoresearch im Vergleich zu anderen Ansätzen
| Ansatz | Überprüfbare Übereinstimmung | Überprüfbarer Unterschied |
|---|---|---|
karpathy/nanochat | Beide gehören Karpathy, und das README bestätigt, dass autoresearch dessen Training vereinfacht. | nanochat ist das übergeordnete Trainingsprojekt; autoresearch fügt das Agentenprotokoll, die Anweisungsdatei und die Behalten/Zurücksetzen-Regel hinzu. |
davebcn87/pi-autoresearch | Die Suche beschreibt es als autonome Erweiterung der Experimentschleife. | Es ist auf Pi ausgerichtet; es ist nicht die Einzel-GPU-Trainingsumgebung, die das Original-Repository dokumentiert. |
RightNow-AI/autokernel | Die Suche beschreibt es als Anwendung des Musters auf automatische Iterationen mit einem messbaren Ziel. | Es optimiert Triton-Kernel von PyTorch-Modellen, während das Original das Modell und die Trainingsschleife selbst verändert. |
evo-hq/evo | Beide nutzen Änderung, Messung und Wiederholung, um Code zu verbessern. | Evo gibt Codebasis-Instrumentierung und Baumsuche mit Subagenten an; autoresearch legt einen einzigen Agenten, eine editierbare Datei und einen linearen Behalten-oder-Zurücksetzen-Pfad fest. |
Der zentrale Vergleich findet nicht zwischen Konversationsassistenten statt, sondern zwischen Suchmechanismen. autoresearch bringt explizite Beschränkungen mit, damit eine Exploration in natürlicher Sprache anhand einer lokalen Metrik überprüfbar wird; es zeigt nicht von sich aus, dass es effizienter ist als BayesOpt, Zufallssuche oder andere Optimierungsmethoden. Genau dieser Vergleich war eine explizite Kritik der Community.
Anwendungsfälle und wem dieses Repository helfen kann
- Forschende und Modell-Engineering-Personen mit einer NVIDIA-GPU können eine Nacht Rechenzeit in eine Abfolge von Tests zu Architektur, Optimierer, Batchgröße oder Hyperparametern verwandeln, sofern sie
val_bpbunter fünf Minuten als lokales Ziel akzeptieren. - Teams, die einen überprüfbaren Agenten-Harness prototypisieren möchten, können die Aufteilung zwischen
program.md, der editierbaren Oberflächetrain.py, der gesperrten Evaluation inprepare.pyund dem Protokollresults.tsvuntersuchen. Das ist eine konkrete Vorlage, um zu verhindern, dass der Agent gleichzeitig Experiment und Messgerät verändert. - Nutzende von macOS, Windows, AMD oder Apple Silicon können von den Ports ausgehen, die das README oder die Fork-Suche identifizieren, sollten aber deren Metriken als maschinenspezifisch behandeln und den Code des Derivats vor der Übernahme prüfen.
- Wer andere quantifizierbare Bereiche optimiert, kann das Behalten/Zurücksetzen-Muster als Inspiration übernehmen, wie es die Erweiterungen für Codex, Kernel oder Codebasen tun. Zuvor muss eine manipulationsresistente Metrik samt unabhängiger Prüfungen definiert werden: Die Kritik der Community zeigt, dass ein einzelner früher Marker enge oder irreführende Verbesserungen begünstigen kann.
Ressourcen
- Repository: https://github.com/karpathy/autoresearch
- Dokumentation und Installation: https://github.com/karpathy/autoresearch#quick-start
- Offizielle Skills: Es wurde kein separater Katalog gefunden;
program.mdist die offizielle Anweisung für den Agenten: https://github.com/karpathy/autoresearch/blob/master/program.md - Technisches Ursprungsprojekt: https://github.com/karpathy/nanochat
- Rezensionen und Gespräche: https://news.ycombinator.com/item?id=47291123, https://news.ycombinator.com/item?id=47442435
- Community und Forks: https://github.com/karpathy/autoresearch/network/members
Hinweis: Dieser Artikel kombiniert das README, program.md und den Quellcode von karpathy/autoresearch, die GitHub-API, Repository-Suchen und Hacker News, abgerufen am 3. August 2026. Die Zahlen ändern sich mit der Zeit.
Kommentare