

DeepTutor: un espacio de aprendizaje personalizado orientado a agentes
HKUDS/DeepTutor · 40.284★ · 5.073 forks
Todo lo que hay que saber sobre HKUDS/DeepTutor: una aplicación de código abierto que reúne tutoría, práctica, investigación, recuperación documental y memoria del estudiante en un mismo espacio de trabajo.
Qué es DeepTutor
DeepTutor es un espacio de aprendizaje personalizado orientado a agentes. Su README lo presenta como un sistema extensible para tutoría, resolución de problemas, generación de cuestionarios, investigación, visualización y práctica de dominio. Es una aplicación, no solo una biblioteca de recuperación documental: incluye interfaz web, interfaz de línea de comandos, bases de conocimiento, herramientas y áreas de trabajo de aprendizaje.
El diseño mantiene un mismo bucle de agente para los modos de conversación, cuestionario, investigación, visualización, resolución y ruta de dominio. Los materiales y el contexto —bibliotecas, libros, borradores, cuadernos, bancos de preguntas, perfiles y memoria— pueden trasladarse entre esos modos. La propuesta central es personalizar el siguiente paso de aprendizaje sin separar cada actividad en una aplicación distinta.
El origen: de un lanzamiento comunitario a un informe técnico
El repositorio se creó el 28 de diciembre de 2025 y el README sitúa el lanzamiento oficial el 29 de diciembre de 2025. El proyecto está liderado en código abierto por Bingxi Zhao dentro del grupo HKUDS; el propio README agradece, entre otras personas, a Chao Huang, director del Data Intelligence Lab de HKU, y a Jiahao Zhang, Zirui Guo y Xubin Ren.
El contexto técnico se formalizó después en el informe de arXiv “DeepTutor: Towards Agentic Personalized Tutoring”, enviado el 10 de abril de 2026 por Bingxi Zhao, Jiahao Zhang, Xubin Ren, Zirui Guo, Tianzhe Chu, Yi Ma y Chao Huang. El artículo plantea una tensión concreta: los modelos de lenguaje parten de conocimiento estático y los sistemas convencionales de recuperación no bastan para ofrecer retroalimentación guiada y adaptada a cada estudiante. DeepTutor propone combinar conocimiento fundamentado en fuentes con memoria dinámica del alumno.
La narrativa pública del proyecto es deliberadamente comunitaria: el README afirma que no ofrece productos en línea de pago y que las incidencias, solicitudes de cambios y discusiones moldean el producto. También registra dos hitos de adopción: 10.000 estrellas en 39 días y 20.000 en 111 días; son anuncios del propio proyecto, no una auditoría independiente.
Filosofía y principios
La filosofía verificable se apoya en cuatro decisiones de producto:
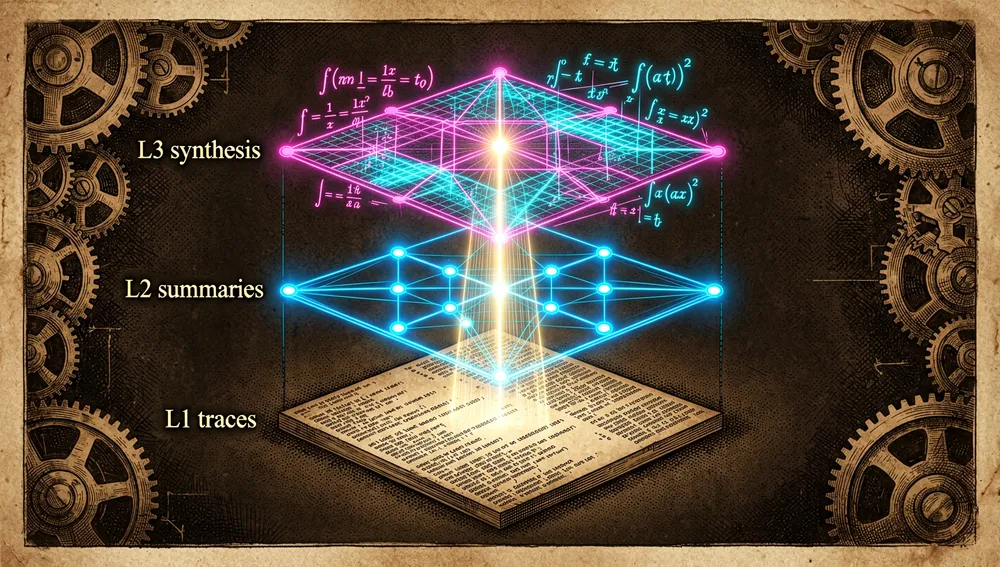
- Personalización visible: la memoria se divide en trazas L1, resúmenes L2 y síntesis L3; el README dice que el grafo de memoria permite remontar una afirmación a su evidencia y editarla.
- Un contexto conectado: libros, notas, bibliotecas, cuestionarios y perfiles no se tratan como silos por modo de aprendizaje.
- Conocimiento intercambiable: la capa de recuperación admite LlamaIndex, PageIndex, GraphRAG, LightRAG o una bóveda de Obsidian enlazada, en lugar de fijarse a un solo motor.
- Extensibilidad antes que un catálogo cerrado: los recursos de aprendizaje usan el formato abierto Agent Skills, basado en una carpeta con
SKILL.md, metadatos YAML y archivos de referencia opcionales.
El artículo acompaña esta filosofía con TutorBench, un banco interactivo con perfiles de alumnado y planes universitarios de cinco dominios. Sus mejoras medias de 10,8 % en métricas personalizadas y 29,4 % en razonamiento de agentes son resultados declarados por los autores en un informe técnico en curso; no se deben interpretar como una validación externa independiente.
Cómo funciona
El flujo de uso documentado es elegir un directorio de trabajo, instalar, ejecutar deeptutor init y arrancar con deeptutor start. Hay cuatro rutas de instalación: PyPI para la aplicación web local y la interfaz de línea de comandos, instalación desde el código fuente, contenedor Docker y distribución solo de línea de comandos. La configuración se guarda bajo data/user/settings/, o en la ruta indicada por DEEPTUTOR_HOME o deeptutor start --home.
La interfaz ofrece conversación, compañeros persistentes, agentes importables, edición cooperativa de Markdown, libros vivos, centro de conocimiento, espacio de aprendizaje, memoria y ajustes.
La interfaz de línea de comandos proporciona tanto una sesión interactiva como salida JSON estructurada para que otro agente pueda dirigir DeepTutor con las mismas capacidades, herramientas y bases de conocimiento.
En el interior, la capa de conocimiento usa bibliotecas versionadas de recuperación y análisis documental conectables. El README también documenta servidores MCP, aplicaciones de línea de comandos, modelos de imagen, vídeo y voz, y un entorno aislado para ejecutar código generado para documentos de oficina. La versión v1.5.9, publicada el 4 de agosto de 2026, añadió Gemini Embedding 2 mediante su extremo nativo, control de esfuerzo de razonamiento por modelo, una pasarela Novita AI, roles de recuperación para consultas y despliegues Compose que conservan data/.
Estado oficial y semioficial
No se recuperó evidencia de que DeepTutor haya sido aceptado en un mercado oficial de un proveedor de modelos ni de una certificación o aval de una empresa. Por tanto, no debe describirse como producto oficial de OpenAI, Anthropic, Google, GitHub ni de HKU.
Su condición semioficial, en el sentido técnico y no comercial, procede de dos integraciones que el README declara: incluye EduHub, el registro educativo predeterminado del proyecto, y es compatible con ClawHub y con el formato abierto Agent Skills. Esto permite importar habilidades de registros que hablen el mismo formato, pero no equivale a una aprobación de esos registros ni a un estándar formal. La adopción de 32.408 estrellas muestra interés de la comunidad, no una designación de estándar de facto respaldada por un proveedor.
El ecosistema
Proyectos relacionados de HKUDS
El README identifica varios proyectos de HKUDS como piezas técnicas o inspiración. Las cifras siguientes proceden de la consulta a la API de GitHub del 4 de agosto de 2026:
HKUDS/LightRAG— 38.507 estrellas; aparece como una de las opciones de recuperación y como inspiración de recuperación simple y rápida.HKUDS/AutoAgent— 9.682 estrellas; el README lo cita como marco de agentes sin código.HKUDS/AI-Researcher— 5.646 estrellas; citado como canal de investigación automatizada.HKUDS/nanobot— 46.618 estrellas; el README señala que su motor ligero impulsó el TutorBot original de HKUDS.HKUDS/RAG-Anything— 22.632 estrellas; proyecto del mismo grupo cuya descripción en GitHub lo presenta como marco integral de recuperación.HKUDS/OpenSpace— 7.274 estrellas; su descripción lo presenta como capa de gestión de habilidades para agentes.
No se recuperó un repositorio público independiente de EduHub en la consulta de la organización; la fuente oficial lo documenta como registro integrado de DeepTutor, no como un repositorio separado que pueda atribuirse con seguridad.
Bifurcaciones, guías y extensiones de la comunidad
La API de bifurcaciones devuelve 4.233 bifurcaciones en total. Entre las de más estrellas recuperadas están 0xSojalSec/AI-Tutor (27), hacksider/DeepTutor (12), oalanicolas/deeptutor (12) y cloudtoolbox/deeptutor (7). Sus descripciones reproducen esencialmente la propuesta de DeepTutor, de modo que se clasifican como bifurcaciones y no como puertos técnicamente diferenciados.
Sí se recuperaron materiales comunitarios en chino fuera de la relación de bifurcación principal: chencore/deeptutor-guide y chencore/deeptutor-complete-guide. Sus descripciones se presentan como guías completas de instalación y uso de DeepTutor en chino y la búsqueda de GitHub devolvía 0 estrellas para cada una en esta medición. Son traducciones o documentación comunitaria, no repositorios oficiales de HKUDS.
El README menciona además LlamaIndex, PageIndex, GraphRAG, Obsidian, OpenClaw, Codex, Claude Code y ManimCat como dependencias conceptuales, herramientas o inspiración. Esa mención no demuestra que todos sean módulos incluidos, patrocinadores o extensiones mantenidas por DeepTutor.
Números del repo
Medición: 4 de agosto de 2026, API y página de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 32.408 |
| Bifurcaciones | 4.233 |
| Suscriptores reales | 169 |
| Commits | 1.186 |
| Incidencias abiertas indicadas por la API | 88 |
| Incidencias visibles en la página | 52 |
| Solicitudes de cambios abiertas visibles en la página | 36 |
| Lenguaje principal | Python |
| Licencia | Apache-2.0 |
| Creación | 28 de diciembre de 2025 |
| Última actualización de metadatos | 4 de agosto de 2026, 23:53 UTC |
| Última publicación | v1.5.9, 4 de agosto de 2026 |
Los principales contribuidores devueltos por la API fueron pancacake (562 contribuciones), Pinkllow (116), github-actions[bot] (108), tusharkhatriofficial (20), scrrlt (16) y wedone (16). El total de 1.186 commits procede de la página del repositorio. watchers_count en la respuesta general de GitHub repite las 32.408 estrellas; por eso se informa subscribers_count como suscriptores reales. El campo open_issues_count de la API puede incluir solicitudes de cambios abiertas, lo que explica que no coincida necesariamente con las 52 incidencias visibles por separado.
Cómo contribuir
El repositorio proporciona CONTRIBUTING.md y una hoja de ruta en la que se pueden votar o proponer elementos. El README remite explícitamente a esa guía para la estrategia de ramas, normas de código y pasos iniciales. La plantilla de solicitudes de cambios pide describir los cambios, enlazar incidencias relacionadas, identificar módulos afectados y confirmar que se siguieron las normas.
Hay señales de colaboración activa: la solicitud de cambios #13, de kushalgarg101, añadió soporte Docker y cerró la petición #3 de lovingfish, que solicitaba un despliegue Compose mantenido y reproducible. La guía y las plantillas son el proceso documentado; no se infiere de ello que toda propuesta vaya a ser aceptada.
Cómo lo recibió la comunidad
La recepción verificable combina una adopción fuerte en GitHub con problemas prácticos reportados por usuarios. No se encontró una discusión amplia directamente sobre HKUDS/DeepTutor en Hacker News: el envío 47703911, publicado por wslh el 9 de abril de 2026, obtuvo 2 puntos y 0 comentarios. Acredita descubrimiento del repositorio, pero no permite deducir elogio, crítica ni consenso.
- Reconocimiento concreto: en la incidencia #351, con 10 comentarios,
StarNight2021agradeció explícitamente ajiakebogeypancacakepor la solicitud #319, afirmando que sus cambios eliminaron la congelación grave en conversaciones largas. La misma incidencia matiza el elogio: todavía observaba demora de entrada al escribir rápidamente, por lo que no es una evaluación global del producto. - Crítica de rendimiento: en la incidencia #137, con 9 comentarios,
yepyhuninformó que la imagen Docker basada solo en CPU hacía extremadamente lento el procesamiento PDF de MinerU; aportó como ejemplo unos 40 segundos por página en una RTX 3070 Ti cuando se usaba inferencia de CPU. Es una experiencia y una configuración reportadas por ese usuario, no una medición comparativa universal. - Crítica de compatibilidad: en la incidencia cerrada #15, con 17 comentarios,
tusharkhatriofficialdescribió un fallo del Smart Solver cuando un modelo generaba cadenas Python multilínea no válidas dentro de JSON. El informe identifica una limitación de la integración con salidas de modelos, no una objeción a la finalidad educativa de DeepTutor.
- Demanda de despliegue: la petición #3, con 12 comentarios, pidió imágenes precompiladas y Compose oficial para no tener que instalar dependencias Python y Node en la máquina anfitriona. Su cierre mediante #13 muestra respuesta de mantenimiento a una necesidad de la comunidad, pero no mide satisfacción posterior.
DeepTutor frente a otras propuestas
| Propuesta | Coincidencia verificable | Diferencia verificable |
|---|---|---|
HKUDS/LightRAG | DeepTutor puede elegir LightRAG como motor de recuperación. | LightRAG se presenta como recuperación aumentada; DeepTutor añade superficies de tutoría, memoria, cuestionarios y un espacio de trabajo de aprendizaje. |
| LlamaIndex | DeepTutor documenta LlamaIndex como una opción para sus bibliotecas de conocimiento. | En DeepTutor es un componente intercambiable de recuperación; el README no presenta LlamaIndex como sustituto de sus modos de tutoría y memoria. |
| GraphRAG | Ambos se relacionan con recuperación basada en grafos, según las opciones que declara el README. | GraphRAG figura como motor seleccionable; DeepTutor coordina además interacción, personalización y herramientas. |
HKUDS/AutoAgent | Ambos son proyectos de agentes del mismo grupo y DeepTutor lo cita como inspiración. | AutoAgent se describe en GitHub como marco de agentes sin código; DeepTutor está especializado en aprendizaje y tutoría personalizada. |
No se recuperó un benchmark independiente que compare estas herramientas en coste, precisión o resultados pedagógicos. Por ello, las diferencias anteriores describen el alcance declarado por las fuentes, no una clasificación de rendimiento.
Casos de uso y a quién puede ayudar este repositorio
- Estudiantes y docentes que trabajan con materiales propios pueden reunir documentos, libros, cuestionarios y una biblioteca de conocimiento en una misma área, y alternar entre conversación, práctica, investigación y ruta de dominio sin perder el contexto declarado por el README.
- Equipos educativos que necesitan adaptación trazable pueden usar la memoria L1/L2/L3 y el grafo de memoria para inspeccionar y editar la base de una personalización, en lugar de tratar el perfil del estudiante como una caja negra.
- Personas que investigan con colecciones documentales heterogéneas pueden elegir entre LlamaIndex, PageIndex, GraphRAG, LightRAG u Obsidian, y combinar la recuperación con herramientas, MCP y agentes o compañeros persistentes.
- Administradores y desarrolladores que prefieren despliegue local disponen de rutas por PyPI, código fuente, Docker o línea de comandos; los hallazgos de las incidencias muestran que conviene validar particularmente la configuración de GPU, contenedor y modelo antes de usarlo con documentos pesados.
- Desarrolladores de habilidades educativas pueden emplear el formato Agent Skills y EduHub para incorporar recursos reutilizables, revisando las fuentes importadas antes de añadirlas a una biblioteca de aprendizaje.
Recursos
- Repositorio: https://github.com/HKUDS/DeepTutor
- Documentación e instalación: https://deeptutor.info
- Guía de contribución: https://github.com/HKUDS/DeepTutor/blob/main/CONTRIBUTING.md
- Informe técnico: https://arxiv.org/abs/2604.26962
- Skills oficiales y EduHub: https://github.com/HKUDS/DeepTutor#-ecosystem—eduhub—the-skills-community
- Publicaciones: https://github.com/HKUDS/DeepTutor/releases
- Comunidad y conversaciones: https://github.com/HKUDS/DeepTutor/discussions, https://discord.gg/Jghf8cT7
- Incidencias citadas: https://github.com/HKUDS/DeepTutor/issues/351, https://github.com/HKUDS/DeepTutor/issues/137, https://github.com/HKUDS/DeepTutor/issues/15, https://github.com/HKUDS/DeepTutor/issues/3
Nota: este artículo combina el README, la guía de contribución, publicaciones e incidencias de DeepTutor, la API y página de GitHub, el informe de arXiv y Hacker News, consultados el 4 de agosto de 2026. Las cifras cambian con el tiempo.
Comentarios