

DeepTutor: ein agentenorientierter, personalisierter Lernarbeitsbereich
HKUDS/DeepTutor · 40.284★ · 5.073 forks
Alles Wissenswerte über HKUDS/DeepTutor: eine Open-Source-Anwendung, die Nachhilfe, Übung, Recherche, Dokumentenabruf und Schülergedächtnis in einem einzigen Arbeitsbereich vereint.
Was DeepTutor ist
DeepTutor ist ein agentenorientierter, personalisierter Lernarbeitsbereich. Das README stellt es als erweiterbares System für Nachhilfe, Problemlösung, Quizgenerierung, Recherche, Visualisierung und Fachpraxis vor. Es handelt sich um eine Anwendung, nicht nur um eine Bibliothek für Dokumentenabruf: Sie umfasst eine Weboberfläche, eine Kommandozeilenschnittstelle, Wissensdatenbanken, Werkzeuge und Lernarbeitsbereiche.
Das Design behält für die Modi Konversation, Quiz, Recherche, Visualisierung, Lösung und Fachpfad denselben Agentenzyklus bei. Materialien und Kontext — Bibliotheken, Bücher, Entwürfe, Notizbücher, Fragenbanken, Profile und Gedächtnis — lassen sich zwischen diesen Modi verschieben. Der zentrale Ansatz besteht darin, den nächsten Lernschritt zu personalisieren, ohne jede Aktivität in eine eigene Anwendung aufzuteilen.
Der Ursprung: von einem Community-Launch zu einem technischen Bericht
Das Repository wurde am 28. Dezember 2025 erstellt, und das README verortet den offiziellen Start auf den 29. Dezember 2025. Das Projekt wird als Open Source von Bingxi Zhao innerhalb der Gruppe HKUDS geleitet; das README selbst dankt unter anderem Chao Huang, Direktor des Data Intelligence Lab der HKU, sowie Jiahao Zhang, Zirui Guo und Xubin Ren.
Der technische Kontext wurde später im arXiv-Bericht “DeepTutor: Towards Agentic Personalized Tutoring” formalisiert, eingereicht am 10. April 2026 von Bingxi Zhao, Jiahao Zhang, Xubin Ren, Zirui Guo, Tianzhe Chu, Yi Ma und Chao Huang. Der Artikel stellt eine konkrete Spannung fest: Sprachmodelle gehen von statischem Wissen aus, und herkömmliche Abrufsysteme reichen nicht aus, um geführtes, an jeden Studierenden angepasstes Feedback zu liefern. DeepTutor schlägt vor, quellenbasiertes Wissen mit dynamischem Schülergedächtnis zu kombinieren.
Die öffentliche Erzählung des Projekts ist bewusst community-getrieben: Das README erklärt, dass es keine kostenpflichtigen Online-Produkte anbietet und dass Issues, Pull Requests und Diskussionen das Produkt formen. Es verzeichnet außerdem zwei Adoptionsmeilensteine: 10.000 Sterne in 39 Tagen und 20.000 in 111 Tagen; das sind Ankündigungen des Projekts selbst, keine unabhängige Prüfung.
Philosophie und Prinzipien
Die überprüfbare Philosophie stützt sich auf vier Produktentscheidungen:
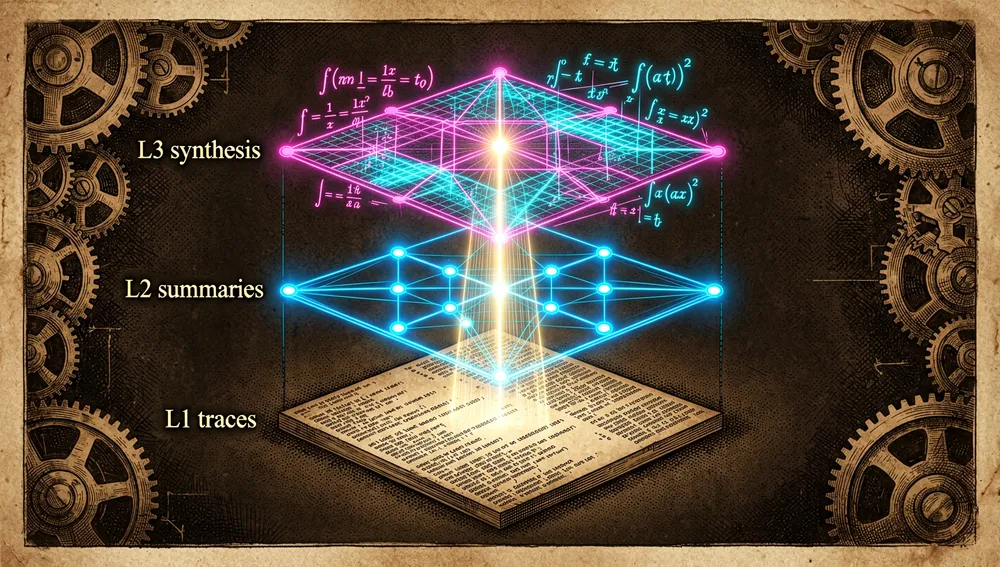
- Sichtbare Personalisierung: Das Gedächtnis ist in L1-Spuren, L2-Zusammenfassungen und L3-Synthese unterteilt; laut README erlaubt der Gedächtnisgraph, eine Aussage bis zu ihrem Beleg zurückzuverfolgen und zu bearbeiten.
- Ein vernetzter Kontext: Bücher, Notizen, Bibliotheken, Quizze und Profile werden nicht als Silos je Lernmodus behandelt.
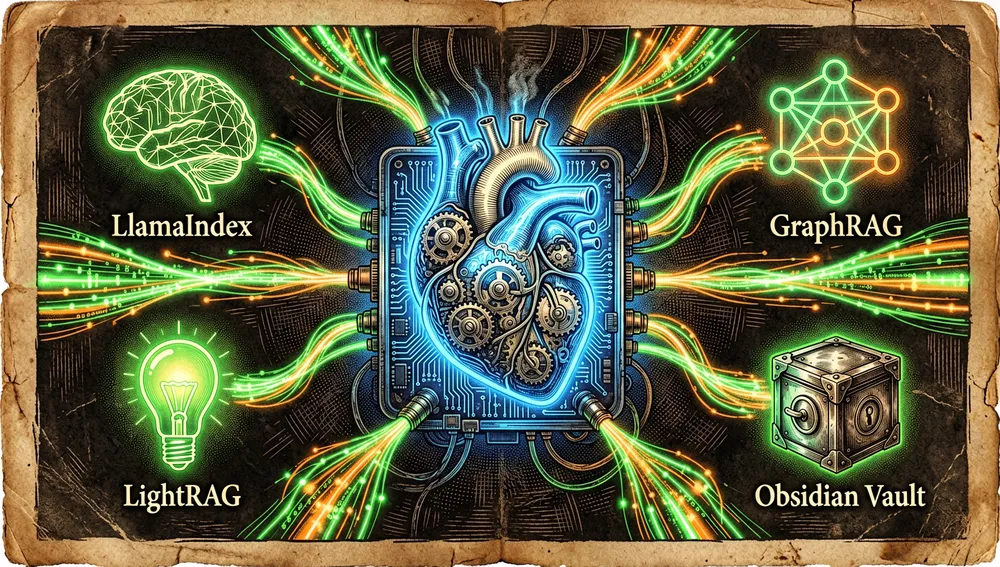
- Austauschbares Wissen: Die Abrufschicht unterstützt LlamaIndex, PageIndex, GraphRAG, LightRAG oder einen verknüpften Obsidian-Tresor, statt sich auf eine einzige Engine festzulegen.
- Erweiterbarkeit statt geschlossenem Katalog: Lernressourcen nutzen das offene Agent-Skills-Format, basierend auf einem Ordner mit
SKILL.md, YAML-Metadaten und optionalen Referenzdateien.
Der Artikel untermauert diese Philosophie mit TutorBench, einer interaktiven Testreihe mit Studierendenprofilen und Universitätslehrplänen aus fünf Fachbereichen. Die durchschnittlichen Verbesserungen von 10,8 % bei personalisierten Metriken und 29,4 % beim Agentenschließen sind vom Autorenteam selbst deklarierte Ergebnisse eines laufenden technischen Berichts; sie sollten nicht als unabhängige externe Validierung gelesen werden.
Wie es funktioniert
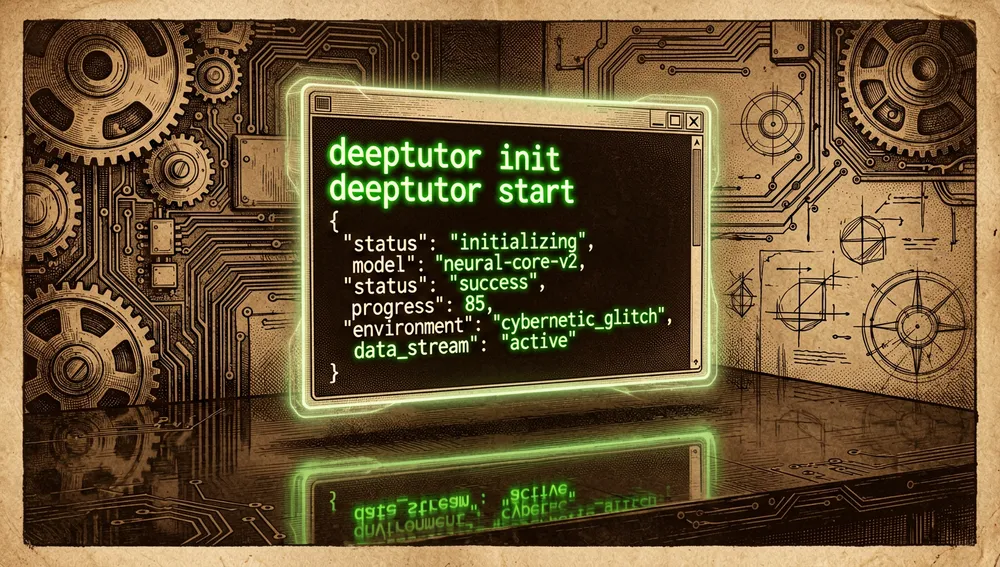
Der dokumentierte Nutzungsablauf besteht darin, ein Arbeitsverzeichnis zu wählen, zu installieren, deeptutor init auszuführen und mit deeptutor start zu starten. Es gibt vier Installationswege: PyPI für die lokale Web-App und die Kommandozeilenschnittstelle, Installation aus dem Quellcode, ein Docker-Container und eine reine Kommandozeilen-Distribution. Die Konfiguration wird unter data/user/settings/ gespeichert, oder am durch DEEPTUTOR_HOME bzw. deeptutor start --home angegebenen Pfad.
Die Oberfläche bietet Konversation, dauerhafte Begleiter, importierbare Agenten, kooperative Markdown-Bearbeitung, lebende Bücher, ein Wissenszentrum, einen Lernraum, Gedächtnis und Einstellungen.
Die Kommandozeilenschnittstelle bietet sowohl eine interaktive Sitzung als auch strukturierte JSON-Ausgabe, sodass ein anderer Agent DeepTutor mit denselben Fähigkeiten, Werkzeugen und Wissensdatenbanken steuern kann.
Im Inneren nutzt die Wissensschicht versionierte, austauschbare Bibliotheken für Abruf und Dokumentenanalyse. Das README dokumentiert außerdem MCP-Server, Kommandozeilenanwendungen, Bild-, Video- und Sprachmodelle sowie eine isolierte Umgebung zum Ausführen von generiertem Code für Office-Dokumente. Version v1.5.9, veröffentlicht am 4. August 2026, fügte Gemini Embedding 2 über dessen nativen Endpunkt, modellweise Steuerung des Denkaufwands, ein Novita-AI-Gateway, Abrufrollen für Anfragen und Compose-Deployments, die data/ erhalten, hinzu.
Offizieller und semi-offizieller Status
Es wurde kein Beleg dafür gefunden, dass DeepTutor in einen offiziellen Marktplatz eines Modellanbieters aufgenommen wurde oder eine Zertifizierung bzw. Unterstützung eines Unternehmens erhalten hat. Es sollte daher nicht als offizielles Produkt von OpenAI, Anthropic, Google, GitHub oder der HKU beschrieben werden.
Sein semi-offizieller Status, im technischen und nicht-kommerziellen Sinn, ergibt sich aus zwei Integrationen, die das README erklärt: Es bringt EduHub mit, das voreingestellte Bildungsregister des Projekts, und ist mit ClawHub sowie dem offenen Agent-Skills-Format kompatibel. Das erlaubt den Import von Skills aus Registern, die dasselbe Format sprechen, entspricht aber keiner Billigung dieser Register oder einem formalen Standard. Die Adoption von 32.408 Sternen zeigt Interesse der Community, nicht die Bezeichnung als De-facto-Standard durch einen Anbieter.
Das Ökosystem
Verwandte HKUDS-Projekte
Das README nennt mehrere HKUDS-Projekte als technische Bausteine oder Inspiration. Die folgenden Zahlen stammen aus einer GitHub-API-Abfrage vom 4. August 2026:
HKUDS/LightRAG— 38.507 Sterne; erscheint als eine der Abrufoptionen und als Inspiration für einfachen, schnellen Abruf.HKUDS/AutoAgent— 9.682 Sterne; das README nennt es als No-Code-Agenten-Framework.HKUDS/AI-Researcher— 5.646 Sterne; genannt als Kanal für automatisierte Recherche.HKUDS/nanobot— 46.618 Sterne; das README merkt an, dass seine leichtgewichtige Engine den ursprünglichen TutorBot von HKUDS antrieb.HKUDS/RAG-Anything— 22.632 Sterne; ein Projekt derselben Gruppe, dessen GitHub-Beschreibung es als umfassendes Retrieval-Framework darstellt.HKUDS/OpenSpace— 7.274 Sterne; seine Beschreibung stellt es als Verwaltungsschicht für Agenten-Skills dar.
In der Organisationsabfrage wurde kein unabhängiges öffentliches EduHub-Repository gefunden; die offizielle Quelle dokumentiert es als integriertes Register von DeepTutor, nicht als separates Repository, dem es sicher zugeordnet werden könnte.
Forks, Anleitungen und Community-Erweiterungen
Die Forks-API liefert insgesamt 4.233 Forks. Zu den sternereichsten gehören 0xSojalSec/AI-Tutor (27), hacksider/DeepTutor (12), oalanicolas/deeptutor (12) und cloudtoolbox/deeptutor (7). Ihre Beschreibungen geben im Wesentlichen den Vorschlag von DeepTutor wieder, weshalb sie als Forks und nicht als technisch eigenständige Ports eingestuft werden.
Außerhalb der Hauptfork-Liste wurden chinesischsprachige Community-Materialien gefunden: chencore/deeptutor-guide und chencore/deeptutor-complete-guide. Ihre Beschreibungen stellen sich als vollständige Installations- und Nutzungsanleitungen für DeepTutor auf Chinesisch dar, und die GitHub-Suche lieferte zum Zeitpunkt dieser Messung für beide 0 Sterne. Es handelt sich um Community-Übersetzungen oder -Dokumentation, nicht um offizielle HKUDS-Repositories.
Das README nennt außerdem LlamaIndex, PageIndex, GraphRAG, Obsidian, OpenClaw, Codex, Claude Code und ManimCat als konzeptionelle Abhängigkeiten, Werkzeuge oder Inspiration. Diese Erwähnung belegt nicht, dass alle davon eingebundene Module, Sponsoren oder gepflegte Erweiterungen von DeepTutor sind.
Repo-Zahlen
Gemessen: 4. August 2026, über die GitHub-API und -Seite.
| Metrik | Wert |
|---|---|
| Sterne | 32.408 |
| Forks | 4.233 |
| Echte Abonnenten | 169 |
| Commits | 1.186 |
| Offene Issues laut API | 88 |
| Auf der Seite sichtbare Issues | 52 |
| Auf der Seite sichtbare offene Pull Requests | 36 |
| Hauptsprache | Python |
| Lizenz | Apache-2.0 |
| Erstellung | 28. Dezember 2025 |
| Letzte Metadaten-Aktualisierung | 4. August 2026, 23:53 UTC |
| Letztes Release | v1.5.9, 4. August 2026 |
Die von der API zurückgegebenen Hauptbeitragenden waren pancacake (562 Beiträge), Pinkllow (116), github-actions[bot] (108), tusharkhatriofficial (20), scrrlt (16) und wedone (16). Die Gesamtzahl von 1.186 Commits stammt von der Repository-Seite. watchers_count in der allgemeinen GitHub-Antwort wiederholt die 32.408 Sterne; deshalb wird hier subscribers_count als echte Abonnentenzahl angegeben. Das API-Feld open_issues_count kann offene Pull Requests einschließen, was erklärt, warum es nicht zwangsläufig mit den separat angezeigten 52 Issues übereinstimmt.
Wie man beiträgt
Das Repository stellt CONTRIBUTING.md sowie eine Roadmap bereit, auf der Punkte abgestimmt oder vorgeschlagen werden können. Das README verweist ausdrücklich auf diese Anleitung für Branching-Strategie, Code-Standards und Einstiegsschritte. Die Pull-Request-Vorlage verlangt, die Änderungen zu beschreiben, verwandte Issues zu verlinken, betroffene Module zu identifizieren und zu bestätigen, dass die Standards eingehalten wurden.
Es gibt Anzeichen aktiver Zusammenarbeit: Der Pull Request #13 von kushalgarg101 fügte Docker-Unterstützung hinzu und schloss die Anfrage #3 von lovingfish, die ein gepflegtes, reproduzierbares Compose-Deployment forderte. Die Anleitung und die Vorlagen sind der dokumentierte Prozess; daraus folgt nicht, dass jeder Vorschlag angenommen wird.
Wie die Community es aufnahm
Die überprüfbare Rezeption verbindet starke GitHub-Adoption mit praktischen, von Nutzern gemeldeten Problemen. Eine umfangreiche Diskussion direkt über HKUDS/DeepTutor wurde auf Hacker News nicht gefunden: Der Beitrag 47703911, veröffentlicht von wslh am 9. April 2026, erhielt 2 Punkte und 0 Kommentare. Er belegt, dass das Repository entdeckt wurde, lässt aber keine Rückschlüsse auf Lob, Kritik oder Konsens zu.
- Konkrete Anerkennung: In Issue #351, mit 10 Kommentaren, dankte
StarNight2021ausdrücklichjiakebogeundpancacakefür Pull Request #319 und erklärte, deren Änderungen hätten das schwere Einfrieren bei langen Gesprächen beseitigt. Dasselbe Issue relativiert das Lob: Bei schnellem Tippen wurde weiterhin eine Eingabeverzögerung beobachtet, weshalb es keine Gesamtbewertung des Produkts darstellt. - Kritik an der Leistung: In Issue #137, mit 9 Kommentaren, berichtete
yepyhun, dass das reine CPU-Docker-Image die PDF-Verarbeitung von MinerU extrem verlangsame; als Beispiel nannte er etwa 40 Sekunden pro Seite auf einer RTX 3070 Ti bei CPU-Inferenz. Das ist eine von diesem Nutzer gemeldete Erfahrung und Konfiguration, keine universelle Vergleichsmessung. - Kritik an der Kompatibilität: In dem geschlossenen Issue #15, mit 17 Kommentaren, beschrieb
tusharkhatriofficialeinen Fehler des Smart Solvers, wenn ein Modell ungültige mehrzeilige Python-Strings innerhalb von JSON erzeugte. Der Bericht identifiziert eine Einschränkung der Integration mit Modellausgaben, keinen Einwand gegen den Bildungszweck von DeepTutor.
- Nachfrage nach Deployment: Die Anfrage #3, mit 12 Kommentaren, forderte vorgefertigte Images und ein offizielles Compose-Setup, damit Python- und Node-Abhängigkeiten nicht auf dem Host-Rechner installiert werden müssen. Ihr Abschluss durch #13 zeigt eine Wartungsreaktion auf ein Community-Bedürfnis, misst aber nicht die spätere Zufriedenheit.
DeepTutor im Vergleich zu anderen Ansätzen
| Ansatz | Überprüfbare Übereinstimmung | Überprüfbarer Unterschied |
|---|---|---|
HKUDS/LightRAG | DeepTutor kann LightRAG als Retrieval-Engine wählen. | LightRAG präsentiert sich als Retrieval Augmentation; DeepTutor fügt Nachhilfe-, Gedächtnis-, Quiz- und Lernarbeitsbereich-Oberflächen hinzu. |
| LlamaIndex | DeepTutor dokumentiert LlamaIndex als Option für seine Wissensbibliotheken. | In DeepTutor ist es eine austauschbare Retrieval-Komponente; das README stellt LlamaIndex nicht als Ersatz für seine Nachhilfe- und Gedächtnismodi dar. |
| GraphRAG | Beide beziehen sich auf graphbasiertes Retrieval, gemäß den vom README erklärten Optionen. | GraphRAG erscheint als wählbare Engine; DeepTutor koordiniert zusätzlich Interaktion, Personalisierung und Werkzeuge. |
HKUDS/AutoAgent | Beide sind Agentenprojekte derselben Gruppe, und DeepTutor nennt es als Inspiration. | AutoAgent wird auf GitHub als No-Code-Agenten-Framework beschrieben; DeepTutor ist auf personalisiertes Lernen und Nachhilfe spezialisiert. |
Es wurde kein unabhängiger Benchmark gefunden, der diese Werkzeuge bei Kosten, Genauigkeit oder pädagogischen Ergebnissen vergleicht. Die obigen Unterschiede beschreiben daher den von den Quellen erklärten Umfang, keine Leistungsrangliste.
Anwendungsfälle und wem dieses Repository helfen kann
- Studierende und Lehrende, die mit eigenen Materialien arbeiten, können Dokumente, Bücher, Quizze und eine Wissensbibliothek an einem Ort zusammenführen und zwischen Konversation, Übung, Recherche und Fachpfad wechseln, ohne den vom README beschriebenen Kontext zu verlieren.
- Bildungsteams, die nachvollziehbare Anpassung benötigen, können das L1/L2/L3-Gedächtnis und den Gedächtnisgraphen nutzen, um die Grundlage einer Personalisierung zu prüfen und zu bearbeiten, statt das Schülerprofil als Blackbox zu behandeln.
- Personen, die mit heterogenen Dokumentensammlungen forschen, können zwischen LlamaIndex, PageIndex, GraphRAG, LightRAG oder Obsidian wählen und Retrieval mit Werkzeugen, MCP und Agenten oder dauerhaften Begleitern kombinieren.
- Administratoren und Entwickler, die lokale Bereitstellung bevorzugen, verfügen über Wege via PyPI, Quellcode, Docker oder Kommandozeile; die Erkenntnisse aus den Issues legen nahe, insbesondere GPU-, Container- und Modellkonfiguration zu validieren, bevor umfangreiche Dokumente verarbeitet werden.
- Entwickler von Bildungs-Skills können das Agent-Skills-Format und EduHub nutzen, um wiederverwendbare Ressourcen einzubringen, wobei importierte Quellen vor der Aufnahme in eine Lernbibliothek geprüft werden sollten.
Ressourcen
- Repository: https://github.com/HKUDS/DeepTutor
- Dokumentation und Installation: https://deeptutor.info
- Beitragsanleitung: https://github.com/HKUDS/DeepTutor/blob/main/CONTRIBUTING.md
- Technischer Bericht: https://arxiv.org/abs/2604.26962
- Offizielle Skills und EduHub: https://github.com/HKUDS/DeepTutor#-ecosystem—eduhub—the-skills-community
- Releases: https://github.com/HKUDS/DeepTutor/releases
- Community und Diskussionen: https://github.com/HKUDS/DeepTutor/discussions, https://discord.gg/Jghf8cT7
- Zitierte Issues: https://github.com/HKUDS/DeepTutor/issues/351, https://github.com/HKUDS/DeepTutor/issues/137, https://github.com/HKUDS/DeepTutor/issues/15, https://github.com/HKUDS/DeepTutor/issues/3
Hinweis: Dieser Artikel kombiniert das README, die Beitragsanleitung, Releases und Issues von DeepTutor, die GitHub-API und -Seite, den arXiv-Bericht und Hacker News, abgerufen am 4. August 2026. Die Zahlen ändern sich mit der Zeit.
Kommentare