

LTX-2: das Audio-Video-Modell mit offenen Gewichten, das auf Ihrer eigenen GPU läuft
Lightricks/LTX-2 · 9.525★ · 1.503 forks
Das Wesentliche zu Lightricks/LTX-2: das offizielle Python-Inferenzpaket und LoRA-Trainingswerkzeug für das generative Audio-Video-Modell LTX-2, begleitet vom Modell auf Hugging Face, einer Familie von Pipelines, und einem Trainer.
Was LTX-2 ist
LTX-2 ist ein auf DiT (Diffusion Transformer) basierendes Fundamentmodell für die Audio- und Videogenerierung. Anders als „stumme” Videomodelle generiert LTX-2 Video und Audio synchronisiert innerhalb eines einzigen Modells: Die Tonspur folgt Charakteren, Umgebung, und Effekten — sie wird nicht separat generiert. Das README beschreibt es als „das erste DiT-basierte Audio-Video-Fundamentmodell”, das die Kernfähigkeiten moderner Videogenerierung in einem Modell vereint: synchronisiertes Audio und Video, hohe Wiedergabetreue, mehrere Performance-Modi, produktionsreife Ausgaben, API-Zugang, und offene Gewichte.
Das hier dokumentierte Repository (Lightricks/LTX-2) ist nicht das Modell selbst, sondern sein offizielles Softwarepaket: Es ist ein Monorepo mit drei Unterpaketen — ltx-core (Modellimplementierung und Inferenz-Stack), ltx-pipelines (die hochstufigen Generierungsrouten), und ltx-trainer (LoRA-Training und Feinabstimmung, vollständige Feinabstimmung, und IC-LoRA) — plus eine Agenten-Skill für unterstütztes Training. Die Modellgewichte befinden sich auf Hugging Face (Lightricks/LTX-2 und, in der aktuell empfohlenen Version, Lightricks/LTX-2.5).
Die Architektur ist laut dem technischen Paper ein asymmetrischer Dual-Stream-Transformer: eine Videozweig mit 14 Milliarden Parametern und ein Audiozweig mit 5 Milliarden, gekoppelt über bidirektionale Cross-Attention-Schichten mit zeitlichen Positions-Embeddings und einem Cross-Modalitäts-AdaLN für die gemeinsame Zeitschritt-Konditionierung. Mehr Kapazität dem Video als dem Audio zuzuweisen ist eine bewusste Designentscheidung. Das Modell verwendet einen mehrsprachigen Textencoder (für LTX feinabgestimmtes Gemma) und führt einen Modality-CFG-Mechanismus ein (modalitätsbewusstes Classifier-free Guidance), um die Audio-Video-Ausrichtung und Steuerbarkeit zu verbessern.
Ursprung
Das Repository wurde am 3. Januar 2026 von Lightricks erstellt, dem israelischen Unternehmen hinter der LTX-Familie. Das LTX-2-Modell wurde formal im Paper „LTX-2: Efficient Joint Audio-Visual Foundation Model” vorgestellt (arXiv:2601.03233, veröffentlicht am 6. Januar 2026), mit Yoav HaCohen als Erstautor und Zeev Farbman — Mitgründer und CEO von Lightricks — als Letztautor.
Die aufschlussreichste Launch-Anekdote findet sich im AMA des CEOs auf Reddit. Am 8. Januar 2026 antwortete Farbman als u/ltx_model im r/StableDiffusion-Thread 1q7dzq2: „Ich bin der Mitgründer und CEO von Lightricks. Wir haben gerade LTX-2 als Open Source veröffentlicht, ein Audio-Video-Produktionsmodell. AMA.” Er stellte klar, dass die vollständige Veröffentlichung Gewichte, Code, einen Trainer, Benchmarks, LoRAs, und Dokumentation umfasste, und dass das Modell „lokal auf Consumer-GPUs läuft und echte Produkte bei Lightricks antreibt”. Der Thread erreichte 1.554 Stimmen und 460 Kommentare, und der CEO schloss ihn mit der Anerkennung, dass „das Volumen der Fragen alle Erwartungen übertraf”.
Die Hintergrundgeschichte ist Lightricks’ These: Generative Modelle „entwickeln sich zu vollständigen Render-Engines”, mit Eingaben wie Tiefe, Normalen, und Bewegungsvektoren, und Ausgaben, die in Compositing-Pipelines, VFX, Animationswerkzeuge, und Game-Engines fließen. Farbman argumentiert, dass „statische APIs das nicht abdecken können” und dass vieles davon am Edge laufen muss. Daher seine wiederholte Zeile: „Offene Gewichte sind kein Luxus, sie sind der einzige Weg, der funktioniert”, und Lightricks monetarisiert über Lizenzierung und eine Umsatzbeteiligung, sobald jemand, der darauf aufbaut, die Schwelle von 10 Millionen Dollar Jahresumsatz überschreitet.
Philosophie und Prinzipien
Offen durch Architektur, nicht durch Wohltätigkeit: Farbman formuliert es explizit — „wir betrachten offene Gewichte nicht als Wohltätigkeit oder guten Willen; es ist das Herzstück dessen, wie wir glauben, dass Render-Engines gebaut werden sollten”. Das Ziel ist, dass das Modell zur integrierten Infrastruktur in Pipelines wird, nicht zu einer API, die man konsumiert.
Lokale und reproduzierbare Nutzung: „offene Veröffentlichungen multimodaler Modelle sind selten, und wenn sie geschehen, sind sie meist schwer auszuführen oder zu reproduzieren. Wir haben LTX-2 so gebaut, dass man es wirklich nutzen kann: es läuft lokal auf Consumer-GPUs.”
Ein Modell, zusammengesetzte Fähigkeiten: Audio und Video zusammen, nicht als zwei zusammengeklebte Modelle; die Synchronisation ist dem Design inhärent. Vom Nutzer trainierbar: Das Basismodell (dev) ist vollständig trainierbar, und der Trainer wird veröffentlicht, damit jeder seinen eigenen Datensatz mitbringen und für seinen Fall feinabstimmen kann; bei vielen Anpassungen kann das Feinabstimmen für Bewegung, Stil, oder Ähnlichkeit „weniger als eine Stunde dauern”. Effizienz als Priorität: Der destillierte Transformer (distilled) läuft in sehr wenigen Schritten, und die Pipeline-Familie trennt explizit den schnellen Modus vom Produktionsqualitätsmodus (DFR).
Wie es funktioniert
Das Repository ist in drei Pakete gegliedert, jedes mit eigenem README und eigener Dokumentation: ltx-core (Modellimplementierung, Inferenz-Stack, und Hilfsprogramme), ltx-pipelines (die hochstufigen Generierungsrouten: Text-zu-Video, Bild-zu-Video, und andere Modi), und ltx-trainer (Trainings- und Feinabstimmungswerkzeuge — LoRA, vollständige Feinabstimmung, und IC-LoRA).
Die verfügbaren Pipelines sind das praktische Kernstück:
DistilledPipeline— der schnelle Ausgangspunkt: schnelleres Text-/Bild-zu-Video (8 vordefinierte Sigmas: 8 Schritte Stufe 1, 4 Schritte Stufe 2).DFRPipeline— Produktionsqualität (DFR, Diffusion Fidelity Rendering): verwendet denselben destillierten Transformer plus ein Detaillierungs-IC-LoRA; generiert innere Keyframes und einen räumlichen Detaillierungsdurchgang, optional mit 2×/4× bei fps.TI2VidTwoStagesPipeline/TI2VidTwoStagesHQPipeline— geführtes zweistufiges Text-/Bild-zu-Video mit CFG/STG und 2×-Hochskalierung.TI2VidOneStagePipeline— einstufige Generierung für schnelles Prototyping.ICLoraPipeline— Video-zu-Video- und Bild-zu-Video-Transformation.KeyframeInterpolationPipeline— Interpolation zwischen Keyframe-Bildern.A2VidPipelineTwoStage— Videogenerierung aus Audio, konditioniert auf eine Eingabe-Audiodatei.RetakePipeline— regeneriert eine bestimmte zeitliche Region eines bestehenden Videos.HDRICLoraPipeline— Video-zu-Video mit HDR-Ausgabe über IC-LoRA.DubItPipeline— Dialog-Neuschreibung unter Beibehaltung der Identität und Lippenbewegungen des Sprechers.- Natives HDR/EXR — die Standard-Pipelines akzeptieren EXR-Frames mit
--hdr {SRGB_LINEAR,ACESCG,ACESCCT}und schreiben Half-Float-EXR-Frames plus einen BT.2020/HLG-Master.
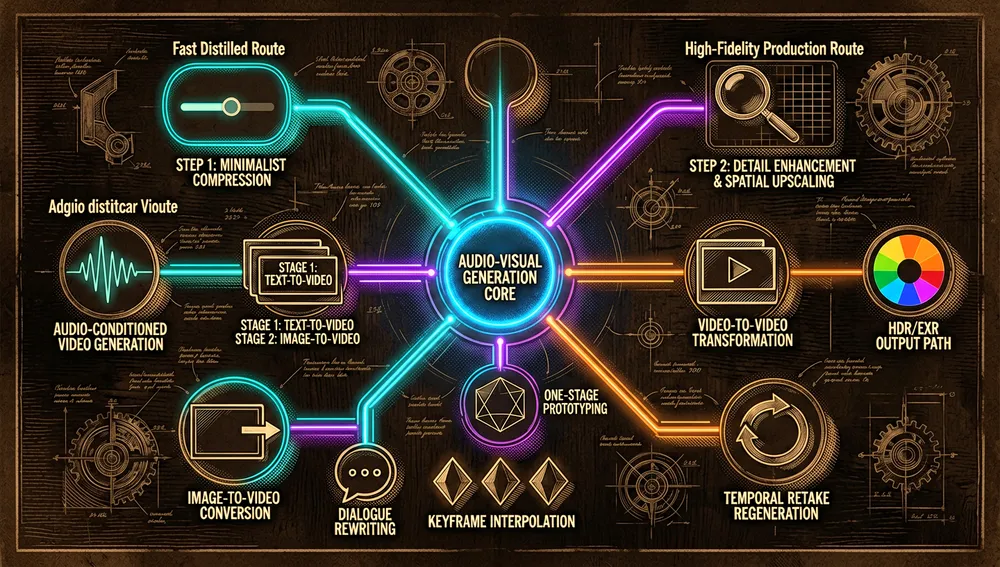
Der Trainer unterstützt eine breite Palette an Bedingungsmodi: Text-zu-Video, Text-zu-Audio, Bild-zu-Video, Videoerweiterung, Audioerweiterung, Video- und Audio-Inpainting, Video-Outpainting, IC-LoRA für Video/Audio/gemeinsames Audio-Video, Audio-zu-Video, und Video-zu-Audio. Es gibt außerdem eine Agenten-Skill (.claude/skills/train-model), die einen End-to-End-Trainingslauf anleitet: erkundet Daten und Hardware, wählt den Modus, bereitet den Datensatz vor/verarbeitet ihn vor, startet das Training, und überwacht es.
Das Ökosystem
Repositorys von Lightricks (dieselbe Organisation)
| Repository | Sterne | Rolle |
|---|---|---|
Lightricks/LTX-Video | 10.950 | Offizielles LTX-Video-Repository (das frühere Echtzeit-Videomodell von 2024). |
Lightricks/LTX-2 | 9.411 | Dieses Repository: Inferenzpaket und Trainer für LTX-2. |
Lightricks/ComfyUI-LTXVideo | 4.129 | LTX-Video/LTX-2-Unterstützung für ComfyUI. |
Lightricks/LTX-Desktop | 1.988 | Open-Source-Desktop-App zur Videogenerierung mit LTX-Modellen. |
Lightricks/LTX-Video-Trainer | 468 | Community-Trainer für das LTX-Video-Modell. |
Lightricks/LTX-Video-Q8-Kernels | 82 | Q8-Kernel für LTX-Video. |
Modelle auf Hugging Face
Lightricks/LTX-2 — das ursprüngliche Modell (19B: 14B Video + 5B Audio). Beim Abruf: 333.852 Downloads und 1.779 „Gefällt mir”. image-to-video-Pipeline, integriert in diffusers als LTX2Pipeline. Lightricks/LTX-2.5 — die aktuell vom README empfohlene Version (22B-Transformer + Gemma 4 12B). Beim Abruf: 1.559.653 Downloads und 3.821 „Gefällt mir”. Erstellt am 23. Juli 2026. Lightricks/LTX-2.5-22b-IC-LoRA-Pixel-Spatial-Upscaler — das Detaillierungs-IC-LoRA, das die DFR-Pipeline benötigt. Die Gewichte werden „eine Datei pro Komponente” veröffentlicht, sodass nur die Teile heruntergeladen werden, die jede Pipeline benötigt.
Integration mit ComfyUI
Das README und die Modellkarte verweisen auf Lightricks/ComfyUI-LTXVideo und empfehlen die Verwendung der im ComfyUI Manager gebündelten LTXVideo-Knoten. Es gibt auch ein Community-Projekt, LTXMac (eine native Mac-App zur Text-zu-Video-Generierung, vorgestellt in einer Show-HN im Januar 2026), aufgebaut auf der LTX-Familie.
Offizieller/halboffizieller Status
LTX-2 hat einen klaren Ruf als De-facto-Standard im Open-Source-Videogenerierungs-Ökosystem: Es ist als LTX2Pipeline in die offizielle diffusers-Bibliothek integriert, mit dedizierter Dokumentation; LTXVideo-Knoten sind über den ComfyUI Manager verfügbar; Lightricks bietet LTX-Studio (Online-Demo) und eine kostenpflichtige API, und der CEO erklärt, das Modell „treibt echte Produkte bei Lightricks an”; und die Gewichte befinden sich auf Hugging Face unter der LTX Community License (keine OSI-Lizenz; Unternehmen mit Jahresumsatz von mindestens 10.000.000 Dollar wechseln zu einem Lizenzzweig, der kommerzielle Bedingungen erfordert).
In der Praxis bedeutet das, dass LTX-2 als Referenz unter den offenen, lokal ausführbaren Audio-Video-Modellen fungiert: Es ist in diffusers, in ComfyUI, in einer Desktop-App, und hat eine kommerzielle API, aber es gibt keine „formale Standardbezeichnung” durch eine externe Stelle in den konsultierten Quellen.
Schnellstart-Anleitung
Installation und erster Start
Voraussetzungen: Python ≥ 3.12, CUDA (>12.7 empfohlen), PyTorch ~= 2.7, und eine GPU mit reichlich VRAM.
git clone https://github.com/Lightricks/LTX-2.git
cd LTX-2

# Das `natten`-Extra ist das schnellste Backend für den Video-VAE; nur Linux+CUDA.
uv sync --extra natten

# Modell herunterladen (LTX-2.5-Repository, ~66 GiB)
hf auth login
hf download Lightricks/LTX-2.5 \
    diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
    text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
    vae/ltx-2.5-video-vae-bf16.safetensors \
    vae/ltx-2.5-audio-vae-bf16.safetensors \
    latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
    --local-dir models/ltx-2.5
Beim ersten Start, falls ein 401/403 von Hugging Face erscheint, müssen die Modellbedingungen akzeptiert und mit einem Lese-Token angemeldet werden.
Gängige Workflows
1. Schnelles Text-zu-Video (DistilledPipeline). Um einen Startclip zu generieren:
uv run python -m ltx_pipelines.distilled \
    --transformer-path   models/ltx-2.5/diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
    --text-encoder-path  models/ltx-2.5/text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
    --video-vae-path     models/ltx-2.5/vae/ltx-2.5-video-vae-bf16.safetensors \
    --audio-vae-path     models/ltx-2.5/vae/ltx-2.5-audio-vae-bf16.safetensors \
    --spatial-upsampler-path models/ltx-2.5/latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
    --num-frames 121 --seed 42 --output-path output.mp4 \
    --prompt "..."
Das Ergebnis landet in output.mp4. Standardmäßig sind es 1024×1536 bei 24 fps.
2. Produktionsqualität (DFRPipeline). Derselbe Download wird wiederverwendet und das Detaillierungs-IC-LoRA hinzugefügt, indem ltx_pipelines.dfr_pipeline mit dem zusätzlichen Flag --detailing-lora ausgeführt wird. Ausgabe in output_dfr.mp4; 4K UHD ist --width 3840 --height 2176.
3. Video aus Audio (A2Vid). A2VidPipelineTwoStage wird verwendet, um ein Video zu generieren, das auf eine Eingabe-Audiodatei konditioniert ist.
4. Dialog synchronisieren/neu schreiben (DubIt). DubItPipeline schreibt den Dialog neu unter Beibehaltung der Identität und Lippen des Sprechers.
Wesentliche Konfiguration
--num-frames: teilbar durch 8 plus 1; kann mit--auto-durationweggelassen werden.--quantization:fp8-cast,fp8-scaled-mm(Hopper+),nvfp4-cast/nvfp4-prequant(Blackwell).--offload {cpu,disk}: für GPUs mit begrenztem VRAM.--hdr {SRGB_LINEAR,ACESCG,ACESCCT}: Farbraumauswahl für EXR-Konditionierung und HDR-Kodierung.- Prompt-Leitfaden: Das README empfiehlt chronologische, wörtliche Prompts von bis zu 200 Wörtern, „wie ein Kameramann, der eine Aufnahmenliste beschreibt”.
Häufige Fallstricke und Lösungen
- 401/403 beim Herunterladen von Hugging Face: die Modellbedingungen akzeptieren und mit einem Lese-Token anmelden.
- Auflösung und Bildzahl: Breite/Höhe teilbar durch 32 und Bildzahl durch 8+1; 4K ist 3840×2176, nicht 3840×2160.
nattenist nur Linux+CUDA: unter Windows/macOS wird es übersprungen und auf Triton/eager zurückgegriffen.- Das Gemma nicht ersetzen: der Textencoder muss das für LTX feinabgestimmte Gemma 4 sein; Googles „Stock”-Gemma-4 ist kein Ersatz.
- OOM beim Dekodieren des VAE:
pipe.vae.enable_tiling()wird auf dem diffusers-Pfad empfohlen. - Gewichte sind zwischen LTX-2.3 und LTX-2.5 nicht austauschbar: ein LoRA funktioniert nur mit dem Modell, mit dem es trainiert wurde.
- Der Download beträgt ~66 GiB: er wird pro Komponente heruntergeladen, sodass nicht alles gezogen werden muss.
Integrationen und Migration
diffusers: LTX-2 ist als LTX2Pipeline und LTX2LatentUpsamplePipeline verfügbar; direkte Migration mit LTX2Pipeline.from_pretrained("Lightricks/LTX-2", torch_dtype=torch.bfloat16). ComfyUI: über Lightricks/ComfyUI-LTXVideo und die LTXVideo-Knoten des Managers. LTX-Studio/API: für Cloud-Nutzung ohne Hardware-Verwaltung. HDR/EXR Richtung VFX: lineare EXR-Ausgaben und der BT.2020/HLG-Master erleichtern die Migration von traditionellen Compositing-Workflows.
Aktuelle Kennzahlen
Messung: 14. September 2026, GitHub-API.
| Kennzahl | Wert |
|---|---|
| Sterne | 9.411 |
| Forks | 1.489 |
Abonnenten (subscribers_count) | 99 |
| Offene Issues | 41 |
Commits auf main | 50 (ungefähr) |
| Hauptsprache | Python |
| Lizenz | LTX Community License (eigen, nicht OSI) |
| Erstellt | 3. Januar 2026 |
| Letzte Aktivität (Push) | 26. August 2026 |
| Neuestes Release | v1.3.0, 26. August 2026 |
Top-Contributors: michaellightricks (26), github-actions[bot] (10), AlexeyKravtsov1987 (1) und Bmantl (1). Die GitHub-API verwendet open_issues_count, was offene Pull Requests einschließen kann. Das watchers_count-Feld der allgemeinen Antwort spiegelt die Sterne wider; deshalb wird das Feld subscribers_count separat als echte Abonnenten gemeldet.
Wie man beiträgt
Das README des Trainers dokumentiert einen offenen, einfachen Prozess: Ergebnisse teilen (interessante LoRAs oder gute Ergebnisse mit der Community), Probleme melden (ein Issue auf GitHub bei einem Bug oder Vorschlag eröffnen), PRs einreichen (Bugfixes oder allgemeine Verbesserungen), und Funktionen anfragen (über GitHub-Issues). Die Community koordiniert sich hauptsächlich über den offiziellen Discord, wo das Entwicklungsteam Support bietet und Ergebnisse geteilt werden.
Wie die Community es aufnahm
Im AMA des CEOs (r/StableDiffusion 1q7dzq2, 8. Januar 2026, 1.554 Stimmen und 460 Kommentare) war Farbmans meistgevotete Antwort die Rechtfertigung offener Gewichte: „Modelle entwickeln sich zu vollständigen Render-Engines… offene Gewichte sind kein Luxus, sie sind der einzige Weg, der funktioniert. Wir monetarisieren über Lizenzierung und eine Umsatzbeteiligung, wenn Leute erfolgreiche Produkte darauf aufbauen (wir ziehen die Grenze bei 10 Mio. $ Umsatz)”. Er kündigte außerdem eine inkrementelle Version 2.1 und einen architektonischen Sprung 2.5 an.
u/Neex, der sich als Niko von Corridor Digital identifiziert, nahm am Thread teil und sagte „du triffst diese Antwort genau”; dann fügte u/That_Buddy_2928 hinzu, dass das Video zum Bullet-Time-Remaster von Corridor „entscheidend war, um einige meiner skeptischeren Freunde von der Gültigkeit von KI in der Pipeline zu überzeugen”. u/SvenVargHimmel warf auf, ob das Modell gezwungen werden kann, ein einzelnes Bild zu generieren, und ob es Normalen- oder Tiefenkarten als Video exportieren kann — ein Zeichen, dass Nutzer es bereits als Render-Engine behandelten.
Auf Hacker News ist die relevanteste Show HN 47214472 „Show HN: Audio-to-Video with LTX-2” (von runshouse, 2. März 2026), mit 23 Punkten und 2 Kommentaren.
Im Subreddit r/StableDiffusion vom August 2026 dominiert LTX 2.5 die Threads zur lokalen Nutzung: zum Beispiel „MiniMax H3 Model Copied LTX 2.5’s Best Feature… And It’s CRAZY Fast!” (159 Stimmen, 96 Kommentare) und „I Found a way to reduce LTX 2.5’s horrible smearing. Custom node + Workflow” (158 Stimmen, 24 Kommentare). Diese Threads geben zwei Lesarten gleichzeitig: Begeisterung für die Qualität und eine konkrete Kritik — das Bewegungs-„Smearing” — die die Community mit eigenen Knoten auszugleichen versucht.
Die Modellkarte erklärt explizite Einschränkungen: Es ist nicht für faktische Informationen gedacht, kann Vorurteile verstärken, kann dem Prompt nicht folgen (stark abhängig vom Prompt-Stil), und Audio ohne Stimme kann von geringerer Qualität sein.
Vergleich mit ähnlichen Projekten
| Projekt | Verifizierbare Überschneidung | Verifizierbarer Unterschied |
|---|---|---|
Lightricks/LTX-2.5 (derselbe Autor) | Dieselbe Familie, dieselbe Infrastruktur; das README behandelt es als Ausgangspunkt. | 22B-Transformer + Gemma 4, neuer latenter Raum; mehr Downloads (1,56 M) als LTX-2 (333 K). Es ist die Weiterentwicklung, kein Konkurrent. |
| Runway Gen-4 | Produktions-Videogenerator, gelistet in Lightricks’ eigenem Leitfaden. | Geschlossenes, cloudbasiertes Modell; LTX-2 bietet offene Gewichte und lokale Ausführung. |
| Google Veo 3.1 | Videogenerator mit Audio, gelistet im selben Leitfaden. | Geschlossen, von Google; LTX-2 ist offen und lokal. |
| Kling 3.0 | Hochwertiges Video, gelistet im eigenen Leitfaden. | Geschlossen; LTX-2 integriert sich in diffusers/ComfyUI. |
| Pika 2.2 | Kreativer Videogenerator, gelistet im eigenen Leitfaden. | Geschlossen, API-Konsum; LTX-2 ist lokal und trainierbar. |
| MiniMax H3 | Open-Weight-Generator für lokale Nutzung, wiederholt mit LTX 2.5 auf r/StableDiffusion verglichen. | Lightricks beschreibt es als das, das „die beste Funktion von LTX 2.5 kopiert hat”; es ist ein direkter Rivale im offenen Feld. |
Der nützlichste Vergleich erfolgt nicht nach Popularität: LTX-2 sticht hervor, wenn man ein offenes, lokales Audio-Video-Modell möchte, das sich in diffusers/ComfyUI integriert und trainierbar ist; ein geschlossener Cloud-Generator kann vorzuziehen sein, wenn keine eigene Hardware vorhanden ist.
Anwendungsfälle
- Ersteller und Produktionsfirmen, die lokales, kontrolliertes Audio-Video wollen: das synchronisierte Video-Audio-Paar (mit
A2VidPipelineTwoStageundDubItPipeline) dient jedem, der Dialoginhalte ohne separaten Synchronisations- oder Effektschritt erstellt. - VFX- und Postproduktions-Teams: HDR/EXR-Ausgaben und
RetakePipelinesind darauf ausgelegt, in Color-Grading- und Compositing-Pipelines ohne verlustbehaftetes Zwischenglied einzufließen.
- Forscher und ML-Teams, die Modelle feinabstimmen:
ltx-trainerund die Agenten-Skilltrain-modelerlauben es, einen eigenen Datensatz mitzubringen und Stil, Bewegung, oder Ähnlichkeit feinabzustimmen, manchmal „in weniger als einer Stunde”. - Entwickler, die generative Modelle in Software integrieren: die Integration in diffusers und ComfyUI erlaubt es, LTX-2 in bestehende Anwendungen und Abläufe einzubetten.
- Personen mit Consumer-GPUs: die destillierte Variante und die Optionen
--quantization/--offloadsind darauf ausgerichtet, dass das Modell lokal auf Consumer-GPUs läuft.
Ressourcen
- Repository: https://github.com/Lightricks/LTX-2
- Hugging Face: https://huggingface.co/Lightricks/LTX-2 und https://huggingface.co/Lightricks/LTX-2.5
- Technisches Paper: https://arxiv.org/abs/2601.03233
- Community / Discord: https://discord.gg/ltxplatform
- Online-Demo: https://app.ltx.studio/ltx-2-playground/t2v
- AMA des CEOs: https://www.reddit.com/r/StableDiffusion/comments/1q7dzq2/
- HN: https://news.ycombinator.com/item?id=47214472
- diffusers: https://huggingface.co/docs/diffusers/main/en/api/pipelines/ltx2
- Blog / Prompting-Leitfaden: https://ltx.io/blog
Hinweis: Dieser Artikel kombiniert das README des Repositorys, die Modellkarte auf Hugging Face, das Paper arXiv:2601.03233, das AMA des CEOs auf Reddit, Versionshinweise (v1.2.0, v1.3.0), die GitHub-API, und Ergebnisse von Hacker News und Reddit, konsultiert am 14. September 2026. Sternezahlen, Downloads, und Stimmen ändern sich mit der Zeit.
Kommentare