

LTX-2: el modelo audio-vídeo con pesos abiertos que corre en tu propia GPU
Lightricks/LTX-2 · 9.525★ · 1.503 forks
Lo esencial sobre Lightricks/LTX-2: el paquete oficial de inferencia en Python y de entrenamiento de LoRA para el modelo generativo audio-vídeo LTX-2, acompañado del modelo en Hugging Face, una familia de pipelines y un entrenador.
Qué es LTX-2
LTX-2 es un modelo fundamental de generación de audio y vídeo basado en DiT (Diffusion Transformer). A diferencia de los modelos de vídeo «silenciosos», LTX-2 genera vídeo y audio sincronizados en un mismo modelo: la pista sonora acompaña a los personajes, al entorno y a los efectos, no se genera aparte. El README lo describe como «el primer modelo fundamental de audio-vídeo basado en DiT» que reúne en un solo modelo las capacidades centrales de la generación de vídeo moderna: audio y vídeo sincronizados, alta fidelidad, varios modos de rendimiento, salidas listas para producción, acceso por API y pesos abiertos.
El repositorio documentado aquí (Lightricks/LTX-2) no es el modelo en sí, sino su paquete oficial de software: es un monorepo con tres subpaquetes — ltx-core (implementación del modelo y pila de inferencia), ltx-pipelines (las rutas de generación de alto nivel) y ltx-trainer (entrenamiento y afinado de LoRA, ajuste completo e IC-LoRA) — además de una habilidad de agente para entrenamiento asistido. Los pesos del modelo viven en Hugging Face (Lightricks/LTX-2 y, en la versión actual recomendada, Lightricks/LTX-2.5).
La arquitectura, según el paper técnico, es un transformer de doble rama (dual-stream) asimétrico: una rama de vídeo de 14.000 millones de parámetros y una rama de audio de 5.000 millones, acoplados mediante capas de atención cruzada (cross-attention) bidireccional con embeddings posicionales temporales y un AdaLN de cross-modalidad para la condición de paso de tiempo compartida. Asignar más capacidad al vídeo que al audio es una decisión deliberada del diseño. El modelo usa un codificador de texto multilingüe (Gemma afinado para LTX) y introduce un mecanismo de modality-CFG (classifier-free guidance consciente de la modalidad) para mejorar el alineamiento y la controlabilidad audio-vídeo.
Origen
El repositorio fue creado el 3 de enero de 2026 por Lightricks, la empresa israelí detrás de la familia LTX. El modelo LTX-2 se presentó formalmente en el paper «LTX-2: Efficient Joint Audio-Visual Foundation Model» (arXiv:2601.03233, publicado el 6 de enero de 2026), con Yoav HaCohen como primer autor y Zeev Farbman —cofundador y CEO de Lightricks— como último.
La anécdota de lanzamiento más reveladora está en el AMA del CEO en Reddit. El 8 de enero de 2026, Farbman respondió como u/ltx_model en el hilo r/StableDiffusion 1q7dzq2: «Soy el cofundador y CEO de Lightricks. Acabamos de abrir el código de LTX-2, un modelo audio-vídeo de producción. AMA». Aclaró que el lanzamiento completo incluyó pesos, código, un entrenador, benchmarks, LoRAs y documentación, y que el modelo «corre localmente en GPUs de consumo y alimenta productos reales en Lightricks». El hilo alcanzó 1554 votos y 460 comentarios, y el CEO lo cerró reconociendo que «el volumen de preguntas superó todas las expectativas».
El relato de fondo es la tesis de Lightricks: los modelos generativos «están evolucionando hacia motores de render completos», con entradas como profundidad, normales y vectores de movimiento, y salida hacia pipelines de compositing, VFX, herramientas de animación y motores de juego. Farbman argumenta que «las APIs estáticas no pueden cubrirlo» y que gran parte de ello debe ejecutarse en el borde. Por eso, según su frase repetida, «los pesos abiertos no son un lujo, son la única vía que funciona», y Lightricks se monetiza mediante licencias y un reparto de ingresos cuando quien construye encima supera el umbral de 10 millones de dólares de ingresos anuales.
Filosofía y principios
Abierto por arquitectura, no por caridad: Farbman lo enmarca explícitamente — «no pensamos en los pesos abiertos como caridad o buena voluntad; es el corazón de cómo creemos que deben construirse los motores de render». El objetivo es que el modelo se vuelva infraestructura integrada en pipelines, no una API que se consume.
Uso local y reproducible: «los lanzamientos abiertos de modelos multimodales son raros, y cuando ocurren suelen ser difíciles de ejecutar o reproducir. Construimos LTX-2 para que puedas usarlo de verdad: corre localmente en GPUs de consumo».
Un modelo, capacidades compuestas: audio y vídeo juntos, no como dos modelos pegados; la sincronización es intrínseca al diseño. Entrenable por el usuario: el modelo base (dev) es totalmente entrenable, y se publica el entrenador para que cada uno lleve su propio dataset y afine para su caso; en muchos ajustes, afinar para movimiento, estilo o parecido «puede llevar menos de una hora». Eficiencia como prioridad: el transformer destilado (distilled) corre en muy pocos pasos, y la familia de pipelines separa explícitamente el modo rápido del modo de calidad de producción (DFR).
Cómo funciona
El repositorio se organiza en tres paquetes, cada uno con su propio README y documentación: ltx-core (implementación del modelo, pila de inferencia y utilidades), ltx-pipelines (las rutas de generación de alto nivel: texto-a-vídeo, imagen-a-vídeo y otros modos), y ltx-trainer (herramientas de entrenamiento y afinado — LoRA, ajuste completo e IC-LoRA).
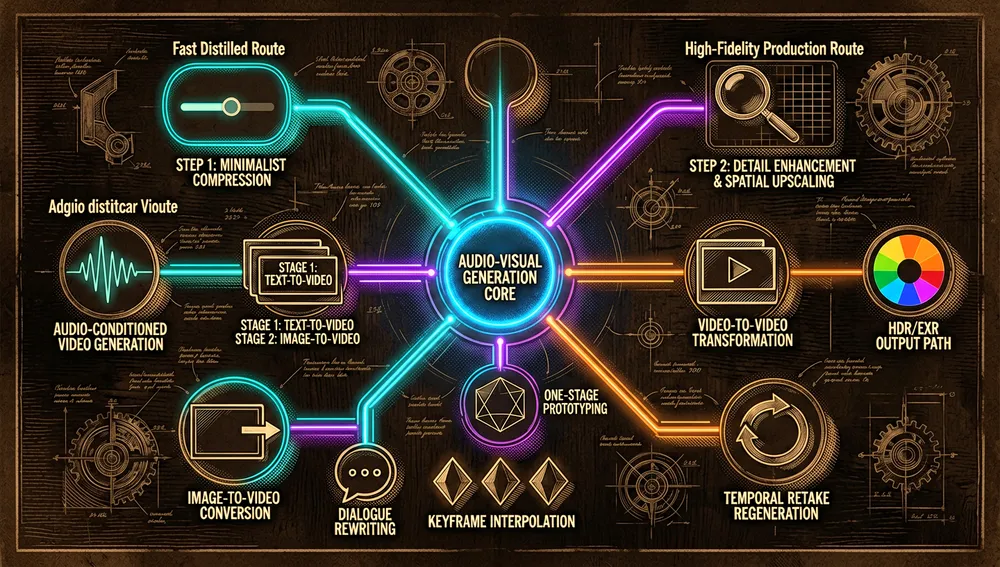
Las pipelines disponibles son el corazón práctico:
DistilledPipeline— el punto de partida rápido: texto/imagen-a-vídeo más veloz (8 sigmas predefinidos: 8 pasos etapa 1, 4 pasos etapa 2).DFRPipeline— calidad de producción (DFR, Diffusion Fidelity Rendering): usa el mismo transformer destilado más un IC-LoRA de detallado; genera fotogramas clave interiores y una pasada de detallado espacial, con opcionalmente 2×/4× en fps.TI2VidTwoStagesPipeline/TI2VidTwoStagesHQPipeline— texto/imagen-a-vídeo guiado de dos etapas con CFG/STG y reescalado 2×.TI2VidOneStagePipeline— generación de una sola etapa para prototipado rápido.ICLoraPipeline— transformación vídeo-a-vídeo e imagen-a-vídeo.KeyframeInterpolationPipeline— interpolación entre imágenes de fotograma clave.A2VidPipelineTwoStage— generación vídeo-a-partir-de-audio condicionada por un archivo de audio de entrada.RetakePipeline— regenera una región temporal concreta de un vídeo existente.HDRICLoraPipeline— vídeo-a-vídeo con salida HDR por IC-LoRA.DubItPipeline— reescritura del diálogo manteniendo la identidad del hablante y los movimientos de los labios.- HDR/EXR nativo — las pipelines estándar aceptan fotogramas EXR con
--hdr {SRGB_LINEAR,ACESCG,ACESCCT}y escriben fotogramas EXR half más un máster BT.2020/HLG.
El entrenador soporta una amplia batería de modos condicionales: texto-a-vídeo, texto-a-audio, imagen-a-vídeo, extensión de vídeo, extensión de audio, inpainting de vídeo y de audio, outpainting de vídeo, IC-LoRA para vídeo/audio/audio-vídeo conjunto, audio-a-vídeo y vídeo-a-audio. Existe además una habilidad de agente (.claude/skills/train-model) que guía un entrenamiento extremo a extremo: explora datos y hardware, elige el modo, prepara/preprocesa el dataset, lanza el entrenamiento y lo supervisa.
El ecosistema
Repositorios de Lightricks (misma organización)
| Repositorio | Stars | Rol |
|---|---|---|
Lightricks/LTX-Video | 10.950 | Repositorio oficial de LTX-Video (el modelo de vídeo en tiempo real anterior, de 2024). |
Lightricks/LTX-2 | 9.411 | Este repositorio: paquete de inferencia y entrenador para LTX-2. |
Lightricks/ComfyUI-LTXVideo | 4.129 | Soporte de LTX-Video/LTX-2 para ComfyUI. |
Lightricks/LTX-Desktop | 1.988 | Aplicación de escritorio de código abierto para generar vídeos con los modelos LTX. |
Lightricks/LTX-Video-Trainer | 468 | Entrenador comunitario para el modelo LTX Video. |
Lightricks/LTX-Video-Q8-Kernels | 82 | Kernels Q8 para LTX-Video. |
Modelos en Hugging Face
Lightricks/LTX-2 — el modelo original (19B: 14B vídeo + 5B audio). Al consultar: 333.852 descargas y 1.779 «me gusta». Pipeline image-to-video, integrado en diffusers como LTX2Pipeline. Lightricks/LTX-2.5 — la versión actual recomendada por el README (transformer 22B + Gemma 4 12B). Al consultar: 1.559.653 descargas y 3.821 «me gusta». Creada el 23 de julio de 2026. Lightricks/LTX-2.5-22b-IC-LoRA-Pixel-Spatial-Upscaler — el IC-LoRA de detallado que exige la pipeline DFR. Los pesos se publican «un archivo por componente», de modo que se descargan solo las piezas que cada pipeline necesita.
Integración con ComfyUI
El README y la ficha del modelo remiten a Lightricks/ComfyUI-LTXVideo y recomiendan usar los nodos LTXVideo integrados en el ComfyUI Manager. Hay también un proyecto de la comunidad, LTXMac (una aplicación nativa para Mac de generación de vídeo por texto, presentada en Show HN en enero de 2026), basada en la familia LTX.
Estado oficial / semioficial
LTX-2 tiene un reconocimiento claro de estándar de facto en el ecosistema open-source de generación de vídeo: está integrado como LTX2Pipeline en la librería oficial diffusers, con documentación dedicada; los nodos LTXVideo están disponibles desde el ComfyUI Manager; Lightricks ofrece LTX-Studio (demo en línea) y una API de pago, y el CEO afirma que el modelo «alimenta productos reales en Lightricks»; y los pesos están en Hugging Face bajo la LTX Community License (no es una licencia OSI; las entidades con ingresos anuales de al menos 10.000.000 de dólares pasan a una rama de la licencia que exige condiciones comerciales).
En la práctica, esto significa que LTX-2 funciona como una referencia de los modelos audio-vídeo abiertos que corren localmente: está en diffusers, en ComfyUI, en una app de escritorio y con una API comercial, pero no hay una «designación formal de estándar» por parte de ningún organismo externo en las fuentes consultadas.
Guía rápida de uso
Instalación y primer arranque
Prerrequisitos: Python ≥ 3.12, CUDA (>12.7 recomendado), PyTorch ~= 2.7, y una GPU con bastante VRAM.
git clone https://github.com/Lightricks/LTX-2.git
cd LTX-2

# El extra `natten` es el backend más rápido para el VAE de vídeo; es solo Linux+CUDA.
uv sync --extra natten

# Descargar el modelo (repositorio LTX-2.5, ~66 GiB)
hf auth login
hf download Lightricks/LTX-2.5 \
    diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
    text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
    vae/ltx-2.5-video-vae-bf16.safetensors \
    vae/ltx-2.5-audio-vae-bf16.safetensors \
    latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
    --local-dir models/ltx-2.5
En el primer arranque, si aparece un 401/403 de Hugging Face, hay que aceptar los términos del modelo e iniciar sesión con un token de lectura.
Flujos de trabajo habituales
1. Texto-a-vídeo rápido (DistilledPipeline). Para generar un clip de arranque:
uv run python -m ltx_pipelines.distilled \
    --transformer-path   models/ltx-2.5/diffusion_models/ltx-2.5-22b-distilled-transformer-bf16.safetensors \
    --text-encoder-path  models/ltx-2.5/text_encoders/gemma4-12b-with-proj-ltx-2.5-bf16.safetensors \
    --video-vae-path     models/ltx-2.5/vae/ltx-2.5-video-vae-bf16.safetensors \
    --audio-vae-path     models/ltx-2.5/vae/ltx-2.5-audio-vae-bf16.safetensors \
    --spatial-upsampler-path models/ltx-2.5/latent_upscale_models/ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors \
    --num-frames 121 --seed 42 --output-path output.mp4 \
    --prompt "..."
El resultado queda en output.mp4. Por defecto son 1024×1536 a 24 fps.
2. Calidad de producción (DFRPipeline). Se reutiliza el mismo download y se añade el IC-LoRA de detallado, ejecutando ltx_pipelines.dfr_pipeline con el flag adicional --detailing-lora. Salida en output_dfr.mp4; la 4K UHD es --width 3840 --height 2176.
3. Vídeo a partir de audio (A2Vid). Se usa A2VidPipelineTwoStage para generar un vídeo condicionado por un archivo de audio de entrada.
4. Doblar/reescribir el diálogo (DubIt). DubItPipeline reescribe el diálogo manteniendo la identidad y los labios del hablante.
Configuración esencial
--num-frames: divisible por 8 más 1; se puede omitir con--auto-duration.--quantization:fp8-cast,fp8-scaled-mm(Hopper+),nvfp4-cast/nvfp4-prequant(Blackwell).--offload {cpu,disk}: para GPUs con poca VRAM.--hdr {SRGB_LINEAR,ACESCG,ACESCCT}: espacio de color para condicionamiento EXR y codificación HDR.- Guía de prompt: el README recomienda prompts cronológicos, literales y de hasta 200 palabras, «como un director de fotografía describiendo una lista de tomas».
Trampas frecuentes y soluciones
- 401/403 al descargar de Hugging Face: aceptar los términos del modelo e iniciar sesión con un token de lectura.
- Resolución y fotogramas: ancho/alto divisibles por 32 y fotogramas por 8+1; la 4K es 3840×2176, no 3840×2160.
nattenes solo Linux+CUDA: en Windows/macOS se omite y se recurre a Triton/eager.- No sustituir el Gemma: el codificador de texto debe ser el Gemma 4 afinado para LTX; el Gemma 4 «stock» de Google no es sustituto.
- OOM al decodificar el VAE: se recomienda
pipe.vae.enable_tiling()en el camino diffusers. - Los pesos no son intercambiables entre LTX-2.3 y LTX-2.5: un LoRA solo funciona con el modelo en que se entrenó.
- El download es ~66 GiB: se descarga por componentes para no tirar de todo.
Integraciones y migración
diffusers: LTX-2 está disponible como LTX2Pipeline y LTX2LatentUpsamplePipeline; migración directa con LTX2Pipeline.from_pretrained("Lightricks/LTX-2", torch_dtype=torch.bfloat16). ComfyUI: mediante Lightricks/ComfyUI-LTXVideo y los nodos LTXVideo del Manager. LTX-Studio/API: para uso en la nube sin gestionar hardware. HDR/EXR hacia VFX: las salidas EXR lineales y el máster BT.2020/HLG facilitan la migración desde flujos tradicionales de compositor.
Métricas actuales
Medición: 14 de septiembre de 2026, API de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 9.411 |
| Bifurcaciones | 1.489 |
Suscriptores (subscribers_count) | 99 |
| Incidencias abiertas | 41 |
Commits en main | 50 (aproximado) |
| Lenguaje principal | Python |
| Licencia | LTX Community License (propia, no OSI) |
| Creación | 3 de enero de 2026 |
| Última actividad (push) | 26 de agosto de 2026 |
| Última publicación | v1.3.0, 26 de agosto de 2026 |
Los principales contribuidores: michaellightricks (26), github-actions[bot] (10), AlexeyKravtsov1987 (1) y Bmantl (1). La API de GitHub usa open_issues_count, que puede incluir solicitudes de cambios abiertas. watchers_count de la respuesta general replica las estrellas; por eso se informa por separado el campo subscribers_count como suscriptores reales.
Cómo contribuir
El README del entrenador documenta un proceso abierto y sencillo: compartir resultados (LoRAs interesantes o buenos resultados con la comunidad), reportar incidencias (abrir un issue en GitHub ante un bug o sugerencia), enviar PRs (arreglos de bugs o mejoras generales), y solicitar funciones (mediante issues de GitHub). La comunidad se coordina principalmente en el Discord oficial, donde el equipo de desarrollo da soporte y se comparten resultados.
Cómo lo recibió la comunidad
En el AMA del CEO (r/StableDiffusion 1q7dzq2, 8 de enero de 2026, 1.554 votos y 460 comentarios), la respuesta más votada de Farbman fue la justificación de los pesos abiertos: «los modelos están evolucionando hacia motores de render completos… los pesos abiertos no son un lujo, son la única vía que funciona. Nos monetizamos mediante licencias y un reparto de ingresos cuando la gente construye productos exitosos encima (trazamos la línea en 10 M$ de ingresos)». Anunció también una versión incremental 2.1 y un salto arquitectónico 2.5.
u/Neex, que se identifica como Niko de Corridor Digital, participó en el hilo y dijo «estás clavando esta respuesta»; luego u/That_Buddy_2928 añadió que el vídeo de la remasterización de Bullet Time de Corridor «fue instrumental para convencer a algunos de mis amigos más escépticos de la validez de la IA en el pipeline». u/SvenVargHimmel planteó si el modelo puede forzarse a generar una sola imagen y si puede exportar mapas de normales o de profundidad como vídeo — señal de que los usuarios ya lo trataban como un motor de render.
En Hacker News, el Show HN más relevante es 47214472 «Show HN: Audio-to-Video with LTX-2» (de runshouse, 2 de marzo de 2026), con 23 puntos y 2 comentarios.
En el subreddit r/StableDiffusion de agosto de 2026, LTX 2.5 domina los hilos de uso local: por ejemplo, «MiniMax H3 Model Copied LTX 2.5’s Best Feature… And It’s CRAZY Fast!» (159 votos, 96 comentarios) y «I Found a way to reduce LTX 2.5’s horrible smearing. Custom node + Workflow» (158 votos, 24 comentarios). Estos hilos dan dos lecturas a la vez: entusiasmo por la calidad y una crítica concreta —el «smearing»/trazado en movimiento— que la comunidad intenta compensar con nodos propios.
La ficha del modelo declara limitaciones explícitas: no está pensado para dar información factual, puede amplificar sesgos, puede fallar en seguir el prompt (muy dependiente del estilo de prompt) y el audio sin voz puede ser de menor calidad.
Comparación con proyectos similares
| Proyecto | Coincidencia verificable | Diferencia verificable |
|---|---|---|
Lightricks/LTX-2.5 (mismo autor) | Misma familia, misma infraestructura; el README la toma como punto de arranque. | Transformer 22B + Gemma 4, nuevo espacio latente; más descargas (1,56 M) que LTX-2 (333 K). Es la evolución, no un competidor. |
| Runway Gen-4 | Generador de vídeo de producción, listado en la guía propia de Lightricks. | Modelo cerrado y en la nube; LTX-2 ofrece pesos abiertos y ejecución local. |
| Google Veo 3.1 | Generador de vídeo con audio, listado en la misma guía. | Cerrado, de Google; LTX-2 es abierto y local. |
| Kling 3.0 | Vídeo de alta calidad, listado en la guía propia. | Cerrado; LTX-2 se integra en diffusers/ComfyUI. |
| Pika 2.2 | Generador de vídeo creativo, listado en la guía propia. | Cerrado, consumo por API; LTX-2 es local y entrenable. |
| MiniMax H3 | Generador de pesos abiertos, comparado repetidamente con LTX 2.5 en r/StableDiffusion. | Lightricks lo describe como el que «copió la mejor característica de LTX 2.5»; es un rival directo del campo abierto. |
La comparación más útil no es por popularidad: LTX-2 destaca cuando se quiere un modelo audio-vídeo abierto y local que se integre en diffusers/ComfyUI y sea entrenable; un generador cerrado en la nube puede ser preferible cuando no se dispone de hardware propio.
Casos de uso
- Creadores y productoras que quieren audio-vídeo local y controlado: el par vídeo+audio sincronizado (con
A2VidPipelineTwoStageyDubItPipeline) sirve a quien hace contenido con diálogo sin un paso separado de doblaje ni de efectos. - Equipos de VFX y postproducción: las salidas HDR/EXR y
RetakePipelineestán pensadas para entrar en pipelines de color grading y compositor sin un intermediario con pérdida.
- Investigadores y equipos de ML que afinan modelos: el
ltx-trainery la habilidad de agentetrain-modelpermiten llevar un dataset propio y afinar estilo, movimiento o parecido, a veces «en menos de una hora». - Desarrolladores que integran modelos generativos en software: la integración en diffusers y ComfyUI permite embeber LTX-2 en aplicaciones y flujos existentes.
- Personas con GPUs de consumo: la variante distilled y las opciones
--quantization/--offloadestán orientadas a que el modelo corra localmente en GPUs de consumo.
Recursos
- Repositorio: https://github.com/Lightricks/LTX-2
- Hugging Face: https://huggingface.co/Lightricks/LTX-2 y https://huggingface.co/Lightricks/LTX-2.5
- Paper técnico: https://arxiv.org/abs/2601.03233
- Comunidad / Discord: https://discord.gg/ltxplatform
- Demo en línea: https://app.ltx.studio/ltx-2-playground/t2v
- AMA del CEO: https://www.reddit.com/r/StableDiffusion/comments/1q7dzq2/
- HN: https://news.ycombinator.com/item?id=47214472
- diffusers: https://huggingface.co/docs/diffusers/main/en/api/pipelines/ltx2
- Blog / guía de prompting: https://ltx.io/blog
Nota: este artículo combina el README del repositorio, la ficha del modelo en Hugging Face, el paper arXiv:2601.03233, el AMA del CEO en Reddit, notas de versión (v1.2.0, v1.3.0), la API de GitHub y resultados de Hacker News y Reddit consultados el 14 de septiembre de 2026. Las cifras de estrellas, descargas y votos cambian con el tiempo.
Comentarios