

OpenDataLoader PDF: un parser de PDF para datos listos para IA
opendataloader-project/opendataloader-pdf · 29.370★ · 2.799 forks
Todo lo que hay que saber sobre opendataloader-project/opendataloader-pdf: un parser de PDF de código abierto, escrito principalmente en Java, que convierte documentos PDF en Markdown, JSON (con cajas delimitadoras) y HTML para pipelines de RAG y LLM, y además automatiza la accesibilidad etiquetando PDFs sin estructura hacia Tagged PDF. Es un proyecto de Hancom Inc. (Corea) desarrollado junto a la PDF Association y Dual Lab (creadores de veraPDF).
Origen
La organización opendataloader-project se creó el 12 de mayo de 2025 (el repositorio, el 13 de mayo de 2025) y su perfil la sitúa en Corea del Sur, con 339 seguidores y 6 repositorios públicos. El principal contribuidor, bundolee (Bundo Lee), acumula 562 commits (frente a 75 de cada uno de MaximPlusov y LonelyMidoriya), su perfil indica Seúl y su campo de empresa es «Hancom Inc. @opendataloader-project». Hancom es una compañía surcoreana de software de ofimática y documentos (autora del formato HWP), lo que da al proyecto un origen corporativo claro: no es un experimento individual sino una apuesta de una empresa del sector documental.
La tracción pública visible arrancó en torno a septiembre de 2025, cuando el hilo de Hacker News de referencia (109 puntos, 28 comentarios) enlazó el repositorio. El salto a la versión v2.0 —que introduce el motor híbrido, la licencia Apache 2.0 y las integraciones de Llama/LangChain— se difundió en marzo de 2026. La última versión medida en esta ejecución es v2.5.2, publicada el 21 de agosto de 2026.
El README documenta un cambio de licencia relevante: las versiones anteriores a 2.0 se distribuían bajo Mozilla Public License 2.0 y desde la 2.0 bajo Apache 2.0, una decisión justificada en el propio FAQ para evitar el copyleft por archivo de MPL y facilitar la adopción empresarial.
Filosofía y principios
El README resume la propuesta en dos bloques que definen sus principios:
- Datos listos para IA, no solo texto: el objetivo es producir estructura (orden de lectura, jerarquía de encabezados, tablas, coordenadas) que los LLMs y los pipelines de RAG necesitan, no únicamente texto plano. El mensaje del sitio es explícito: «Si los datos no se parsean bien, tu sistema RAG nunca recuperará respuestas correctas. basura entrante = basura saliente».
- Local-first y sin nube: el README y el sitio insisten en que todo se ejecuta localmente, sin llamadas a la nube ni claves de API; «tu documento nunca sale de tu entorno». La versión 2.0 lo enmarca como utilizable en entornos totalmente aislados (air-gapped), eliminando el riesgo de fuga de datos.
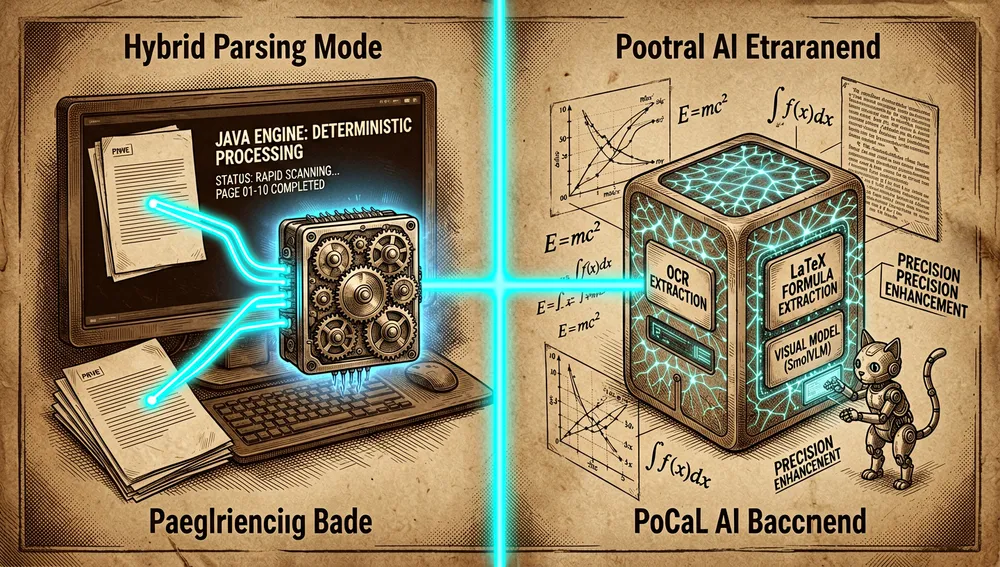
- Determinismo local + híbrido inteligente: el modo local es determinista (reglas, sin GPU, sin modelos), y un modo híbrido enruta solo las páginas complejas (tablas difíciles, escaneados, fórmulas, gráficos) a un backend de IA local.
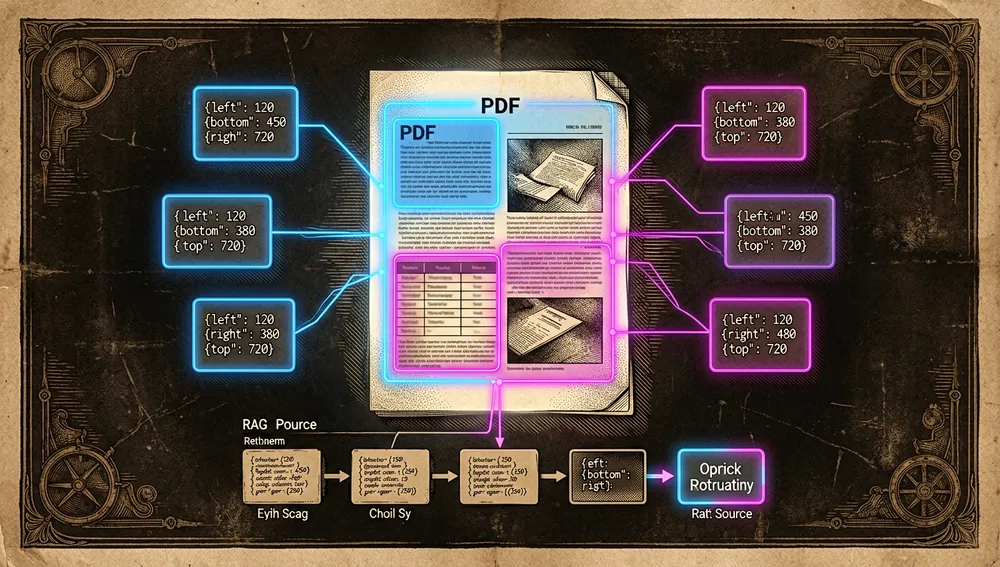
- Coordinadas para cada elemento: cada elemento extraído lleva una caja delimitadora
[left, bottom, right, top]en puntos PDF, lo que habilita citas de fuente y «clic a la fuente» en RAG. - Accesibilidad como primera clase, no como añadido: el proyecto se presenta como el primero de código abierto que genera Tagged PDF de extremo a extremo, construido sobre la especificación Well-Tagged PDF de la PDF Association y validado con veraPDF.
Cómo funciona
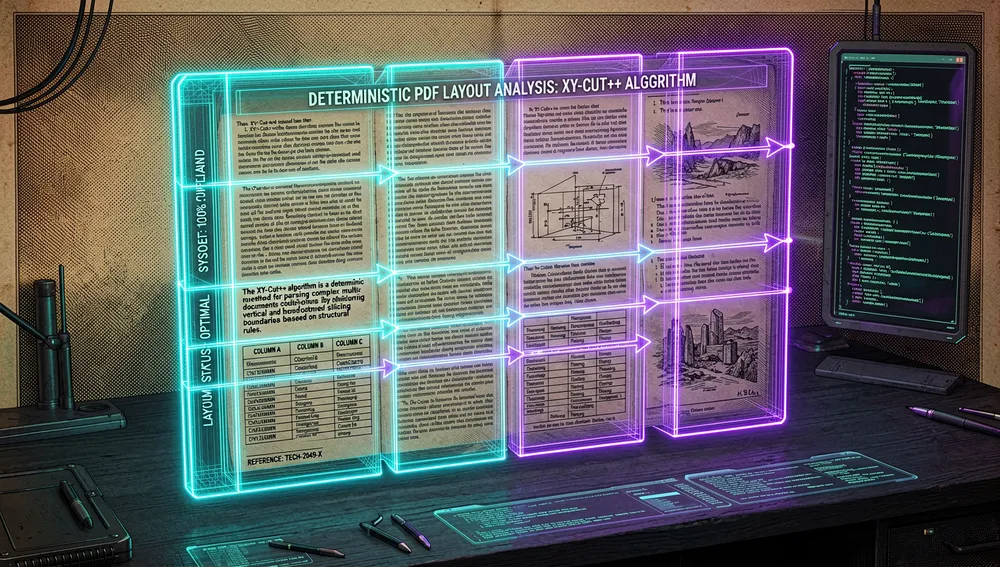
La entrada es un PDF (digital, escaneado o ya etiquetado) y las salidas son Markdown, JSON (con cajas delimitadoras), HTML, Tagged PDF y, como complemento de pago, PDF/UA. El núcleo es un parser determinista en Java que aplica un análisis de layout y un orden de lectura XY-Cut++ (secuencia correcta en páginas multicolumna, barras laterales y layouts mixtos).
Dos modos documentados en el README:
- Local (por defecto, rápido):
opendataloader-pdf archivo1.pdf carpeta/. Extrae texto con orden de lectura, tablas (bordes), encabezados, listas e imágenes, y calcula cajas delimitadoras. El README indica 60+ páginas/segundo en CPU; con procesamiento por lotes multiproceso, más de 100 páginas/segundo en máquinas de 8+ núcleos (medido en Apple M4). - Híbrido: combina el núcleo Java con un backend de IA local. Las páginas simples se procesan localmente; las complejas se envían al backend para subir precisión (el README cita +90 % en precisión de tablas: de 0.489 a 0.928 TEDS). Requiere arrancar un servidor (
opendataloader-pdf-hybrid --port 5002) y llamar al cliente con--hybrid docling-fast. Admite OCR (80+ idiomas) para PDFs escaneados, extracción de fórmulas LaTeX y descripción de gráficos/imágenes (modelo SmolVLM de 256M).
Otros mecanismos documentados: soporte de Tagged PDF, que si el PDF ya tiene etiquetas de estructura, extrae el layout exacto del autor sin heurísticas; y auto-etiquetado hacia Tagged PDF, que analiza el layout y genera las etiquetas de estructura para un PDF sin etiquetar, bajo Apache 2.0 (la conversión a PDF/UA-1/2 y el editor visual son complementos de pago).
Seguridad para IA (anti-inyección): filtra automáticamente texto oculto (fuentes transparentes, de tamaño cero), contenido fuera de página y capas invisibles sospechosas. Con --sanitize además sustituye datos sensibles (correos, URLs, teléfonos) por marcadores.
Guía rápida de uso
Instalación y primer arranque
Requisitos: Java 11+ (verificar con java -version; si falta, instalar un JDK 11+ desde Adoptium) y Python 3.10+.
pip install -U opendataloader-pdfimport opendataloader_pdf
# Agrupa todos los archivos en una sola llamada: cada convert() lanza un proceso JVM,
# por lo que llamarlo en un bucle es lento
opendataloader_pdf.convert(
input_path=["file1.pdf", "file2.pdf", "carpeta/"],
output_dir="salida/",
format="markdown,json"
)Para el modo híbrido (tablas complejas, escaneados, fórmulas): pip install "opendataloader-pdf[hybrid]". También hay SDK de Node.js (npm install @opendataloader/pdf) y Java (Maven org.opendataloader:opendataloader-pdf-core).
Flujos de trabajo habituales
- Para extraer a Markdown + JSON para RAG:
opendataloader_pdf.convert(input_path=[...], output_dir="salida/", format="markdown,json"); el resultado queda ensalida/con Markdown listo para trocear y JSON con cajas delimitadoras para citas. - Para un PDF escaneado u otro idioma: arrancar el backend con OCR —
opendataloader-pdf-hybrid --port 5002 --force-ocr --ocr-lang "ko,en"— y procesar conopendataloader-pdf --hybrid docling-fast archivo.pdf. - Para fórmulas o descripciones de gráficos: backend con
--enrich-formulao--enrich-picture-description, y cliente con--hybrid-mode full(la ampliación de fórmulas y gráficos exige este modo). - Para acceder a un PDF sin etiquetar (accesibilidad):
opendataloader-pdf --format tagged-pdf archivo.pdf, o en Pythonformat="tagged-pdf".
Configuración esencial
No hay un archivo de configuración central: la «configuración» son los parámetros de convert() / de la CLI. Los que un usuario nuevo toca primero: format (markdown, json, html, pdf, text o tagged-pdf; combinables), hybrid (activa el modo híbrido), output_dir (carpeta de salida), use_struct_tree (usa las etiquetas de estructura nativas del PDF) e image_output/image_format (off, embedded o external, con png/jpeg).
Trampas frecuentes y soluciones
- Cada
convert()lanza un proceso JVM: las llamadas repetidas en un bucle son lentas; agrupar todos los archivos en una única llamada aconvert(). --use-struct-treetiene prioridad sobre--hybrid: si ambos se fijan en un PDF etiquetado, se usa el árbol de estructura y no se llama al backend híbrido; para usar el híbrido, quitar--use-struct-tree.- La calidad depende de la calidad de las etiquetas: los PDFs mal etiquetados producen peor resultado; con etiquetas escasas o incorrectas, el modo heurístico o
--hybrid docling-fastsuelen dar mejor calidad. - Fórmulas y descripciones de gráficos exigen
--hybrid-mode fullen el cliente; sin ese modo la ampliación no se aplica. - Falta Java: si
java -versionno responde, la instalación Python funciona como wrapper pero el motor necesita el JDK; instalar Java 11+. - Limitación de lenguaje (comunidad): un usuario de HN (
hermitcrab) señaló que, al ser Java/Python, no encaja con quien necesita llamarlo desde C++; no existe un enlace nativo C++ documentado. - Cifras de benchmark autoinformadas: los puntajes de «número 1» proceden del arnés propio del proyecto (
opendataloader-bench); el repositorio lo publica para que otros lo reproduzcan, pero no es una evaluación independiente.
Integraciones y migración
- LangChain: integración oficial documentada —
pip install -U langchain-opendataloader-pdfyOpenDataLoaderPDFLoader(file_path=[...], format="text"). - LlamaIndex: lector oficial de la organización (
opendataloader-project/opendataloader-pdf-llamaindex), «lectura rápida, precisa y local de PDFs». - Backend híbrido local: no requiere nube ni claves; el servidor
opendataloader-pdf-hybridcorre en la misma máquina. - Migración desde otros parsers: el README se posiciona como sustituto de herramientas como
pdf2docx(un usuario de HN cuenta haber migrado «para reemplazar pdf2docx … y es mucho mejor»). Frente a docling, marker o pymupdf4llm, el README destaca las cajas delimitadoras por defecto y los filtros de inyección, que esos proyectos no ofrecen por defecto. No existe un proceso formal de migración: es reconfigurar la llamada de conversión haciaconvert().
El ecosistema
Repositorios de la misma organización opendataloader-project: opendataloader-bench (83 estrellas, el arnés de evaluación propio, mide orden de lectura NID, fidelidad de tablas TEDS y jerarquía de encabezados MHS sobre un corpus de ~200 PDFs reales), langchain-opendataloader-pdf (59 estrellas, cargador de documentos para LangChain), opendataloader-pdf-llamaindex (3 estrellas, lector para LlamaIndex), opendataloader-pdf-examples (2 estrellas, ejemplos de uso) y .github (1 estrella).
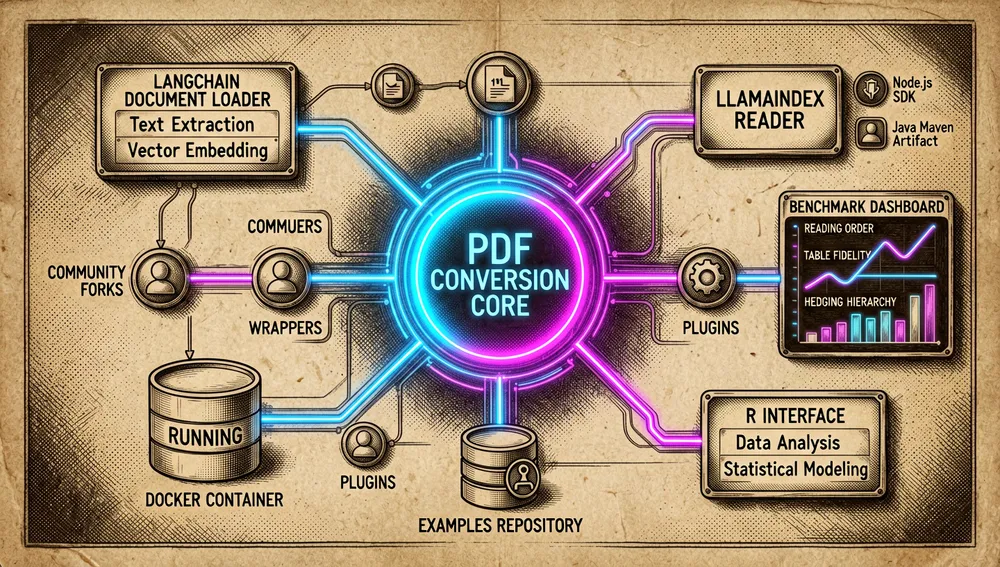
Proyectos y derivaciones de la comunidad (búsqueda de repositorios de GitHub por «opendataloader»): NameetP/pdfmux (81 estrellas, Python, creado marzo 2026) es un extractor de PDF que «audita su propia salida y certifica la de otros extractores», que obtiene 0.903 en opendataloader-bench (2.º de 8 motores) y expone un servidor MCP de 7 herramientas — el proyecto relacionado más notable, ya que compite contra el mismo benchmark que OpenDataLoader. muschellij2/opendataloader (0 estrellas, R, abril 2026) es una interfaz de R hacia OpenDataLoader PDF. coryisakson/opendataloader_docker (4 estrellas) es un empaquetado Docker autoalojado. dpaidev/opendataloader-pdf (2 estrellas) es un espejo completo con historial. JamoCA/cfml-OpenDataLoader-demo (1 estrella) y longshines/pdf-parser-online (0) son demos/wrappers web.
La mayor parte de los demás resultados son espejos, forks personales o de 0 estrellas. Nota de desambiguación: AstunTechnology/OpenDataLoader (7 estrellas) es un proyecto diferente («utility para cargar OpenData en PostGIS»); su coincidencia de nombre es accidental y no se relaciona con este repositorio.
Estado oficial / semioficial
No hay un «marketplace» de vendor al estilo de los plugins de agentes, pero el proyecto tiene un estatus semioficial sólido apoyado en estándares y un respaldo corporativo: colaboración con organismos de estándar (el README y el sitio declaran que la auto-etiquetación se construyó en colaboración con la PDF Association, autora de la especificación Well-Tagged PDF, y con Dual Lab, desarrolladores de veraPDF, el validador de referencia abierto para PDF/A y PDF/UA); respaldo de Hancom Inc. (el principal contribuidor figura en la empresa Hancom; el README anuncia la integración empresarial Hancom Data Loader —análisis de documentos con modelos personalizados, OCR con SLA y soporte nativo de HWP/HWPX— como próximo paso, roadmap Q2–Q3 2026); integraciones «oficiales» de terceros (aparece en la documentación oficial de integraciones de LangChain y mantiene un lector oficial de LlamaIndex); y un modelo open-core (el núcleo es Apache 2.0 y gratuito; los complementos empresariales —exportación PDF/UA-1/2 y estudio/editor visual de accesibilidad— son de pago bajo solicitud).
El proyecto se autoproclama «el único parser de código abierto» que combina extracción determinista local, cajas delimitadoras por elemento, XY-Cut++, filtros de seguridad de IA y soporte de Tagged PDF, y se posiciona como «número 1 del benchmark». Eso es una afirmación del proyecto apoyada en su propio arnés (opendataloader-bench), no una designación formal de estándar; no se recuperó en esta ejecución una certificación externa independiente.
Números del repo
Medición: 21–22 de agosto de 2026, API de GitHub.
| Métrica | Valor |
|---|---|
| Estrellas | 28.641 |
| Bifurcaciones | 2.734 |
| Suscriptores reales | 111 |
| Commits | 861 |
| Incidencias + PR abiertos | 77 |
| Lenguaje principal | Java |
| Licencia | Apache-2.0 (pre-2.0: MPL 2.0) |
| Creación | 13 de mayo de 2025 |
| Último push | 21 de agosto de 2026 |
| Última publicación | v2.5.2, 21 de agosto de 2026 |
Top contribuyentes por contribuciones: bundolee (562), MaximPlusov (75), LonelyMidoriya (75), hyunhee-jo (58), hnc-jglee (19), dependabot[bot] (16), suji-cho (16).
Descargas de registro: PyPI opendataloader-pdf (última versión 2.5.2, 69 releases) con 44.408 descargas la última semana y 191.684 el último mes. npm @opendataloader/pdf con 54.297 descargas en el rango 22 jul–22 ago 2026. La distribución Java es vía Maven (org.opendataloader:opendataloader-pdf-core).
watchers_count replica las estrellas, por lo que se informa subscribers_count como suscriptores reales. open_issues_count incluye solicitudes de cambios abiertas, no solo incidencias. Las cifras de descargas de registro son métricas de entrega, no un conteo de usuarios o despliegues únicos.
Cómo lo recibió la comunidad
La conversación verificable se concentra en un hilo de Hacker News; el resto de envíos tienen muy poca tracción.
Hacker News (109 puntos, 28 comentarios, «OpenDataLoader-PDF: An open source tool for structured PDF parsing», 23 de septiembre de 2025) reunió opiniones concretas. 4d66ba06 (elogio y adopción): «acabo de terminar de migrar a esto para reemplazar pdf2docx en un proyecto en el que estaba trabajando y es mucho mejor. Gracias por abrir el código de OpenDataLoader-PDF». emilburzo (práctica): lo probó con extractos bancarios, «PDFs que son sorprendentemente difíciles… la extracción JSON se ve bastante bien y parece producir algo usable en una sola pasada». fedeb95 (uso fuera de IA): «Muy cool. Probablemente lo usaré, pero no para IA. Tengo muchos PDFs para los que no existe un epub». agsqwe preguntó cómo se compara con docling. hermitcrab (objeción técnica): «me emocioné hasta que leí que era Java/Python. Busco una librería que extraiga tablas de PDF y se pueda llamar desde un programa C++». trevor-e (crítica de fondo) defiende que «quizá necesitamos un nuevo formato de archivo amigable con la IA en lugar de seguir parcheando sobre la complicada especificación de PDF». constantinum mencionó Unstract (Zipstack/unstract) como alternativa abierta de extracción estructurada + ETL.
Otros envíos de baja tracción no constituyen reseña amplia: «Show HN: OpenDataLoader – Safe, Open, High-Performance PDF Loader for AI» (4 puntos), sobre v2.0 (1 punto) y «LLM Is Not a PDF Parser: Use OpenDataLoader First» (2 puntos). Fuera de HN no se recuperó evidencia comunitaria adicional verificable en esta ejecución.
OpenDataLoader PDF frente a otros proyectos
Los valores de la tabla proceden del arnés propio del proyecto, opendataloader-bench (orden de lectura NID, tablas TEDS, encabezados MHS, sobre ~200 PDFs); son autoinformados por el proyecto, no una evaluación independiente. La velocidad es en segundos/página (menor es mejor).
| Proyecto | Puntuación global (bench propio) | Velocidad (s/página) | Diferencia verificable |
|---|---|---|---|
| opendataloader [híbrido] | 0.907 | 0.463 | Motor híbrido local; cajas delimitadoras por elemento; filtros de inyección; Apache 2.0. |
| nutrient | 0.885 | 0.008 | Motor comercial; el más rápido del arnés. |
| docling | 0.882 | 0.762 | MIT; según el README carece de cajas delimitadoras y filtros de inyección por defecto. |
| marker | 0.861 | 53.932 | GPL-3.0; el README lo describe como mucho más lento (≈54 s/página). |
| unstructured [hi_res] | 0.841 | 3.008 | Apache-2.0; también existe unstructured estándar (0.686). |
| edgeparse | 0.837 | 0.036 | Apache-2.0. |
| opendataloader (modo local) | 0.831 | 0.015 | La variante sin IA, muy rápida; peor en tablas (0.489). |
| mineru | 0.831 | 5.962 | AGPL-3.0 (opendatalab/MinerU). |
| pymupdf4llm | 0.732 | 0.091 | AGPL-3.0; rápido pero peor en tablas (0.401) y encabezados (0.412). |
| markitdown | 0.589 | 0.114 | MIT. |
| liteparse | 0.576 | 1.061 | Apache-2.0. |
En la práctica, el diferenciador que el propio proyecto sostiene es la combinación de extracción local determinista + cajas delimitadoras por elemento + auto-etiquetado a Tagged PDF; un motor comercial (nutrient) o un parser rápido (pymupdf4llm) puede ganar en velocidad, y un parser con GPU (marker, docling) es competitivo en calidad, pero según el arnés del proyecto ninguno combina todas esas capacidades en modo local.
Cómo contribuir
CONTRIBUTING.md documenta un proceso explícito: bifurcar el repositorio y clonar el fork; crear una rama de trabajo (git checkout -b mi-caracteristica); construir el proyecto (prerrequisitos: Java 11+, Maven, Python 3.10+, uv, Node.js 24 LTS activo y pnpm vía corepack enable pnpm; la CI compila contra Node 24 y pnpm 11.21.0, y Node debe ser ≥22.13); para preguntas, abrir un issue con la etiqueta Question; para errores, usar la plantilla de Bug Report; para propuestas, la plantilla de Feature Request.
Casos de uso y a quién puede ayudar este repositorio
- Equipos que construyen pipelines RAG / LLM sobre documentos PDF: la extracción a Markdown (orden de lectura, tablas, encabezados) y a JSON con cajas delimitadoras permite troceo semántico y citas «clic a la fuente». El modo híbrido local cubre tablas complejas y escaneados sin enviar datos a la nube — relevante para sectores con datos sensibles (legal, salud, finanzas).
- Organizaciones que deben cumplir normativas de accesibilidad (EAA de la UE, ADA/Section 508 en EE. UU., Digital Inclusion Act de Corea): el pipeline auditar → auto-etiquetar → Tagged PDF (gratuito, Apache 2.0) sustituye parte de la reparación manual (que el README cuantifica en 50–200 USD por documento); el validado con veraPDF lo hace adecuado para equipos de cumplimiento.
- Procesamiento de PDFs escaneados o multilingües: el OCR híbrido (80+ idiomas) sirve a quien convierte archivos digitalizados o documentos en coreano/japonés/chino/árabe; el origen coreano de Hancom explica el soporte nativo de HWP anunciado.
- Científicos y técnicos que extraen fórmulas y gráficos: la extracción de fórmulas LaTeX y la descripción de gráficos/imágenes cubren artículos científicos y documentos técnicos donde la calidad de tablas y ecuaciones importa.
- Desarrolladores que integran en frameworks existentes: los cargadores oficiales de LangChain y LlamaIndex permiten insertar OpenDataLoader como fuente de documentos en pipelines ya montados.
- Quien NO es su público: quien necesite un enlace nativo C++, quien exija un benchmark de validación totalmente independiente, o quien requiera PDF/UA sin el complemento de pago.
Recursos
- Repositorio: https://github.com/opendataloader-project/opendataloader-pdf
- Sitio y documentación oficial: https://opendataloader.org
- Arnés de benchmark oficial: https://github.com/opendataloader-project/opendataloader-bench
- Integración oficial LangChain: https://docs.langchain.com/oss/python/integrations/document_loaders/opendataloader_pdf
- Lector oficial LlamaIndex: https://github.com/opendataloader-project/opendataloader-pdf-llamaindex
- Registros de paquetes: PyPI https://pypi.org/project/opendataloader-pdf/ · npm https://www.npmjs.com/package/@opendataloader/pdf
Nota: este informe combina el README, CONTRIBUTING.md, la documentación y el arnés de benchmark del repositorio (rama main), la API de GitHub, PyPI/npm y resultados de Hacker News consultados el 21–22 de agosto de 2026. Los puntajes de benchmark son autoinformados por el proyecto vía opendataloader-bench. Las cifras cambian con el tiempo.
Comentarios