

OpenDataLoader PDF: ein PDF-Parser für KI-taugliche Daten
opendataloader-project/opendataloader-pdf · 29.370★ · 2.799 forks
Alles Wissenswerte über opendataloader-project/opendataloader-pdf: ein quelloffener PDF-Parser, größtenteils in Java geschrieben, der PDF-Dokumente in Markdown, JSON (mit Begrenzungsrahmen) und HTML für RAG- und LLM-Pipelines umwandelt und zusätzlich Barrierefreiheit automatisiert, indem er strukturlose PDFs in Tagged PDF etikettiert. Es ist ein Projekt von Hancom Inc. (Korea), entwickelt zusammen mit der PDF Association und Dual Lab (den Machern von veraPDF).
Ursprung
Die Organisation opendataloader-project wurde am 12. Mai 2025 erstellt (das Repository am 13. Mai 2025), und ihr Profil verortet sie in Südkorea, mit 339 Followern und 6 öffentlichen Repositories. Der Hauptmitwirkende, bundolee (Bundo Lee), hat 562 Commits angesammelt (gegenüber je 75 bei MaximPlusov und LonelyMidoriya), sein Profil gibt Seoul an, und sein Firmenfeld lautet „Hancom Inc. @opendataloader-project”. Hancom ist ein südkoreanisches Büro- und Dokumentensoftware-Unternehmen (Urheber des HWP-Formats), was dem Projekt einen klaren Unternehmensursprung verleiht: Es ist kein individuelles Experiment, sondern eine Wette eines Unternehmens der Dokumentenbranche.
Die sichtbare öffentliche Traktion begann um September 2025, als der Referenz-Hacker-News-Thread (109 Punkte, 28 Kommentare) auf das Repository verlinkte. Der Sprung zu Version v2.0 — die die Hybrid-Engine, die Apache-2.0-Lizenz und die Llama/LangChain-Integrationen einführte — verbreitete sich im März 2026. Die in diesem Durchlauf gemessene neueste Version ist v2.5.2, veröffentlicht am 21. August 2026.
Das README dokumentiert einen relevanten Lizenzwechsel: Versionen vor 2.0 wurden unter der Mozilla Public License 2.0 vertrieben, ab 2.0 unter Apache 2.0 — eine Entscheidung, die das FAQ damit begründet, das dateibasierte Copyleft von MPL zu vermeiden und die Unternehmensadoption zu erleichtern.
Philosophie und Prinzipien
Das README fasst den Vorschlag in zwei Blöcken zusammen, die seine Prinzipien definieren:
- KI-taugliche Daten, nicht nur Text: Das Ziel ist es, Struktur zu erzeugen (Lesereihenfolge, Überschriftenhierarchie, Tabellen, Koordinaten), die LLMs und RAG-Pipelines benötigen, nicht nur reinen Text. Die Botschaft der Website ist explizit: „Wenn deine Daten nicht gut geparst werden, wird dein RAG-System nie korrekte Antworten abrufen. Garbage in = Garbage out.”
- Local-first und ohne Cloud: Das README und die Website betonen, dass alles lokal läuft, ohne Cloud-Aufrufe oder API-Schlüssel; „dein Dokument verlässt nie deine Umgebung”. Version 2.0 rahmt dies als nutzbar in vollständig isolierten (air-gapped) Umgebungen und eliminiert das Risiko von Datenlecks.
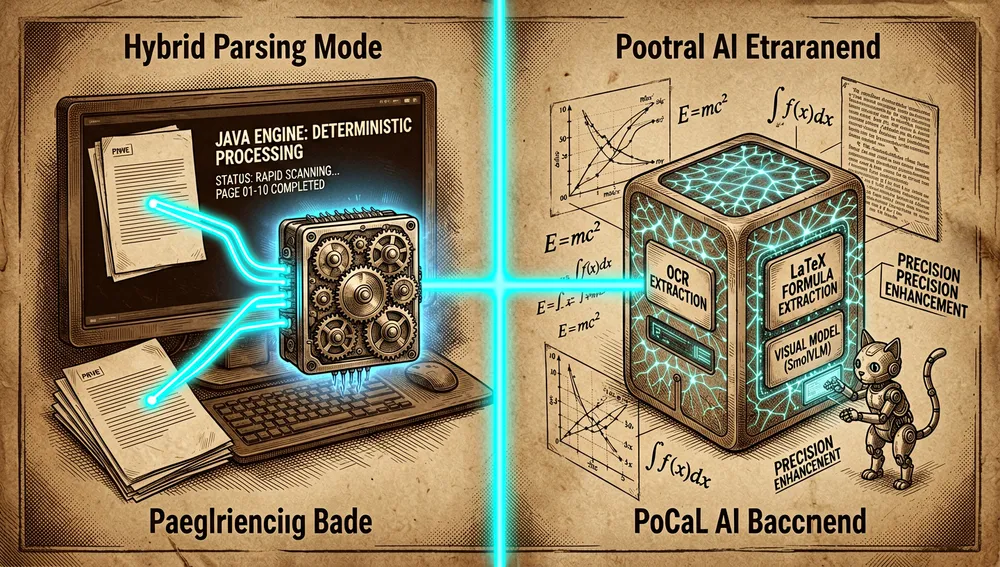
- Lokaler Determinismus + intelligentes Hybrid: Der lokale Modus ist deterministisch (Regeln, keine GPU, keine Modelle), und ein Hybridmodus leitet nur komplexe Seiten (schwierige Tabellen, Scans, Formeln, Diagramme) an ein lokales KI-Backend weiter.
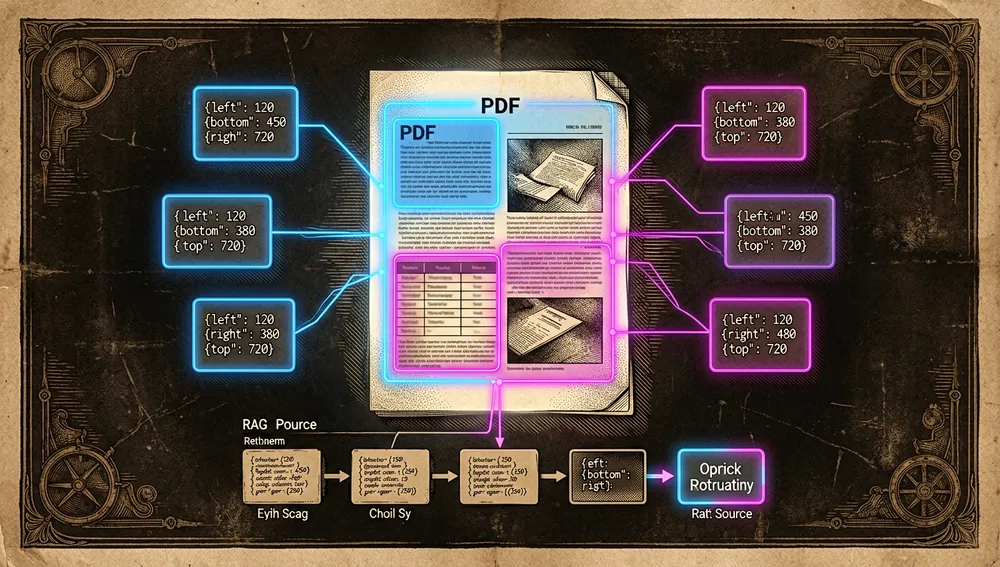
- Koordinaten für jedes Element: Jedes extrahierte Element trägt einen Begrenzungsrahmen
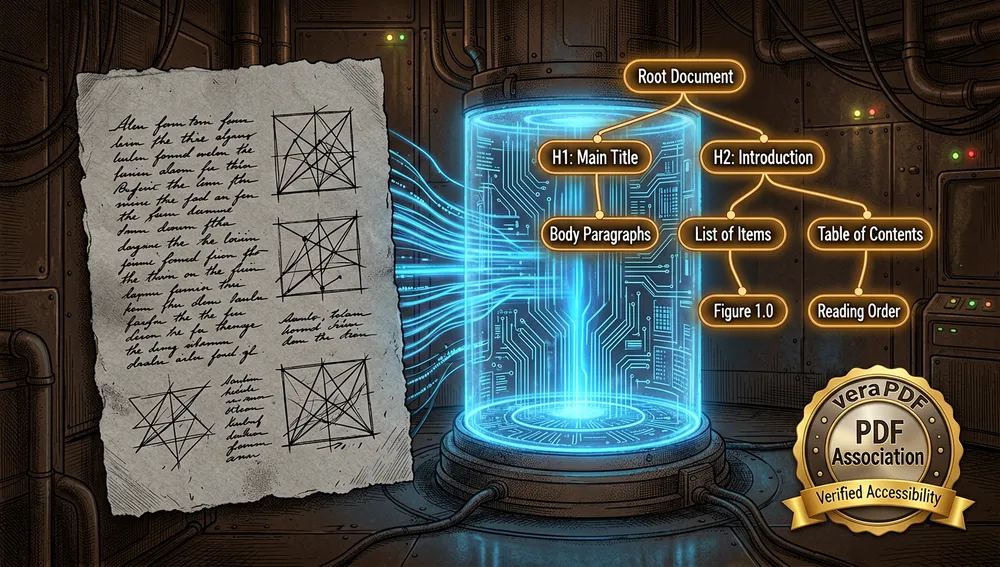
[left, bottom, right, top]in PDF-Punkten, was Quellenzitate und „Klick zur Quelle” in RAG ermöglicht. - Barrierefreiheit als erstklassiges Merkmal, kein Zusatz: Das Projekt präsentiert sich als das erste quelloffene, das durchgängig Tagged PDF generiert, aufgebaut auf der Well-Tagged-PDF-Spezifikation der PDF Association und validiert mit veraPDF.
Wie es funktioniert
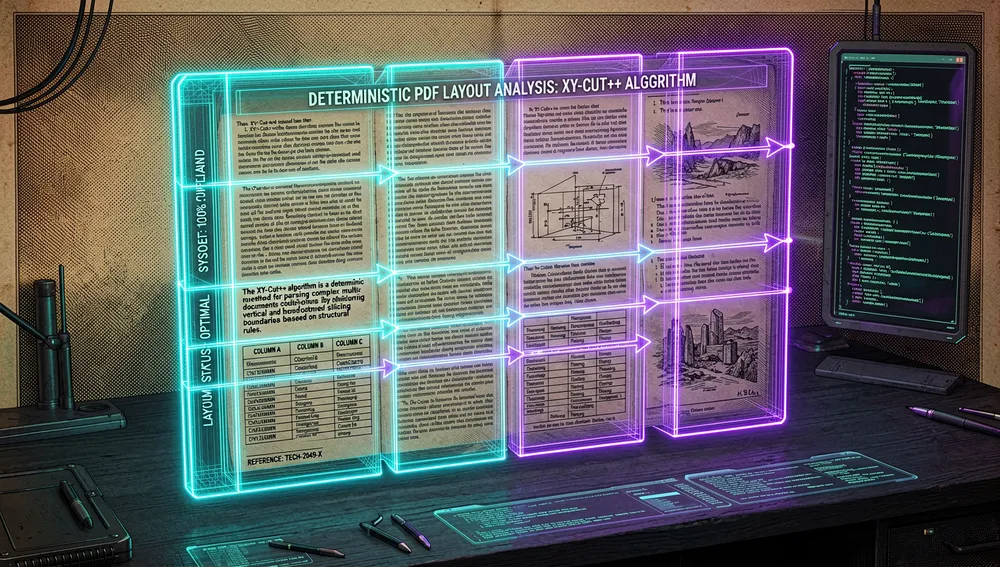
Die Eingabe ist ein PDF (digital, gescannt oder bereits etikettiert), und die Ausgaben sind Markdown, JSON (mit Begrenzungsrahmen), HTML, Tagged PDF und, als kostenpflichtiges Add-on, PDF/UA. Der Kern ist ein deterministischer Java-Parser, der eine Layout-Analyse und eine XY-Cut++-Lesereihenfolge anwendet (korrekte Sequenz über mehrspaltige Seiten, Seitenleisten und gemischte Layouts).
Zwei im README dokumentierte Modi:
- Lokal (standardmäßig, schnell):
opendataloader-pdf datei1.pdf ordner/. Extrahiert Text mit Lesereihenfolge, Tabellen (Rahmen), Überschriften, Listen und Bildern und berechnet Begrenzungsrahmen. Das README nennt 60+ Seiten/Sekunde auf CPU; mit Multi-Thread-Stapelverarbeitung über 100 Seiten/Sekunde auf Maschinen mit 8+ Kernen (gemessen auf Apple M4). - Hybrid: kombiniert den Java-Kern mit einem lokalen KI-Backend. Einfache Seiten werden lokal verarbeitet; komplexe werden zur Genauigkeitssteigerung an das Backend gesendet (das README nennt +90 % Verbesserung der Tabellengenauigkeit: von 0,489 auf 0,928 TEDS). Erfordert das Starten eines Servers (
opendataloader-pdf-hybrid --port 5002) und den Aufruf des Clients mit--hybrid docling-fast. Unterstützt OCR (80+ Sprachen) für gescannte PDFs, LaTeX-Formelextraktion und Diagramm-/Bildbeschreibung (ein SmolVLM-Modell mit 256M).
Weitere dokumentierte Mechanismen: Tagged-PDF-Unterstützung, bei der, wenn das PDF bereits Strukturetiketten hat, das exakte Layout des Autors ohne Heuristiken extrahiert wird; und Auto-Etikettierung zu Tagged PDF, die das Layout analysiert und Strukturetiketten für ein nicht etikettiertes PDF generiert, unter Apache 2.0 (die Konvertierung zu PDF/UA-1/2 und der visuelle Editor sind kostenpflichtige Add-ons).
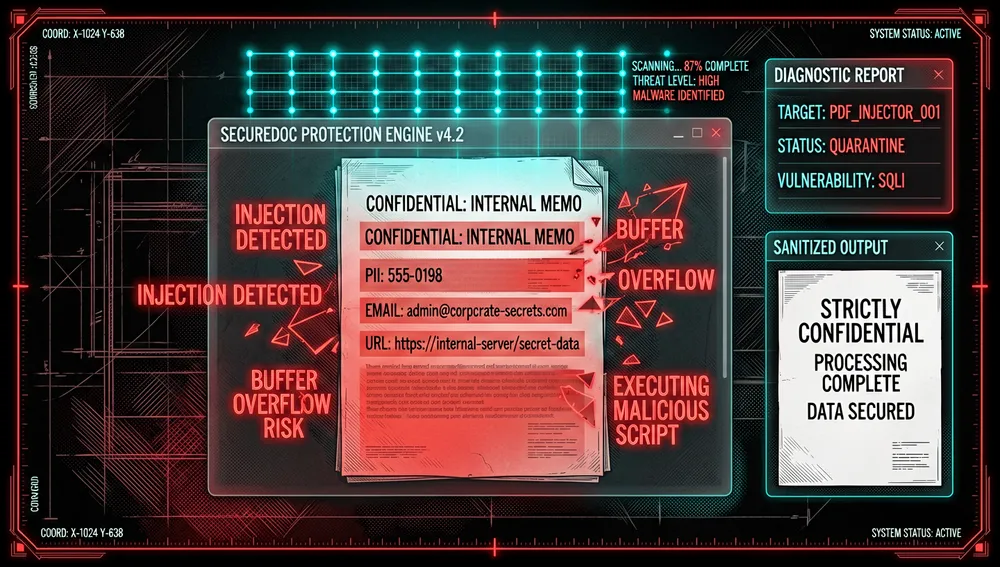
KI-Sicherheit (Anti-Injektion): filtert automatisch versteckten Text (transparente oder größenlose Schriften), Inhalt außerhalb der Seite und verdächtige unsichtbare Ebenen. Mit --sanitize werden zusätzlich sensible Daten (E-Mails, URLs, Telefonnummern) durch Markierungen ersetzt.
Schnelleinstieg
Installation und erster Start
Anforderungen: Java 11+ (mit java -version prüfen; falls fehlend, ein JDK 11+ von Adoptium installieren) und Python 3.10+.
pip install -U opendataloader-pdfimport opendataloader_pdf
# Alle Dateien in einem einzigen Aufruf bündeln: jedes convert() startet einen JVM-Prozess,
# daher ist der Aufruf in einer Schleife langsam
opendataloader_pdf.convert(
input_path=["file1.pdf", "file2.pdf", "ordner/"],
output_dir="ausgabe/",
format="markdown,json"
)Für den Hybridmodus (komplexe Tabellen, Scans, Formeln): pip install "opendataloader-pdf[hybrid]". Es gibt auch ein Node.js-SDK (npm install @opendataloader/pdf) und Java (Maven org.opendataloader:opendataloader-pdf-core).
Gängige Arbeitsabläufe
- Um zu Markdown + JSON für RAG zu extrahieren:
opendataloader_pdf.convert(input_path=[...], output_dir="ausgabe/", format="markdown,json"); das Ergebnis landet inausgabe/mit chunk-fertigem Markdown und JSON mit Begrenzungsrahmen für Zitate. - Für ein gescanntes PDF oder eine andere Sprache: das Backend mit OCR starten —
opendataloader-pdf-hybrid --port 5002 --force-ocr --ocr-lang "ko,en"— und mitopendataloader-pdf --hybrid docling-fast datei.pdfverarbeiten. - Für Formeln oder Diagrammbeschreibungen: Backend mit
--enrich-formulaoder--enrich-picture-description, und Client mit--hybrid-mode full(die Formel- und Diagrammanreicherung erfordert diesen Modus). - Um auf ein nicht etikettiertes PDF zuzugreifen (Barrierefreiheit):
opendataloader-pdf --format tagged-pdf datei.pdf, oder in Pythonformat="tagged-pdf".
Wesentliche Konfiguration
Es gibt keine zentrale Konfigurationsdatei: „Konfiguration” bedeutet die Parameter von convert()/der CLI. Die, die ein neuer Nutzer zuerst anfasst: format (markdown, json, html, pdf, text oder tagged-pdf; kombinierbar), hybrid (aktiviert den Hybridmodus), output_dir (Ausgabeordner), use_struct_tree (nutzt die nativen Strukturetiketten des PDFs) und image_output/image_format (off, embedded oder external, mit png/jpeg).
Häufige Fallstricke und Lösungen
- Jedes
convert()startet einen JVM-Prozess: wiederholte Aufrufe in einer Schleife sind langsam; alle Dateien in einem einzigenconvert()-Aufruf bündeln. --use-struct-treehat Vorrang vor--hybrid: Sind beide bei einem etikettierten PDF gesetzt, wird der Strukturbaum verwendet und das Hybrid-Backend nicht aufgerufen; um Hybrid zu nutzen,--use-struct-treeentfernen.- Die Qualität hängt von der Etikettenqualität ab: schlecht etikettierte PDFs liefern schlechtere Ergebnisse; bei spärlichen oder falschen Etiketten liefern der heuristische Modus oder
--hybrid docling-fastmeist bessere Qualität. - Formeln und Diagrammbeschreibungen erfordern
--hybrid-mode fullbeim Client; ohne diesen Modus wird die Anreicherung nicht angewendet. - Java fehlt: Antwortet
java -versionnicht, funktioniert die Python-Installation als Wrapper, aber die Engine braucht das JDK; Java 11+ installieren. - Sprachliche Einschränkung (Community): Ein HN-Nutzer (
hermitcrab) wies darauf hin, dass es als Java/Python nicht zu jenen passt, die es von C++ aus aufrufen müssen; es existiert keine dokumentierte native C++-Anbindung. - Selbst gemeldete Benchmark-Zahlen: Die „Nummer 1”-Werte stammen aus dem eigenen Testarnesch des Projekts (
opendataloader-bench); das Repository veröffentlicht ihn, damit andere ihn reproduzieren können, aber es ist keine unabhängige Bewertung.
Integrationen und Migration
- LangChain: offiziell dokumentierte Integration —
pip install -U langchain-opendataloader-pdfundOpenDataLoaderPDFLoader(file_path=[...], format="text"). - LlamaIndex: offizieller Reader der Organisation (
opendataloader-project/opendataloader-pdf-llamaindex), „schnelles, präzises, lokales PDF-Lesen”. - Lokales Hybrid-Backend: benötigt keine Cloud oder Schlüssel; der Server
opendataloader-pdf-hybridläuft auf derselben Maschine. - Migration von anderen Parsern: Das README positioniert sich als Ersatz für Werkzeuge wie
pdf2docx(ein HN-Nutzer berichtet von einer Migration, „um pdf2docx zu ersetzen … und es ist viel besser”). Gegenüber docling, marker oder pymupdf4llm hebt das README die standardmäßigen Begrenzungsrahmen und Injektionsfilter hervor, die diese Projekte nicht standardmäßig bieten. Es gibt keinen formalen Migrationsprozess: Es geht darum, den Konvertierungsaufruf aufconvert()umzustellen.
Das Ökosystem
Repositories derselben Organisation opendataloader-project: opendataloader-bench (83 Sterne, das eigene Bewertungsarnesch des Projekts, misst Lesereihenfolge NID, Tabellentreue TEDS und Überschriftenhierarchie MHS über einen Korpus von ~200 echten PDFs), langchain-opendataloader-pdf (59 Sterne, LangChain-Dokumentenlader), opendataloader-pdf-llamaindex (3 Sterne, LlamaIndex-Reader), opendataloader-pdf-examples (2 Sterne, Nutzungsbeispiele) und .github (1 Stern).
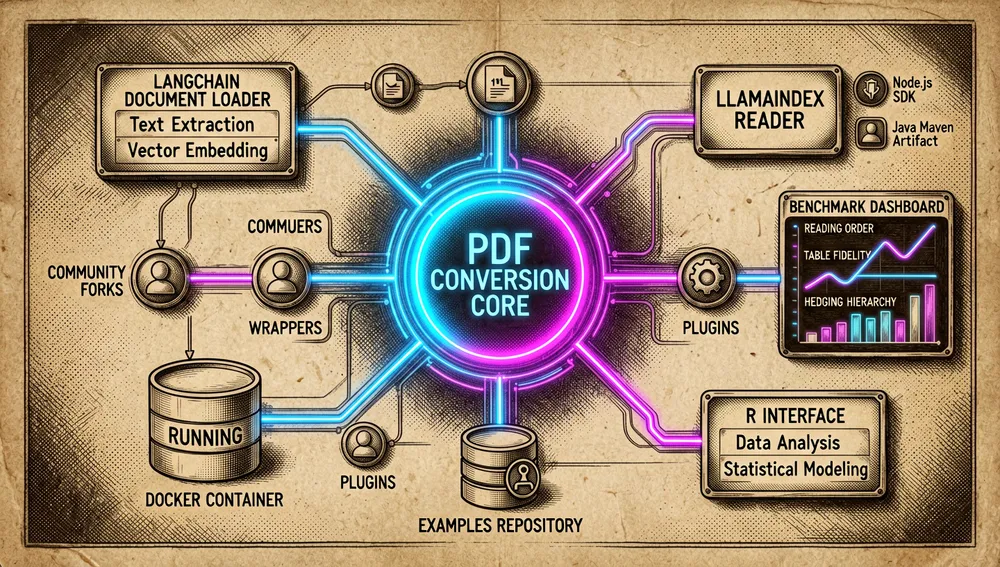
Community-Projekte und Ableger (GitHub-Repository-Suche nach „opendataloader”): NameetP/pdfmux (81 Sterne, Python, erstellt März 2026) ist ein PDF-Extraktor, der „seine eigene Ausgabe prüft und die anderer Extraktoren zertifiziert”, der 0,903 auf opendataloader-bench erzielt (2. von 8 Engines) und einen MCP-Server mit 7 Werkzeugen bereitstellt — das bemerkenswerteste verwandte Projekt, da es gegen denselben Benchmark wie OpenDataLoader antritt. muschellij2/opendataloader (0 Sterne, R, April 2026) ist eine R-Schnittstelle zu OpenDataLoader PDF. coryisakson/opendataloader_docker (4 Sterne) ist eine selbst gehostete Docker-Paketierung. dpaidev/opendataloader-pdf (2 Sterne) ist ein vollständiger Spiegel mit Historie. JamoCA/cfml-OpenDataLoader-demo (1 Stern) und longshines/pdf-parser-online (0) sind Demos/Web-Wrapper.
Die meisten anderen Ergebnisse sind Spiegel, persönliche Forks oder Repos mit null Sternen. Desambiguierungshinweis: AstunTechnology/OpenDataLoader (7 Sterne) ist ein anderes Projekt („ein Utility zum Laden von OpenData in PostGIS”); seine Namensübereinstimmung ist zufällig und steht nicht mit diesem Repository in Verbindung.
Offizieller / halboffizieller Status
Es gibt keinen Vendor-„Marketplace” im Stil von Agent-Plugins, aber das Projekt hat einen soliden halboffiziellen Status, gestützt auf Standards und Unternehmensunterstützung: Zusammenarbeit mit Standardisierungsorganisationen (das README und die Website erklären, dass die Auto-Etikettierung in Zusammenarbeit mit der PDF Association, Autorin der Well-Tagged-PDF-Spezifikation, und mit Dual Lab, Entwicklern von veraPDF, dem offenen Referenzvalidator für PDF/A und PDF/UA, entwickelt wurde); Unterstützung durch Hancom Inc. (der Hauptmitwirkende führt Hancom als sein Unternehmen; das README kündigt die Unternehmensintegration Hancom Data Loader — Dokumentenanalyse mit angepassten Modellen, OCR mit SLA und native HWP/HWPX-Unterstützung — als nächsten Schritt an, Roadmap Q2–Q3 2026); „offizielle” Drittintegrationen (es erscheint in der offiziellen Integrationsdokumentation von LangChain und pflegt einen offiziellen LlamaIndex-Reader); und ein Open-Core-Modell (der Kern — Extraktion, Layout-Analyse, Auto-Etikettierung zu Tagged PDF — ist Apache 2.0 und kostenlos; die Unternehmens-Add-ons — PDF/UA-1/2-Export und der visuelle Barrierefreiheits-Editor/Studio — sind auf Anfrage kostenpflichtig).
Das Projekt bezeichnet sich selbst als „der einzige quelloffene Parser”, der lokale deterministische Extraktion, Begrenzungsrahmen pro Element, XY-Cut++, KI-Sicherheitsfilter und Tagged-PDF-Unterstützung kombiniert, und positioniert sich als „Nummer 1 im Benchmark”. Das ist eine Projektbehauptung, gestützt auf sein eigenes Testarnesch (opendataloader-bench), keine formale Standardbezeichnung; in diesem Durchlauf wurde keine unabhängige externe Zertifizierung gefunden.
Zahlen zum Repository
Messung: 21.–22. August 2026, GitHub-API.
| Metrik | Wert |
|---|---|
| Sterne | 28.641 |
| Forks | 2.734 |
| Echte Abonnenten | 111 |
| Commits | 861 |
| Offene Issues + PRs | 77 |
| Hauptsprache | Java |
| Lizenz | Apache-2.0 (vor 2.0: MPL 2.0) |
| Erstellung | 13. Mai 2025 |
| Letzter Push | 21. August 2026 |
| Letztes Release | v2.5.2, 21. August 2026 |
Wichtigste Mitwirkende nach Beiträgen: bundolee (562), MaximPlusov (75), LonelyMidoriya (75), hyunhee-jo (58), hnc-jglee (19), dependabot[bot] (16), suji-cho (16).
Registry-Downloads: PyPI opendataloader-pdf (neueste Version 2.5.2, 69 Releases) mit 44.408 Downloads in der letzten Woche und 191.684 im letzten Monat. npm @opendataloader/pdf mit 54.297 Downloads im Zeitraum 22. Juli–22. August 2026. Die Java-Distribution erfolgt über Maven (org.opendataloader:opendataloader-pdf-core).
watchers_count spiegelt die Sternezahl, weshalb subscribers_count als tatsächliche Abonnentenzahl gemeldet wird. open_issues_count umfasst offene Änderungsanfragen, nicht nur Issues. Die Registry-Download-Zahlen sind Zustellmetriken, kein Zähler eindeutiger Nutzer oder Bereitstellungen.
Wie die Community reagierte
Die überprüfbare Konversation konzentriert sich auf einen Hacker-News-Thread; die übrigen Beiträge haben sehr wenig Traktion.
Hacker News (109 Punkte, 28 Kommentare, „OpenDataLoader-PDF: An open source tool for structured PDF parsing”, 23. September 2025) sammelte konkrete Meinungen. 4d66ba06 (Lob und Adoption): „gerade die Migration abgeschlossen, um pdf2docx in einem Projekt zu ersetzen, an dem ich gearbeitet habe, und es ist viel besser. Danke, dass ihr OpenDataLoader-PDF quelloffen gemacht habt.” emilburzo (praktisch): testete es mit Kontoauszügen, „PDFs, die überraschend schwierig sind… die JSON-Extraktion sieht ziemlich gut aus und scheint in einem einzigen Durchgang etwas Nutzbares zu produzieren.” fedeb95 (Nutzung außerhalb von KI): „Sehr cool. Werde es wahrscheinlich nutzen, aber nicht für KI. Ich habe viele PDFs, für die kein Epub existiert.” agsqwe fragte, wie es sich mit docling vergleicht. hermitcrab (technischer Einwand): „war begeistert, bis ich las, dass es Java/Python ist. Suche eine Bibliothek, die PDF-Tabellen extrahiert und aus einem C++-Programm aufgerufen werden kann.” trevor-e (tiefere Kritik) argumentiert, dass „wir vielleicht ein neues KI-freundliches Dateiformat brauchen, statt weiter die komplizierte PDF-Spezifikation zu flicken.” constantinum erwähnte Unstract (Zipstack/unstract) als offene Alternative für strukturierte Extraktion + ETL.
Weitere Beiträge mit geringer Traktion stellen keine breite Rezension dar: „Show HN: OpenDataLoader – Safe, Open, High-Performance PDF Loader for AI” (4 Punkte), einer über v2.0 (1 Punkt) und „LLM Is Not a PDF Parser: Use OpenDataLoader First” (2 Punkte). Außerhalb von HN wurde in diesem Durchlauf keine weitere überprüfbare Community-Evidenz gefunden.
OpenDataLoader PDF im Vergleich zu anderen Projekten
Die Tabellenwerte stammen aus dem eigenen Testarnesch des Projekts, opendataloader-bench (Lesereihenfolge NID, Tabellen TEDS, Überschriften MHS, über ~200 PDFs); sie sind vom Projekt selbst gemeldet, keine unabhängige Bewertung. Die Geschwindigkeit ist in Sekunden/Seite angegeben (niedriger ist besser).
| Projekt | Gesamtpunktzahl (eigener Bench) | Geschwindigkeit (s/Seite) | Überprüfbarer Unterschied |
|---|---|---|---|
| opendataloader [hybrid] | 0,907 | 0,463 | Lokale Hybrid-Engine; Begrenzungsrahmen pro Element; Injektionsfilter; Apache 2.0. |
| nutrient | 0,885 | 0,008 | Kommerzielle Engine; die schnellste im Testarnesch. |
| docling | 0,882 | 0,762 | MIT; laut README fehlen standardmäßig Begrenzungsrahmen und Injektionsfilter. |
| marker | 0,861 | 53,932 | GPL-3.0; das README beschreibt es als deutlich langsamer (≈54 s/Seite). |
| unstructured [hi_res] | 0,841 | 3,008 | Apache-2.0; auch das Standard-unstructured existiert (0,686). |
| edgeparse | 0,837 | 0,036 | Apache-2.0. |
| opendataloader (lokaler Modus) | 0,831 | 0,015 | Die KI-freie Variante, sehr schnell; schlechter bei Tabellen (0,489). |
| mineru | 0,831 | 5,962 | AGPL-3.0 (opendatalab/MinerU). |
| pymupdf4llm | 0,732 | 0,091 | AGPL-3.0; schnell, aber schlechter bei Tabellen (0,401) und Überschriften (0,412). |
| markitdown | 0,589 | 0,114 | MIT. |
| liteparse | 0,576 | 1,061 | Apache-2.0. |
In der Praxis ist das vom Projekt selbst behauptete Unterscheidungsmerkmal die Kombination aus lokaler deterministischer Extraktion + Begrenzungsrahmen pro Element + Auto-Etikettierung zu Tagged PDF; eine kommerzielle Engine (nutrient) oder ein schneller Parser (pymupdf4llm) kann bei der Geschwindigkeit gewinnen, und ein GPU-basierter Parser (marker, docling) ist bei der Qualität konkurrenzfähig, aber laut dem eigenen Testarnesch des Projekts kombiniert keiner alle diese Fähigkeiten im lokalen Modus.
Wie man beiträgt
CONTRIBUTING.md dokumentiert einen expliziten Prozess: das Repository forken und den Fork klonen; einen Arbeits-Branch erstellen (git checkout -b mein-feature); das Projekt bauen (Voraussetzungen: Java 11+, Maven, Python 3.10+, uv, Node.js 24 aktives LTS und pnpm über corepack enable pnpm; die CI baut gegen Node 24 und pnpm 11.21.0, und Node muss ≥22.13 sein); für Fragen ein mit Question markiertes Issue öffnen; für Fehler die Bug-Report-Vorlage nutzen; für Vorschläge die Feature-Request-Vorlage.
Anwendungsfälle und wem dieses Repository helfen kann
- Teams, die RAG-/LLM-Pipelines über PDF-Dokumenten aufbauen: Die Extraktion zu Markdown (Lesereihenfolge, Tabellen, Überschriften) und zu JSON mit Begrenzungsrahmen ermöglicht semantisches Chunking und „Klick-zur-Quelle”-Zitate. Der lokale Hybridmodus deckt komplexe Tabellen und Scans ab, ohne Daten an die Cloud zu senden — relevant für Branchen mit sensiblen Daten (Recht, Gesundheit, Finanzen).
- Organisationen, die Barrierefreiheitsvorschriften einhalten müssen (EU-EAA, US-ADA/Section 508, Koreas Digital Inclusion Act): Die Pipeline Prüfen → Auto-Etikettieren → Tagged PDF (kostenlos, Apache 2.0) ersetzt einen Teil der manuellen Nachbesserung (die das README mit 50–200 USD pro Dokument beziffert); die Validierung mit veraPDF macht es für Compliance-Teams geeignet.
- Verarbeitung gescannter oder mehrsprachiger PDFs: Hybrides OCR (80+ Sprachen) dient jenen, die digitalisierte Dateien oder Dokumente auf Koreanisch/Japanisch/Chinesisch/Arabisch konvertieren; Hancoms koreanischer Ursprung erklärt die angekündigte native HWP-Unterstützung.
- Wissenschaftler und Techniker, die Formeln und Diagramme extrahieren: Die LaTeX-Formelextraktion und die Diagramm-/Bildbeschreibung decken wissenschaftliche Artikel und technische Dokumente ab, bei denen die Qualität von Tabellen und Gleichungen wichtig ist.
- Entwickler, die in bestehende Frameworks integrieren: Die offiziellen LangChain- und LlamaIndex-Lader erlauben es, OpenDataLoader als Dokumentenquelle in bereits aufgebaute Pipelines einzufügen.
- Wer NICHT die Zielgruppe ist: wer eine native C++-Anbindung benötigt, wer einen vollständig unabhängigen Validierungsbenchmark verlangt, oder wer PDF/UA ohne das kostenpflichtige Add-on benötigt.
Ressourcen
- Repository: https://github.com/opendataloader-project/opendataloader-pdf
- Offizielle Website und Dokumentation: https://opendataloader.org
- Offizielles Benchmark-Arnesch: https://github.com/opendataloader-project/opendataloader-bench
- Offizielle LangChain-Integration: https://docs.langchain.com/oss/python/integrations/document_loaders/opendataloader_pdf
- Offizieller LlamaIndex-Reader: https://github.com/opendataloader-project/opendataloader-pdf-llamaindex
- Paket-Registries: PyPI https://pypi.org/project/opendataloader-pdf/ · npm https://www.npmjs.com/package/@opendataloader/pdf
Hinweis: Dieser Bericht kombiniert das README, CONTRIBUTING.md, die Dokumentation und das Benchmark-Arnesch des Repositorys (main-Branch), die GitHub-API, PyPI/npm und Hacker-News-Ergebnisse, konsultiert am 21.–22. August 2026. Benchmark-Werte sind vom Projekt über opendataloader-bench selbst gemeldet. Die Zahlen ändern sich mit der Zeit.
Kommentare